La corrélation logs traces Elastic APM consiste à écrire dans chaque ligne de log l’identifiant de la trace en cours, le champ trace.id. Pendant un incident, vous passez alors d’une transaction lente à ses logs, et d’une erreur dans un log à la trace complète, sans fouiller par horodatage. Ce tutoriel suit trois étapes : activer la corrélation dans l’agent, injecter les identifiants, ingérer les logs.
Le pas-à-pas couvre deux cas, Node.js avec Pino et .NET avec Serilog. Les informations viennent de la documentation Elastic, consultée le 30 octobre 2026 ; les noms de paquets et de champs sont à revérifier pour votre version de la pile.
Pour une équipe SRE, l’enjeu est le temps de résolution (MTTR) : chaque saut manuel entre deux outils allonge l’incident. Cet article vaut pour Elastic, pas pour Dynatrace Managed ni Dynatrace SaaS ; la dernière section dit où se situe Dynatrace.
En bref
- Un log est corrélé quand il contient
trace.idet soittransaction.id, soitspan.id. - L’agent APM fournit les identifiants ; un formateur ECS (Elastic Common Schema) les écrit dans le log.
- Les logs doivent arriver dans le même Elasticsearch que les données APM.
Corrélation logs traces Elastic APM : le principe
Selon la documentation Elastic sur les logs d’application, la corrélation permet de voir le contexte d’un log, tous les logs d’une trace, et de naviguer entre logs et traces. Un log ECS en JSON porte des champs comme log.level, service.name, trace.id et transaction.id.
Distinguez bien les signaux. Une trace regroupe des spans, c’est-à-dire des opérations chronométrées. Un log est un événement textuel. Rien ne les relie, sauf l’identifiant que vous ajoutez au log. D’où les trois étapes qui suivent.
La documentation indique aussi trois façons d’envoyer les logs. Filebeat ou Elastic Agent collecte des fichiers texte, quel que soit le langage. Un plugin ECS écrit du JSON directement exploitable, au prix d’un changement de configuration du logger. La reformatage par l’agent APM n’existe que pour Ruby, Python et Java, et l’envoi direct par l’agent seulement pour Java : ces deux options ne concernent donc pas nos exemples.
Étape 1 : activer la corrélation dans l’agent
Pour Node.js, l’agent elastic-apm-node expose apm.currentTraceIds. D’après la documentation de l’API, cette propriété renvoie un objet avec trace.id et soit transaction.id, soit span.id selon l’élément actif ; hors transaction, l’objet est vide. Elle est disponible depuis la version 2.17 de l’agent.
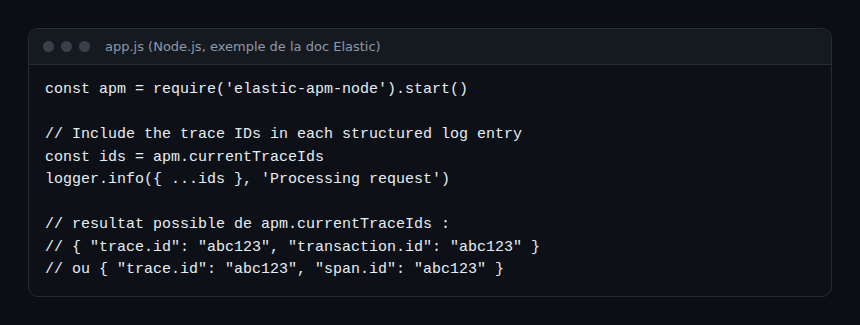
L’agent doit démarrer avant le reste de l’application. Sans transaction active, pas d’identifiant : un log écrit au démarrage ou dans une tâche hors requête ne sera pas corrélé.
Pour .NET, la documentation de l’agent liste deux frameworks de logs pris en charge : Serilog et NLog. Pour un autre logger, elle renvoie vers un guide d’injection manuelle des identifiants.
Étape 2 : injecter les identifiants dans chaque log
Node.js avec Pino
Avec un paquet de format ECS pour Pino, Winston ou Morgan, la documentation précise que l’agent appelle l’API pour vous et que les identifiants sont injectés automatiquement. Pour Pino, le paquet est @elastic/ecs-pino-format. Selon sa page, il prend en charge Pino 6, 7 et 8, et ajoute trace.id, transaction.id et span.id quand l’agent APM Node.js est actif. L’option apmIntegration: false désactive cet ajout.
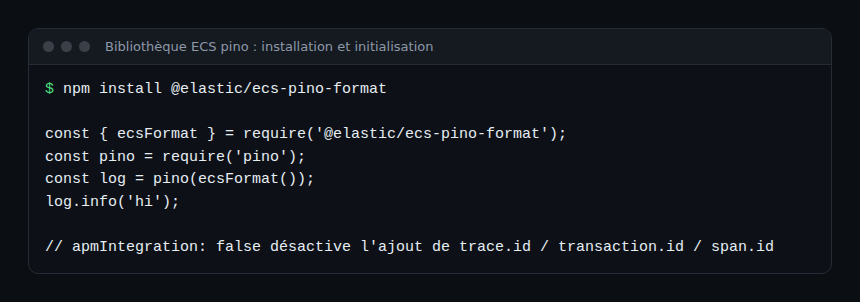
const apm = require('elastic-apm-node').start();   // en premier
const { ecsFormat } = require('@elastic/ecs-pino-format');
const pino = require('pino');

const log = pino(ecsFormat());
log.info('commande reçue');
Limite signalée par la même page : les champs passés à child() ne sont pas convertis, donc un objet req placé dans un logger enfant ne reçoit pas les champs HTTP ECS. Sans paquet ECS, ajoutez vous-même ...apm.currentTraceIds à chaque entrée, comme dans la capture de l’étape 1.
.NET avec Serilog
Le dépôt elastic/ecs-dotnet décrit deux paquets. Elastic.Apm.SerilogEnricher ajoute les identifiants de trace et de transaction aux événements Serilog créés pendant une transaction. Elastic.CommonSchema.Serilog fournit EcsTextFormatter, qui écrit les événements en JSON ECS ; combinés, les identifiants apparaissent dans la sortie ECS.
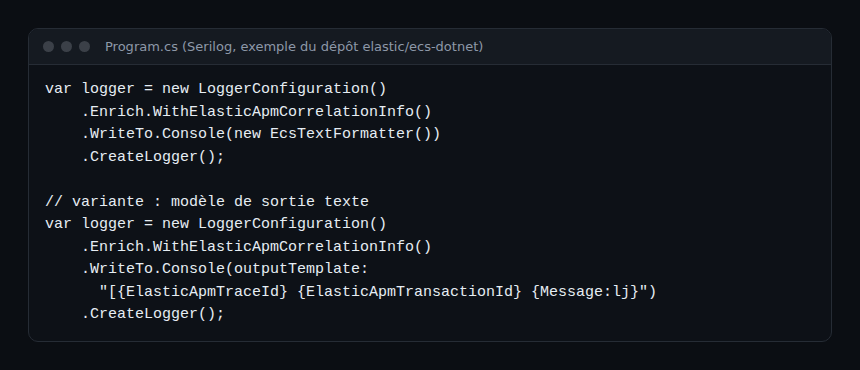
Pour NLog, le paquet Elastic.Apm.NLog fournit les marqueurs ${ElasticApmTraceId} et ${ElasticApmTransactionId}, et EcsLayout les place dans la sortie ECS. Hors transaction, ces marqueurs restent vides.
Étape 3 : ingérer les logs dans Elasticsearch
Les logs JSON ECS sont écrits sur la sortie standard ou dans un fichier, puis collectés par Filebeat ou Elastic Agent. La page Node.js demande d’envoyer les logs vers la même instance Elasticsearch que les données APM. La page .NET confirme que Filebeat permet d’envoyer les logs, de corréler traces et logs, et de passer de l’APM à l’exploration des logs.
Le détail de l’installation de Filebeat (fichiers, Kubernetes, Docker) dépend de votre environnement et figure dans la documentation de la bibliothèque ECS ; la page Pino précise que Filebeat n’est pas disponible sur Elastic Cloud Serverless. Cet article ne le détaille pas, faute de l’avoir vérifié pour chaque cas.
Comment vérifier que ça fonctionne
- Générez une requête sur le service instrumenté, puis lisez la ligne de log brute : elle doit contenir
trace.idettransaction.id. - Dans Kibana, ouvrez le service dans Observability, puis son onglet Logs. D’après la documentation, vous pouvez sauter d’un log corrélé vers sa trace, et le filtre d’environnement, la requête et la période sont conservés.
- Dans Log Events, cherchez un
trace.idissu d’une transaction en échec, puis choisissez Open logs in Discover pour élargir la requête.
L’onglet Logs interroge les index définis dans le paramètre avancé observability:logSources ; des index personnalisés demandent une configuration supplémentaire.
Si la ligne brute n’a pas d’identifiant, remontez : agent démarré trop tard, aucun enrichisseur, ou hors transaction. Si elle en a mais que Kibana ne montre rien, vérifiez l’ingestion et les index.
Et OpenTelemetry, et Dynatrace ?
La documentation Elastic liste aussi des guides de corrélation pour les SDK OpenTelemetry d’Elastic (Java, .NET, Node.js, PHP, Python) ; nous ne les avons pas ouverts un par un. Le principe reste le même : un log porte l’identifiant de trace et de span du contexte actif. Pour comprendre le rôle de chaque signal, lisez observabilité et monitoring ; pour acheminer logs et traces avec un Collector, voir le Collector sur Kubernetes.
Pour situer Elastic face à un autre éditeur, consultez le comparatif Dynatrace et Datadog, et pour limiter le volume de traces conservées, le tail sampling avec OpenTelemetry. Nous n’affirmons aucune intégration entre Elastic APM et Dynatrace.
Bonnes pratiques
- Démarrez l’agent avant tout autre module, sinon des requêtes échappent à l’instrumentation.
- Journalisez en JSON ECS plutôt qu’en texte à parser : le format est fixé à l’écriture.
- Ne mettez jamais de donnée personnelle ou de jeton dans les messages de log.
- Testez la corrélation dans votre pipeline de livraison : un log sans
trace.idsur un chemin critique est un défaut à corriger.
Questions fréquentes
Quels champs faut-il dans un log pour le corréler à une trace ?
Selon la documentation Elastic pour Node.js, un trace.id et soit un transaction.id, soit un span.id.
Pourquoi certains logs n’ont-ils pas de trace.id ?
L’identifiant n’existe que pendant une transaction ou un span actif ; hors de ce contexte, apm.currentTraceIds renvoie un objet vide. Un log écrit au démarrage ou par une tâche de fond n’a donc pas d’identifiant.
Faut-il Filebeat pour corréler ?
Il faut un moyen d’ingérer les logs dans le même Elasticsearch que l’APM. La documentation cite Filebeat et Elastic Agent ; l’envoi direct par l’agent n’est documenté que pour Java.
Conclusion
Trois gestes suffisent : un agent actif, un formateur qui écrit trace.id dans chaque log, et une ingestion vers le bon cluster. Le gain se mesure à la première panne : une trace lente mène à ses logs en un clic.
Sources
- Log correlation, agent Node.js, documentation Elastic
- Agent API Node.js, documentation Elastic
- Stream application logs, documentation Elastic
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les valeurs viennent de la documentation Elastic, à vérifier pour votre version.