La ingestión APM Datadog decide qué trazas entran en la plataforma; la retención decide cuáles siguen siendo consultables. Son dos ajustes distintos, y confundirlos sale caro: crees reducir la factura filtrando en un punto cuando el volumen se decide en otro. Este artículo separa las etapas del pipeline de trazas, según la documentación oficial de Datadog.
Está dirigido a equipos de SRE y de plataforma que ya usan Datadog APM y quieren conservar las trazas útiles (errores, latencia alta) sin pagar por todo lo demás. Los valores citados proceden de las páginas de la documentación de Datadog consultadas el 30 de octubre de 2026; pueden cambiar, así que comprueba la página antes de fijarlos en un runbook.
En resumen
- Ingestión: los spans que los SDK y el Agent envían a Datadog. Se ajusta con los controles de ingestión y el muestreo.
- Indexación: entre los spans ingeridos, los filtros de retención eligen los que se almacenan y se pueden buscar, 15 días en el caso de los filtros personalizados.
- Métricas: se calculan a partir de los spans ingeridos, estén indexados o no.
- Un filtro de retención no reduce la ingestión: la documentación lo dice de forma explícita.
Ingestión APM Datadog: tres etapas que no hay que confundir
La página Trace pipeline describe la cadena completa: ingestión, pipelines de procesamiento, indexación y retención, métricas generadas y seguimiento del uso. Para un SRE bastan tres preguntas para orientarse.
- ¿Qué se envía? Es la ingestión. El SDK y el Agent deciden, traza por traza, si conservar o descartar.
- ¿Qué se almacena y se puede consultar? Es la indexación, controlada por los filtros de retención.
- ¿Qué se agrega en curvas? Son las métricas, calculadas sobre lo que se ha ingerido.
Un span descartado en la ingestión ya no existe para las dos etapas siguientes. Según la documentación de las métricas basadas en spans, un span descartado por el muestreo no puede producir una métrica. En cambio, un span ingerido pero no indexado sí alimenta esas métricas. Para la parte RED, consulta nuestro artículo sobre las métricas de traza de Datadog.
Los controles de ingestión: muestreo en la cabecera de la traza
La página Ingestion Control muestra la ingestión del mes en curso, la proyección a fin de mes respecto a tu cuota y una tabla por servicio (trazas por segundo y bytes por segundo en la última hora). Un gráfico por «motivo de ingestión» vincula cada volumen con un mecanismo concreto.
Por defecto, el muestreo es head-based: la decisión se toma sobre el span raíz y vale para toda la traza. Según la documentación, si no hay ninguna regla definida para un servicio, el Agent apunta a 10 trazas por segundo y calcula él mismo las tasas. Puedes cambiar este objetivo en Datadog o con DD_APM_TARGET_TPS (clave target_traces_per_second en datadog.yaml).
Dos muestreadores completan este mecanismo para las trazas que el muestreo en cabecera no ha retenido: el muestreador de errores (10 trazas de error por segundo y por Agent por defecto, DD_APM_ERROR_TPS) y el muestreador de trazas raras (desactivado por defecto, DD_APM_ENABLE_RARE_SAMPLER, Agent 7.41 o posterior).
Escribir reglas en el SDK
Las reglas se definen en la aplicación con DD_TRACE_SAMPLING_RULES, un array JSON donde sample_rate va de 0 a 1. El ejemplo siguiente es el de la documentación: se conservan todas las trazas de GET /checkout y el 20 % de las demás trazas del servicio.
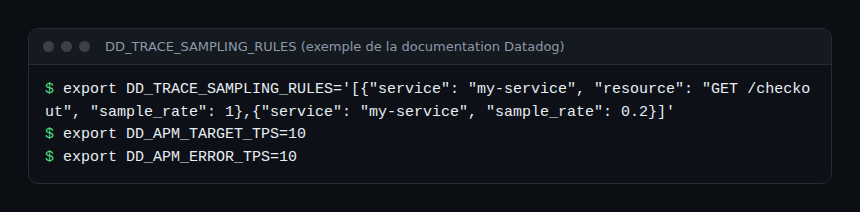
Precedencia: según la documentación, los ajustes del tracer prevalecen sobre los del Agent, y la configuración remota prevalece sobre la local. Cuando una tasa no se comporta como esperas, comprueba primero quién tiene la última palabra: el Agent, el tracer o la configuración remota.
Leer los motivos de ingestión
Cada traza ingerida lleva un motivo. La página Ingestion Mechanisms enumera varios: auto, rule y manual corresponden al muestreo en cabecera; error y rare proceden de los muestreadores del Agent; single_span conserva spans aislados; otel señala datos de OpenTelemetry.
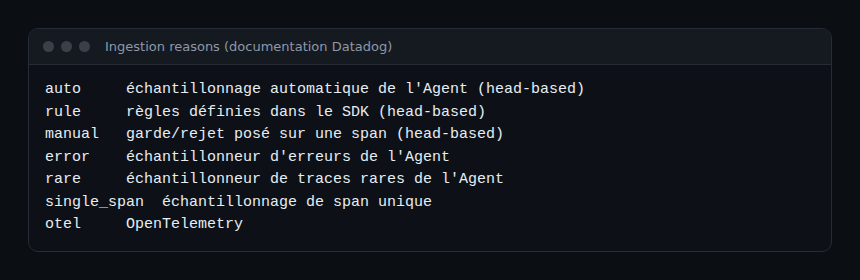
El muestreo de span único (single_span) conserva spans que el muestreo en cabecera ha descartado, sin guardar la traza entera. No puede eliminar spans ya retenidos. Es útil para contar una llamada concreta sin pagar por las trazas completas.
Filtros de retención y spans indexados
Una vez ingerido el span, la página Trace retention explica qué lo hace consultable. Conviven dos familias de filtros.
El filtro de retención inteligente
Está siempre activo y funciona en paralelo a tus filtros. Combina dos mecanismos:
- Diversity sampling: como máximo cada 15 minutos, al menos una traza por combinación de entorno, servicio, operación y recurso; las trazas en los percentiles p75, p90 y p95 de latencia; una selección variada de errores (400, 500). Está orientado a errores y latencias altas, por lo que no es una muestra proporcional del tráfico.
- 1 % flat sampling: aproximadamente el 1 % de los spans ingeridos, decidido sobre el
trace_idpara que una traza siga completa, y las trazas vinculadas al 1 % de las sesiones RUM ingeridas.
Según la documentación, los spans que indexa no cuentan en el uso de spans indexados y, por tanto, no afectan a la factura. La página indica una conservación de 30 días. El «1 %» no es, pues, una tasa de conservación global, sino una parte uniforme complementada por la diversidad: un servicio con poco tráfico puede faltar en intervalos cortos.
Los filtros personalizados
Conservan 15 días. Cada filtro tiene una consulta de retención (cualquier etiqueta o atributo de span, como env:prod o @duration:>2s), una tasa de spans de 0 a 100 % y, de forma opcional, una tasa de trazas que indexa la traza entera, incluidos los spans que no cumplen la consulta.
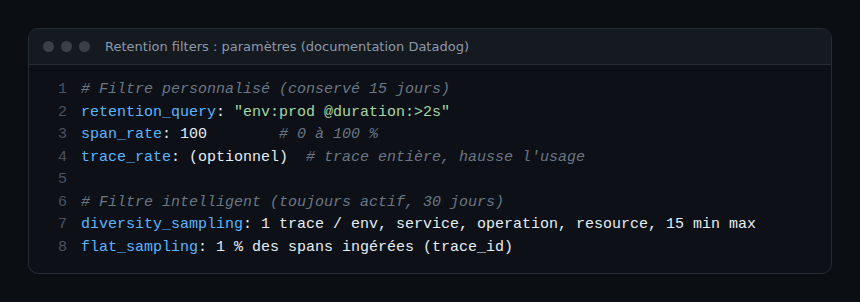
La tasa de spans se evalúa primero; la tasa de trazas solo se aplica a las trazas que ha seleccionado. La documentación precisa que puede aumentar de forma notable el uso de spans indexados. Los filtros se evalúan en el orden de la lista: un span retenido por un filtro no se reconsidera en los siguientes.
Vigilar costes y uso
La métrica datadog.estimated_usage.apm.indexed_spans sigue los spans indexados por los filtros personalizados y por defecto. Los dashboards APM Estimated Usage e Ingestion Reasons muestran los volúmenes ingeridos e indexados. Aquí no se reproducen las tarifas: consulta la página oficial de precios de Datadog para conocer los importes vigentes.
Esta medida es un buen indicador de salud de la plataforma de observabilidad: síguela como cualquier SLI interno, con una alerta antes de que se agote la cuota mensual. Una alerta que combine varias condiciones se construye con un composite monitor de Datadog.
Pasos para acotar tu pipeline de trazas
- Abre la página Ingestion Control e identifica los servicios cuyo volumen domina, así como el motivo de ingestión principal.
- Decide, servicio por servicio, qué debe conservarse al 100 % (rutas críticas, pagos) y qué puede bajar, con reglas
DD_TRACE_SAMPLING_RULES. - Crea filtros de retención dirigidos (
env:prod, duración alta, estado de error) en lugar de una tasa global. - Mantén el filtro inteligente como red de seguridad, sin contarlo como una muestra representativa.
- Crea métricas a partir de los spans ingeridos para los SLO a largo plazo, en lugar de indexar trazas para contar.
- Tras cada cambio, vuelve a comprobar los motivos de ingestión y la métrica de uso indexado.
Cómo comprobar que funciona
Después de cambiar una regla, mira el gráfico por motivo de ingestión de la página Ingestion Control: el volumen esperado debe desplazarse hacia el motivo rule. En el Trace Explorer, busca un caso conocido (un error reciente en el servicio modificado) y confirma que su traza está indexada. Si la traza no aparece, la decisión se tomó en la ingestión, no en la retención.
Relación con OpenTelemetry y Dynatrace
Los datos de OpenTelemetry enviados a Datadog llevan el motivo otel de la lista anterior. Para entender la diferencia entre muestreo en cabecera y en cola en OpenTelemetry, consulta nuestro artículo sobre el tail sampling de OpenTelemetry: la lógica de decisión es distinta, ya que espera al final de la traza. Para una visión de conjunto de ambas plataformas, consulta la comparativa de Dynatrace y Datadog. Este texto describe Datadog; no pretende ninguna equivalencia de funciones con Dynatrace.
Buenas prácticas
- Separa mentalmente ingestión, indexación y métricas antes de tocar cualquier ajuste.
- Conserva el 100 % de las trazas de error y de latencia alta en los recorridos críticos.
- Evita tasas de trazas altas en los filtros personalizados sin medir el impacto en el uso.
- Documenta las reglas en el repositorio de la aplicación, no solo en la interfaz.
- Revisa las reglas con cada cambio de tráfico o de cuota.
Preguntas frecuentes
¿Cuál es la diferencia entre ingestión e indexación en Datadog APM?
La ingestión es el envío de spans a Datadog, regulado por el muestreo. La indexación es el almacenamiento consultable de una parte de los spans ingeridos, controlado por los filtros de retención. Un filtro de retención no reduce la ingestión.
¿El filtro inteligente conserva realmente el 1 % de las trazas?
No, no solo eso. Combina una muestra de diversidad, orientada a errores y latencias, y una muestra uniforme de aproximadamente el 1 % de los spans ingeridos. No es una muestra proporcional del tráfico.
¿Se pueden conservar métricas sin indexar las trazas?
Sí. Las métricas basadas en spans se calculan sobre los spans ingeridos, indexados o no. Se facturan como métricas personalizadas, así que evita los atributos de alta cardinalidad.
Conclusión
Para controlar Datadog APM, primero se ajusta la ingestión, luego se indexa con filtros dirigidos y se recurre a las métricas para el largo plazo. Comprueba cada valor en la documentación de tu sitio de Datadog, porque los valores por defecto pueden cambiar.
- Trace pipeline, documentación de Datadog
- Trace retention, documentación de Datadog
- Ingestion Control, documentación de Datadog
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Datadog Inc. Los nombres de productos citados pertenecen a sus respectivos propietarios; los valores proceden de la documentación de Datadog consultada el 30 de octubre de 2026 y los ejemplos son los de esa documentación. Comprueba siempre los valores en la documentación oficial correspondiente a tu versión.