KEDA autoscaling Kubernetes : le dépôt kedacore/keda se décrit comme un composant d’autoscaling piloté par les événements, qui fait varier le nombre de réplicas de tout conteneur d’un cluster Kubernetes, y compris de et vers zéro. La page du dépôt affiche environ 10 700 étoiles et environ 1 600 forks à la fin d’octobre 2026 (valeurs arrondies par GitHub), sous licence Apache 2.0.
Pour un SRE, l’intérêt est simple : au lieu de suivre le CPU, on suit ce qui mesure vraiment la charge, comme une file de messages ou une requête Prometheus. L’inconvénient est tout aussi net : un composant de plus décide du nombre de pods, donc il faut l’observer. Cet article suit le README et la documentation officielle de keda.sh (version 2.21), sans prétendre avoir installé KEDA.
Précision d’honnêteté : span.observer n’a pas testé KEDA. Les commandes viennent de la documentation, et les captures viennent de keda.sh ou reproduisent à l’identique des extraits de sa documentation.
KEDA autoscaling Kubernetes : ce que dit le dépôt
- Projet : le README indique que KEDA est un projet gradué de la Cloud Native Computing Foundation (CNCF).
- Licence : Apache 2.0, vérifiée dans le fichier LICENSE du dépôt le 26 octobre 2026.
- Principe : d’après le README, KEDA permet un autoscaling fin, y compris vers et depuis zéro, pour des charges Kubernetes pilotées par des événements. On le configure avec une ressource personnalisée (CRD).
- Compatibilité : la documentation indique que KEDA 2.21 est testé avec Kubernetes 1.34 à 1.36.
- Chiffres : étoiles et forks lus sur la page du dépôt, arrondis. La page ne présentait pas de version publiée lisible : je ne cite donc pas de numéro de release.
Visite du schéma d’architecture
Le schéma de la page « Concepts » de keda.sh montre les trois composants et leur rôle. Il vient du site du projet, dont le dépôt de documentation est sous licence Apache 2.0.
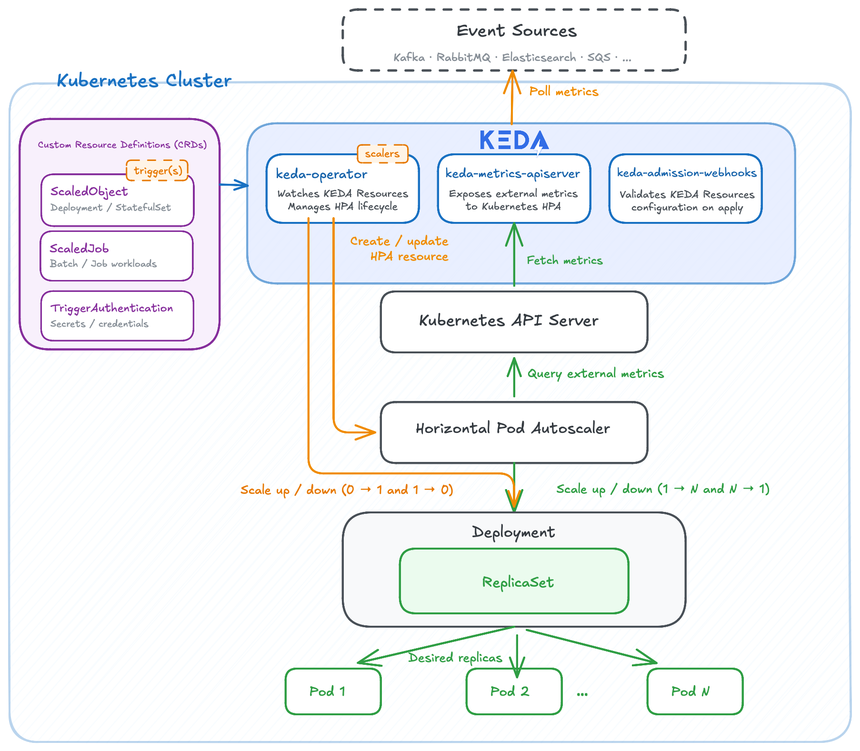
La documentation décrit trois composants :
keda-operatorsurveille les ressources KEDA (ScaledObject, ScaledJob, TriggerAuthentication), gère le cycle de vie du HPA et fait passer la charge de 0 à 1 réplica et inversement ;keda-metrics-apiserverexpose les métriques externes à l’API Server Kubernetes, que le HPA interroge ;keda-admission-webhooksvalide les ressources à l’application, par exemple pour refuser deux ScaledObject sur le même Deployment.
KEDA étend donc le Horizontal Pod Autoscaler (HPA) plutôt que de le remplacer. Les transitions de 1 à N passent par le HPA. Point à retenir : la documentation précise que le passage à zéro n’est pas pris en charge avec les déclencheurs CPU ou mémoire.
Installation pas à pas
Étape 1 — Prérequis
Il faut un cluster Kubernetes dans la plage testée, Helm installé et le droit d’installer des charts. Le README cite aussi Operator Hub et des fichiers YAML ; la suite suit la voie Helm de la documentation.
Étape 2 — Installer avec Helm
helm repo add kedacore https://kedacore.github.io/charts
helm repo update
helm install keda kedacore/keda --namespace keda --create-namespace
Étape 3 — Vérifier les pods
kubectl get pods -n kedaVous devriez y voir les pods des composants décrits plus haut. La désinstallation se fait par helm uninstall keda --namespace keda ; la page de déploiement imprime l’option avec un tiret demi-cadratin, à remplacer par deux tirets simples.
Étape 4 — Déclarer un ScaledObject
Un ScaledObject relie une charge à un ou plusieurs déclencheurs. L’exemple ci-dessous est celui de la page du scaler Prometheus de la documentation.
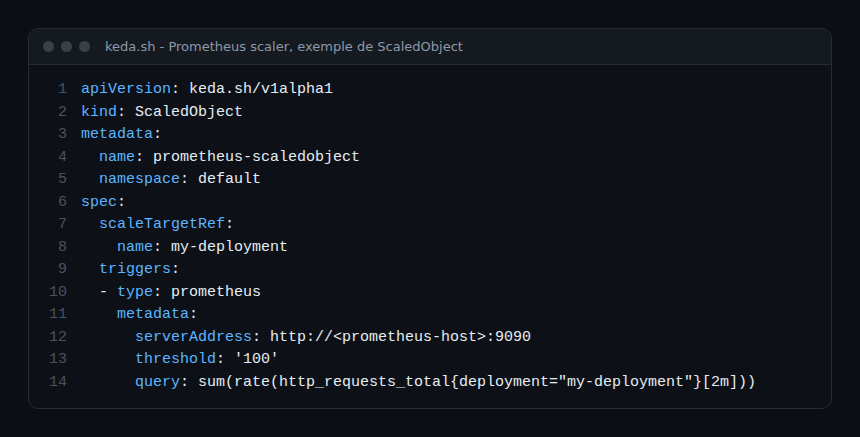
La documentation de la spécification donne ces valeurs par défaut : pollingInterval 30 secondes, cooldownPeriod 300 secondes, minReplicaCount 0 et maxReplicaCount 100. Le paramètre activationThreshold du scaler Prometheus vaut 0 par défaut. Le champ fallback exige failureThreshold et replicas : il fixe un nombre de réplicas si le scaler échoue de façon répétée.
Observer KEDA : métriques Prometheus
Pour savoir si l’autoscaling se comporte comme prévu, la documentation indique que l’opérateur, les webhooks d’admission et le serveur de métriques exposent des métriques Prometheus sur le port 8080, au chemin /metrics. Pour relier ces métriques à votre pile, voir Prometheus et Dynatrace sur Kubernetes.
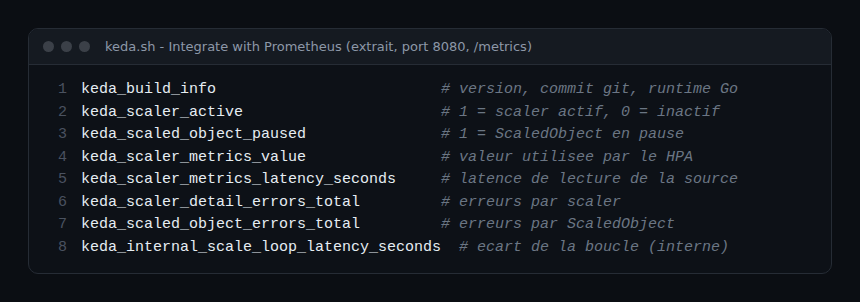
La capture reprend les noms de la documentation ; les commentaires sont de span.observer. Quelques lectures utiles :
keda_scaler_activevaut 1 quand le scaler est actif et 0 sinon : c’est le signal « KEDA voit de la charge ».keda_scaler_metrics_valuedonne la valeur que le HPA utilise pour calculer sa cible.keda_scaler_metrics_latency_secondsmesure le temps de lecture de la source ; une dérive allonge la boucle de mise à l’échelle.keda_scaler_detail_errors_total,keda_scaled_object_errors_totaletkeda_scaled_job_errors_totalcomptent les erreurs par scaler, ScaledObject et ScaledJob.keda_scaler_empty_upstream_responses_totalcompte les réponses vides de la source, par exemple une requête Prometheus sans résultat.keda_scaled_object_pausedvaut 1 si un ScaledObject est en pause.
La documentation note qu’un opérateur sans aucun scaler n’expose que keda_build_info ; les autres apparaissent avec vos scalers. Les labels à forte cardinalité (namespace, scaled_resource, trigger_name, metric_name) s’activent avec --enable-high-cardinality-metrics-labels=true sur le Deployment keda-operator : mesurez d’abord le coût de stockage.
OpenTelemetry et événements Kubernetes
Côté OpenTelemetry, la documentation décrit une intégration expérimentale, disponible depuis la version 2.12. Ce sont des métriques poussées vers un Collector, pas des traces. On active l’export avec l’argument --enable-opentelemetry-metrics=true de l’opérateur, et on désigne le Collector par la variable d’environnement OTEL_EXPORTER_OTLP_ENDPOINT (exemple de la page : http://opentelemetry-collector.default.svc.cluster.local:4318). OTEL_EXPORTER_OTLP_PROTOCOL choisit HTTP ou gRPC. Les noms changent de forme, par exemple keda.scaler.active. Voir aussi le Collector OpenTelemetry sur Kubernetes et OpenTelemetry et Prometheus.
KEDA émet aussi des événements Kubernetes, listés dans sa référence. Les plus utiles en exploitation :
KEDAScaleTargetActivatedetKEDAScaleTargetDeactivated(Normal) : la cible passe à 1 ou à 0 ;KEDAScaleTargetActivationFailedetKEDAScaleTargetDeactivationFailed(Warning) : le passage a échoué ;KEDAScalerFailed(Warning) : un scaler ne parvient pas à créer ou vérifier sa source ;ScaledObjectCheckFailed(Warning) : la validation d’un ScaledObject échoue ;ScaledObjectFallbackActivated: le repli est actif ;ScaledObjectPausedetScaledObjectUnpaused: mise en pause ou reprise.
Pour inspecter ce que le HPA reçoit, la documentation du serveur de métriques donne kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1". Pour mettre un ScaledObject en pause, elle utilise l’annotation autoscaling.keda.sh/paused: "true", qui fige le nombre d’instances actuel. Les alertes sur ces signaux se rapprochent de alertes Kubernetes sur nœuds, pods et quotas.
Limites et points ouverts
- Pas de scale-to-zero avec les déclencheurs CPU et mémoire, d’après la documentation.
- L’intégration OpenTelemetry est marquée expérimentale ; la page liste aussi des métriques dépréciées. Vérifiez les noms pour votre version.
- La page GitHub affiche des étoiles arrondies et aucune release lisible lors de la lecture : consultez les releases avant de figer une version.
- Un scaler qui perd sa source peut décider de façon surprenante : réglez
fallbacket surveillez les erreurs. - KEDA ne remplace pas le dimensionnement des requêtes de ressources : voir requêtes CPU effectives des pods.
Bonnes pratiques
- Alertez sur
keda_scaler_detail_errors_totalet surkeda_scaler_metrics_latency_secondsavant la charge, pas après. - Gardez les labels à forte cardinalité désactivés tant que vous n’en avez pas besoin.
- Définissez
fallbackpour les charges critiques et testez la mise en pause en préproduction. - Reliez le nombre de réplicas à un SLO : l’autoscaling sert le budget d’erreur, pas l’inverse.
Questions fréquentes
KEDA remplace-t-il le Horizontal Pod Autoscaler ?
Non. D’après la documentation, il l’étend : l’opérateur crée et gère le HPA, qui lit les métriques externes fournies par KEDA.
Quelles métriques KEDA expose-t-il ?
Des métriques Prometheus sur le port 8080, chemin /metrics, pour l’opérateur, les webhooks et le serveur de métriques. Un export OpenTelemetry expérimental existe aussi.
Peut-on descendre à zéro réplica ?
Oui, avec des déclencheurs pilotés par événements. La documentation précise que ce n’est pas possible avec les déclencheurs CPU ou mémoire.
Conclusion
KEDA relie le nombre de pods aux événements qui comptent, à condition de superviser ses scalers comme n’importe quel composant de production. Sources : dépôt kedacore/keda et documentation keda.sh.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.