KEDA autoescalado Kubernetes: el repositorio kedacore/keda describe KEDA como un componente de autoescalado dirigido por eventos, que cambia el número de réplicas de cualquier contenedor de un clúster de Kubernetes, incluso desde y hasta cero. La página del repositorio muestra unas 10 700 estrellas y unos 1600 forks a finales de octubre de 2026 (cifras redondeadas por GitHub), con licencia Apache 2.0.
Para un SRE el interés es sencillo: en lugar de seguir la CPU, se sigue lo que mide de verdad la carga, como una cola de mensajes o una consulta de Prometheus. El inconveniente es igual de claro: un componente más decide cuántos pods se ejecutan, así que hay que observarlo. Este artículo sigue el README y la documentación oficial de keda.sh (versión 2.21), y no afirma haber instalado KEDA.
Una precisión de honestidad: span.observer no ha probado KEDA. Los comandos vienen de la documentación, y las capturas vienen de keda.sh o reproducen al pie de la letra extractos de su documentación.
KEDA autoescalado Kubernetes: qué dice el repositorio
- Proyecto: el README indica que KEDA es un proyecto graduado de la Cloud Native Computing Foundation (CNCF).
- Licencia: Apache 2.0, verificada en el archivo LICENSE del repositorio el 26 de octubre de 2026.
- Principio: según el README, KEDA ofrece un autoescalado fino, incluso desde y hasta cero, para cargas de Kubernetes dirigidas por eventos. Se configura con una definición de recurso personalizado (CRD).
- Compatibilidad: la documentación indica que KEDA 2.21 se prueba con Kubernetes 1.34 a 1.36.
- Cifras: estrellas y forks leídos en la página del repositorio, redondeados. La página no mostraba ninguna versión legible, así que no se cita un número de release.
Recorrido por el esquema de arquitectura
El esquema de la página «Concepts» de keda.sh muestra los tres componentes y su papel. Viene del sitio del propio proyecto, cuyo repositorio de documentación está bajo licencia Apache 2.0.
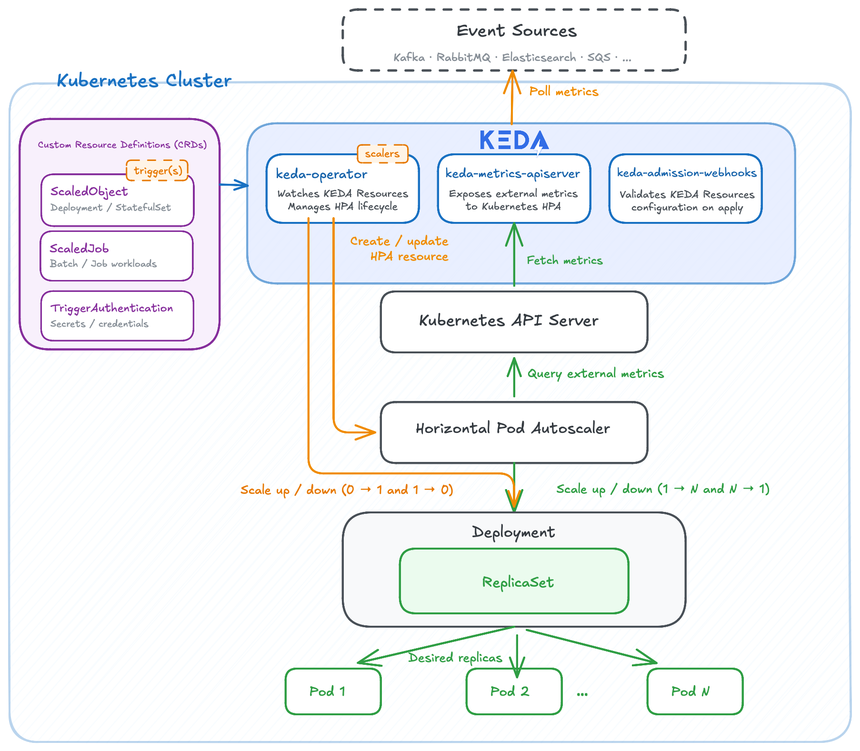
La documentación describe tres componentes:
keda-operatorvigila los recursos de KEDA (ScaledObject, ScaledJob, TriggerAuthentication), gestiona el ciclo de vida del HPA y pasa la carga de 0 a 1 réplica y viceversa;keda-metrics-apiserverexpone métricas externas al API Server de Kubernetes, que consulta el HPA;keda-admission-webhooksvalidan los recursos al aplicarlos, por ejemplo para rechazar dos ScaledObject sobre el mismo Deployment.
Así, KEDA amplía el Horizontal Pod Autoscaler (HPA) en lugar de sustituirlo. Las transiciones de 1 a N pasan por el HPA. Un punto que conviene recordar: la documentación precisa que el escalado a cero no se admite con disparadores de CPU o memoria.
Instalación paso a paso
Paso 1: Requisitos
Hace falta un clúster de Kubernetes dentro del rango probado, Helm instalado y permiso para instalar charts. El README menciona también Operator Hub y archivos YAML; lo que sigue usa la vía Helm de la documentación.
Paso 2: Instalar con Helm
helm repo add kedacore https://kedacore.github.io/charts
helm repo update
helm install keda kedacore/keda --namespace keda --create-namespace
Paso 3: Comprobar los pods
kubectl get pods -n kedaDeberías ver los pods de los componentes descritos arriba. La desinstalación se hace con helm uninstall keda --namespace keda; la página de despliegue imprime la opción con una raya corta, que debes sustituir por dos guiones simples.
Paso 4: Declarar un ScaledObject
Un ScaledObject enlaza una carga con uno o varios disparadores. El ejemplo siguiente es el de la página del scaler de Prometheus de la documentación.
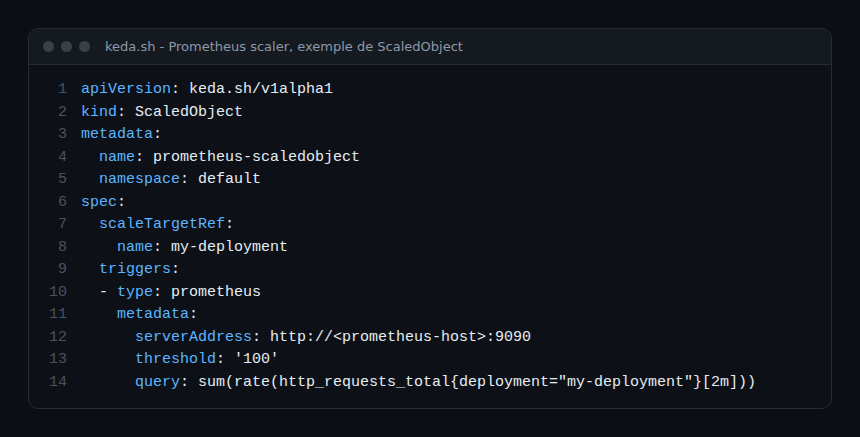
La página de especificación da estos valores por defecto: pollingInterval 30 segundos, cooldownPeriod 300 segundos, minReplicaCount 0 y maxReplicaCount 100. El parámetro activationThreshold del scaler de Prometheus vale 0 por defecto. El campo fallback exige failureThreshold y replicas: fija un número de réplicas si el scaler falla de forma repetida.
Observar KEDA: métricas de Prometheus
Para saber si el autoescalado se comporta como se espera, la documentación indica que el operador, los webhooks de admisión y el servidor de métricas exponen métricas de Prometheus en el puerto 8080, en la ruta /metrics. Para conectar estas métricas con tu pila, consulta Prometheus y Dynatrace en Kubernetes.
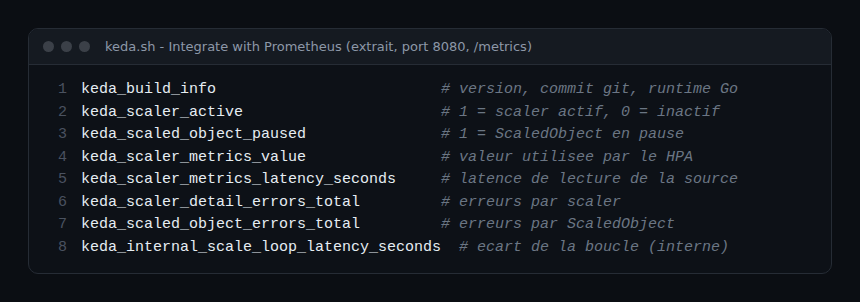
La captura reutiliza los nombres de la documentación; los comentarios son de span.observer. Algunas lecturas útiles:
keda_scaler_activevale 1 cuando el scaler está activo y 0 en caso contrario: es la señal «KEDA ve carga».keda_scaler_metrics_valueda el valor que usa el HPA para calcular su objetivo.keda_scaler_metrics_latency_secondsmide el tiempo de lectura de la fuente; una deriva alarga el bucle de escalado.keda_scaler_detail_errors_total,keda_scaled_object_errors_totalykeda_scaled_job_errors_totalcuentan los errores por scaler, ScaledObject y ScaledJob.keda_scaler_empty_upstream_responses_totalcuenta las respuestas vacías de la fuente, por ejemplo una consulta de Prometheus sin resultados.keda_scaled_object_pausedvale 1 si un ScaledObject está en pausa.
La documentación señala que un operador sin ningún scaler solo expone keda_build_info; las demás aparecen con tus scalers. Las etiquetas de alta cardinalidad (namespace, scaled_resource, trigger_name, metric_name) se activan con --enable-high-cardinality-metrics-labels=true en el Deployment keda-operator: mide antes el coste de almacenamiento.
OpenTelemetry y eventos de Kubernetes
En cuanto a OpenTelemetry, la documentación describe una integración experimental, disponible desde la versión 2.12. Son métricas enviadas a un Collector, no trazas. Se activa la exportación con el argumento --enable-opentelemetry-metrics=true del operador y se indica el Collector con la variable de entorno OTEL_EXPORTER_OTLP_ENDPOINT (el ejemplo de la página es http://opentelemetry-collector.default.svc.cluster.local:4318). OTEL_EXPORTER_OTLP_PROTOCOL elige HTTP o gRPC. Los nombres cambian de forma, por ejemplo keda.scaler.active. Consulta también el Collector de OpenTelemetry en Kubernetes y OpenTelemetry y Prometheus.
KEDA también emite eventos de Kubernetes, listados en su referencia. Los más útiles en operación:
KEDAScaleTargetActivatedyKEDAScaleTargetDeactivated(Normal): el destino pasa a 1 o a 0;KEDAScaleTargetActivationFailedyKEDAScaleTargetDeactivationFailed(Warning): el cambio ha fallado;KEDAScalerFailed(Warning): un scaler no logra crear o comprobar su fuente de eventos;ScaledObjectCheckFailed(Warning): falla la validación de un ScaledObject;ScaledObjectFallbackActivated: el repliegue está activo;ScaledObjectPausedyScaledObjectUnpaused: pausa o reanudación.
Para inspeccionar lo que recibe el HPA, la documentación del servidor de métricas da kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1". Para pausar un ScaledObject usa la anotación autoscaling.keda.sh/paused: "true", que congela el número actual de instancias. Las alertas sobre estas señales se parecen a alertas de Kubernetes sobre nodos, pods y cuotas.
Límites y puntos abiertos
- No hay escalado a cero con disparadores de CPU y memoria, según la documentación.
- La integración con OpenTelemetry está marcada como experimental; la página lista además métricas obsoletas. Comprueba los nombres en tu versión.
- La página de GitHub mostraba estrellas redondeadas y ninguna release legible al leerla: consulta las releases antes de fijar una versión.
- Un scaler que pierde su fuente puede decidir de forma sorprendente: configura
fallbacky vigila los errores. - KEDA no sustituye el dimensionamiento de las solicitudes de recursos: consulta solicitudes de CPU efectivas de los pods.
Buenas prácticas
- Alerta sobre
keda_scaler_detail_errors_totalykeda_scaler_metrics_latency_secondsantes de la carga, no después. - Mantén desactivadas las etiquetas de alta cardinalidad mientras no las necesites.
- Define
fallbackpara las cargas críticas y prueba la pausa en preproducción. - Vincula el número de réplicas a un SLO: el autoescalado sirve al presupuesto de errores, no al revés.
Preguntas frecuentes
¿KEDA sustituye al Horizontal Pod Autoscaler?
No. Según la documentación, lo amplía: el operador crea y gestiona el HPA, que lee las métricas externas que proporciona KEDA.
¿Qué métricas expone KEDA?
Métricas de Prometheus en el puerto 8080, ruta /metrics, para el operador, los webhooks y el servidor de métricas. También existe una exportación experimental a OpenTelemetry.
¿Se puede bajar a cero réplicas?
Sí, con disparadores dirigidos por eventos. La documentación precisa que no es posible con disparadores de CPU o memoria.
Conclusión
KEDA vincula el número de pods a los eventos que importan, siempre que supervises sus scalers como cualquier componente de producción. Fuentes: repositorio kedacore/keda y documentación de keda.sh.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.