freehire moteur recherche d’emploi : le dépôt strelov1/freehire est un moteur de recherche d’offres IT open source, écrit en Go, qui affirme agréger plus de 3,3 millions d’offres ouvertes, tirées directement des pages carrières des entreprises. Il compte environ 2 600 étoiles et 262 forks à la date de relecture, le 22 octobre 2026, sous licence MIT. Le projet existe aussi en service hébergé (freehire.me), mais son intérêt pour ce blog est autre : toute la chaîne (collecte, déduplication, indexation, API) est dans le dépôt et s’auto-héberge.
C’est donc un bon sujet d’exploitation : une API web, une base PostgreSQL, un moteur Meilisearch, Redis et une série de travaux planifiés. Ce guide suit le README et le code du dépôt.
Précision d’honnêteté : span.observer n’a pas installé ni lancé freehire. Les commandes viennent du README ; les chiffres d’offres sont ceux annoncés par le projet, non vérifiés par nous.
freehire moteur recherche d’emploi : ce que dit le dépôt
- Licence et langage : MIT ; serveur en Go (framework Fiber), front-end SvelteKit.
- Chiffres relus le 22 octobre 2026 sur la page du dépôt : environ 2 600 étoiles (la page n’affiche que « 2,6 k »), 262 forks, aucune release publiée.
- Ce que le README annonce : un instantané daté du 20 octobre 2026 de 3 371 563 offres ouvertes uniques, 477 323 entreprises et 320 sources dont 117 plateformes de suivi de candidatures (ATS) comme Workday, Greenhouse ou Lever, ainsi que 97 canaux Telegram. Ce sont des chiffres du projet.
- Principe : chaque offre est normalisée dans un schéma unique et dédupliquée ; les filtres (région, mode de travail, séniorité, compétences, salaire) viennent de dictionnaires maintenus à la main, pas de suppositions d’un modèle, selon le README.
Au-delà de la recherche, le README décrit une couche « candidat » : générateur de CV, suivi des candidatures, assistant IA, serveur MCP et extension de navigateur. Plusieurs de ces fonctions demandent un point d’accès LLM compatible OpenAI que vous configurez vous-même (variables LLM_BASE_URL, LLM_API_KEY, LLM_MODEL dans le fichier d’exemple).
Visite de l’interface
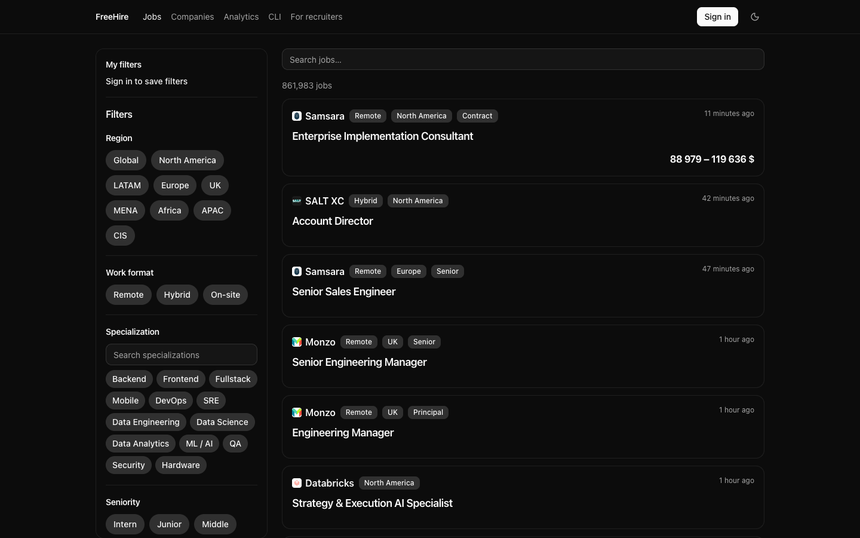
La capture du README montre la page de recherche : une barre de recherche, le nombre total d’offres, des filtres à gauche (région, mode de travail, spécialisation, séniorité) et la liste d’offres à droite, chacune avec l’entreprise, le lieu, le niveau et l’ancienneté de l’annonce. Les noms d’entreprises visibles sont ceux de l’exemple du dépôt, et chaque offre renvoie, selon le README, vers la page de l’entreprise.
Installation pas à pas
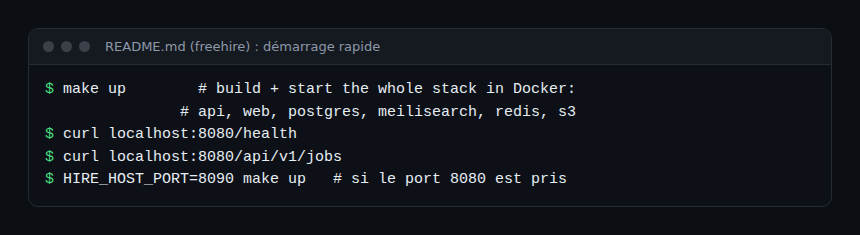
Le démarrage rapide du README suppose Docker ; il lance toute la pile (API, front, PostgreSQL, Meilisearch, Redis, stockage compatible S3).
- Cloner le dépôt et se placer dans le dossier.
- Lancer la pile, puis tester :
make up curl localhost:8080/health curl localhost:8080/api/v1/jobs - Si le port 8080 est pris, choisir un autre port hôte :
HIRE_HOST_PORT=8090 make up
Les migrations s’appliquent automatiquement à la première initialisation du volume PostgreSQL ; si vous modifiez une migration, recréez le volume avec docker compose down -v && make up ou utilisez make migrate. Pour développer, le README propose docker compose up -d db puis make run, avec un fichier .env copié depuis .env.example. La variable JWT_SECRET est obligatoire pour que le serveur démarre ; le fichier d’exemple porte une valeur de développement qu’il faut remplacer par un secret aléatoire fort hors poste local.
Le serveur ne fait que servir l’API. La collecte, l’enrichissement, l’indexation et les notifications sont des travaux à exécution unique, faits pour être planifiés (cron) : par exemple go run ./cmd/ingest greenhouse pour parcourir un fournisseur, go run ./cmd/search-drain à faire tourner toutes les une à deux minutes pour pousser les écritures dans l’index, ou go run ./cmd/reindex pour reconstruire l’index Meilisearch. Chaque travail exige DATABASE_URL et sort avec un code non nul en cas d’échec : c’est précisément ce que votre planificateur doit surveiller.
Limites et points ouverts
- Projet jeune : pas de release publiée ; un dépôt très actif (le dernier commit que nous avons relu date du jour de la rédaction) mais dont l’interface de configuration peut bouger vite. Fixez un commit.
- Données collectées : l’outil explore des pages carrières publiques et des fils tiers. Les conditions d’utilisation des sites sources, la protection des données personnelles et les limites de fréquence restent de votre responsabilité si vous auto-hébergez.
- Chiffres non vérifiés : le volume d’offres et la fraîcheur sont annoncés par le projet.
- Fonctions IA : elles dépendent d’un LLM que vous fournissez, avec des coûts et des données qui partent chez le fournisseur choisi. Voir le choix d’un LLM selon des critères d’exploitation.
- Taille de la pile : cinq services minimum et des travaux planifiés, loin d’un binaire unique.
Observer freehire en production
Le README cite la pile d’observabilité du projet : Langfuse pour tracer les appels LLM, Prometheus (via le collecteur de fichiers texte de node_exporter) et Grafana pour les métriques de l’ingestion et du LLM. Dans le code, la configuration lit une variable METRICS_PORT : si elle est définie, le serveur expose /metrics sur un port dédié plutôt que sur le port de l’API, afin qu’une règle de pare-feu interne ne laisse pas passer le reste de l’API (commentaire du fichier config.go). Le serveur utilise la bibliothèque cliente Prometheus pour cela.
Pour votre propre supervision, que vous soyez sur Dynatrace SaaS ou Dynatrace Managed :
- Disponibilité : sondez
/healthet/api/v1/jobsdepuis l’extérieur. - Métriques : récupérez
/metricsavec un Collector OpenTelemetry (récepteur Prometheus) ou un scrape Prometheus, comme décrit dans OpenTelemetry et Prometheus : complémentaires. - Travaux planifiés : alertez sur un code de sortie non nul et sur l’absence d’exécution de
search-drain; un index en retard donne des résultats périmés sans erreur visible. - Coûts LLM : suivez les jetons par fonction, voir le coût d’un agent IA en jetons avec OpenTelemetry et Langfuse et OpenLLMetry.
Le dépôt n’annonce pas d’export de traces OpenTelemetry ; les dépendances OpenTelemetry présentes dans go.mod y sont marquées « indirectes ». Ne comptez donc pas sur des traces prêtes à l’emploi.
Comment vérifier que ça fonctionne
curl localhost:8080/healthrépond ;curl localhost:8080/api/v1/jobsrenvoie un objet avecdataetmeta(format décrit dans le README), éventuellement vide tant que rien n’est collecté.- Après un premier
cmd/ingestpuiscmd/search-drain, les offres apparaissent dans la recherche. - Si
METRICS_PORTest défini,/metricsrépond sur ce port.
Bonnes pratiques
- Remplacez
JWT_SECRETet ne laissez jamais le port de métriques ouvert sur Internet. - Planifiez les travaux avec un orchestrateur qui journalise le code de sortie et la durée.
- Sauvegardez PostgreSQL : c’est le système de référence, l’index se reconstruit.
- Pour d’autres briques auto-hébergées, voir la stack IA open source auto-hébergée ; pour une base Postgres de même esprit, voir Supabase.
Questions fréquentes
Faut-il auto-héberger ou utiliser freehire.me ?
Le site hébergé suffit pour chercher des offres. L’auto-hébergement a du sens pour exploiter les données ou l’API, au prix d’une pile à maintenir.
Faut-il un LLM ?
Non pour la recherche : les fonctions qui en ont besoin restent désactivées tant que les variables LLM_* ne sont pas définies, selon le README et la documentation des fonctions.
Puis-je ajouter une entreprise ?
Oui : le README indique qu’ajouter une entreprise est une ligne du catalogue « boards » (entreprise, fournisseur, identifiant du tableau d’offres), via le formulaire du site ou la commande cmd/add-board, et demande d’ouvrir d’abord une issue pour une nouvelle plateforme.
Conclusion
freehire est un moteur de recherche d’emploi complet et ouvert, intéressant à lire comme architecture : API, travaux à exécution unique, index et métriques séparés. Reste à vérifier ses chiffres et vos obligations sur les données collectées. Sources : dépôt strelov1/freehire.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.