Flex Logs Datadog est un niveau de stockage des logs qui sépare le stockage du calcul : vous conservez longtemps des volumes importants, et vous payez la capacité de requête à part. Selon la documentation Datadog, il vise une requête « live » économique sur une rétention longue. La vraie question pour une équipe SRE n’est pas « faut-il l’activer ? » mais « quels logs sortent de l’indexation standard, et lesquels doivent y rester ? ».
Cet article propose une grille de décision, fondée uniquement sur la documentation officielle consultée le 30 octobre 2026. Il ne donne aucun tarif : les prix évoluent, lisez-les sur la page officielle de Datadog. Le contenu vaut pour Datadog ; pour Dynatrace, la comparaison porte sur les concepts, pas sur une équivalence de fonctionnalités.
En bref
- Datadog décrit trois options : indexation standard, Flex Logs et archivage.
- Flex Logs ne prend en charge ni les monitors ni Watchdog ; les dashboards, oui.
- Le compute est la capacité de requête, dimensionnée selon le nombre d’événements stockés.
- Les logs qui servent à alerter doivent rester en indexation standard.
Flex Logs Datadog : les trois options de la documentation
La documentation distingue trois usages. L’indexation standard convient aux logs consultés souvent et conservés peu de temps, comme les logs applicatifs. Flex Logs convient aux logs conservés longtemps mais parfois à interroger en urgence : sécurité, transactions, réseau. L’archivage convient aux logs rarement consultés et stockés longtemps, comme l’audit ou la configuration.
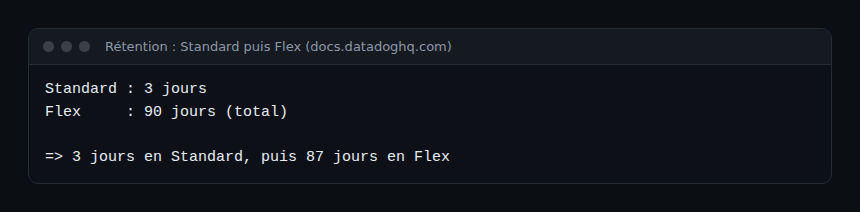
Ces options se combinent. La documentation indique que l’on peut garder des logs en indexation standard, puis prolonger leur durée avec Flex Logs. Les filtres d’un index s’appliquent aussi à son niveau Flex.
L’archivage est un autre mécanisme. D’après la page Log Archives, il envoie tous les logs ingérés, indexés ou non, vers un bucket que vous possédez (AWS S3, Azure Storage ou Google Cloud Storage). On y accède ensuite par réhydratation ou par recherche dans l’archive.
Ce que Flex Logs ne fait pas : monitors et Watchdog
C’est la limite qui décide de tout. La documentation est explicite : les monitors ne sont pas pris en charge, Watchdog non plus. Les dashboards fonctionnent, mais leurs requêtes comptent dans le dimensionnement du compute.
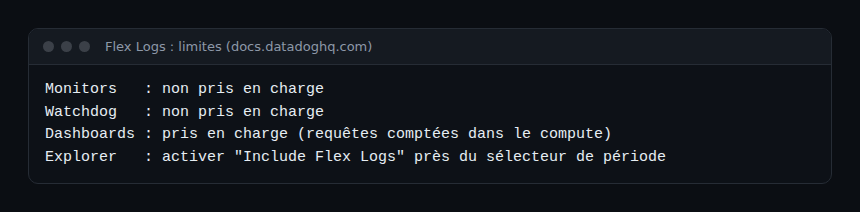
Conséquence pour un SRE : un log qui alimente une alerte sur un SLO ne peut pas vivre uniquement en Flex. Un log d’audit ou de flux réseau que l’on consulte seulement après un incident, si. Le critère est simple : ce log déclenche-t-il quelque chose, ou sert-il surtout à enquêter ? Pour la distinction entre alerter et explorer, voyez notre article sur l’observabilité face au monitoring.
Comprendre le compute et la rétention
Les tailles de compute
Le compute est la capacité de requête de Flex Logs. D’après la documentation, il n’est pas utilisé pour l’ingestion ni pour la recherche dans les seuls logs en indexation standard. Les tailles sont Starter, XS, XS+, S, M et L ; chacune offre environ deux fois la performance et la capacité de la précédente. La capacité est limitée par le nombre de requêtes simultanées et par le maximum de logs scannés par requête.
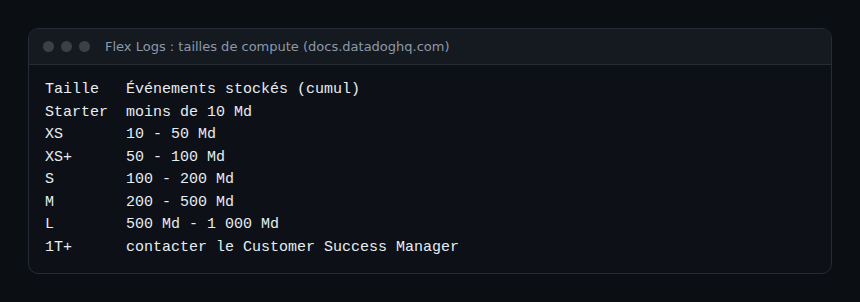
Ces seuils sont les recommandations de la documentation. Selon Datadog, Starter est facturé à un tarif groupé stockage plus compute, les tailles XS à L à un tarif forfaitaire. Quand la capacité est atteinte, les requêtes ralentissent et se relancent ; celles qui réessaient trop souvent peuvent échouer, avec le message « Flex Logs compute capacity is constrained ».
La rétention
Selon la documentation, la rétention de Starter est de 3, 6, 12 ou 15 mois ; celle des tailles à l’échelle va de 30 à 450 jours. Si un index combine les deux niveaux, les logs restent en standard jusqu’à la fin de la rétention standard, puis passent en Flex pour le reste.
Grille de décision : quels logs sortir de l’indexation standard
La documentation cite des sources candidates à un envoi direct vers Flex : journaux d’audit (CloudTrail, audit Kubernetes), CDN, CI/CD, DNS, identité, répartiteurs de charge, équipements réseau et service meshes. Voici une grille de lecture, qui est notre interprétation et non une recommandation de l’éditeur.
| Question | Si oui | Si non |
|---|---|---|
| Un monitor ou Watchdog s’appuie-t-il sur ce log ? | Garder en standard | Candidat Flex |
| Faut-il le conserver plus longtemps que la rétention standard ? | Étendre avec Flex | Rester en standard |
| Est-il consulté presque jamais, mais exigé par la conformité ? | Flex ou archivage | Standard |
| Faut-il le rechercher en direct après un incident ? | Flex plutôt qu’archive | Archivage |
Une astuce utile : avant de déplacer un flux, listez les monitors de logs existants. Si l’un d’eux interroge ce flux, créez une métrique basée sur les logs ou conservez ce sous-ensemble en standard. Les filtres d’exclusion des index servent à retirer de l’index les logs sans valeur, qui restent disponibles dans Livetail, les archives et les métriques basées sur les logs.
Configurer un niveau Flex pas à pas
- Vérifiez que vous avez la permission
flex_logs_config_write: l’activation se fait au niveau de l’organisation. - Ouvrez la page Flex Logs Control, choisissez le type de compute et la taille, puis cliquez sur Enable Flex Logs. Starter est recommandé sous 10 milliards de logs stockés.
- Dans Indexes Configuration, modifiez ou créez un index, sélectionnez Flex Tier et réglez la rétention sous Configure Storage Tier and Retention.
- Dans le Log Explorer, activez « Include Flex Logs » près du sélecteur de période pour interroger ce niveau.
Pour passer d’un index standard à un index avec Flex, la documentation précise que la rétention est étendue aux logs existants comme aux nouveaux. Les montées de taille de compute se font à tout moment ; les descentes, une fois tous les 15 jours.
Comment vérifier que ça fonctionne
- Dans le Log Explorer, cochez « Include Flex Logs » et vérifiez que des logs plus anciens que la rétention standard apparaissent.
- Lancez une requête représentative d’une enquête réelle et observez sa durée. Le message de capacité contrainte signale un compute sous-dimensionné.
- Contrôlez qu’aucun monitor de logs n’est devenu muet : un monitor sur un flux passé en Flex seul ne verra plus ces logs. Ce point est à tester chez vous, la documentation indiquant seulement que les monitors ne sont pas pris en charge.
Bonnes pratiques
- Migrez un flux à la fois, en commençant par les logs d’audit ou réseau sans alerte.
- Gardez les logs d’erreur applicatifs liés à vos SLO en indexation standard.
- Réévaluez la taille de compute quand le cumul d’événements change de palier.
- Tenez à jour la liste des flux et de leur niveau : c’est du toil évitable pour l’astreinte.
Et côté OpenTelemetry et Dynatrace ?
Le choix du niveau intervient après l’ingestion : un Collector OpenTelemetry envoie les mêmes logs quelle que soit la destination, et le tri se fait dans la configuration des index. C’est un bon argument pour filtrer et enrichir tôt, comme dans notre article sur le Collector OpenTelemetry sur Kubernetes. Pour comparer les approches de coût côté rétention, voyez aussi l’ingestion APM et la rétention des spans chez Datadog et notre comparatif Dynatrace et Datadog.
Dans Dynatrace, d’après la documentation, les logs vont dans des buckets Grail dont la rétention va de 10 jours à 10 ans (35 jours pour le bucket default_logs). Un processeur d’OpenPipeline affecte les enregistrements à un bucket, ce qui sépare les logs par durée de conservation. Le modèle est différent de celui de Datadog : ne cherchez pas d’équivalence terme à terme.
Si vous comparez avec Elastic, notre article sur le frozen tier d’Elasticsearch traite le même arbitrage coût et latence.
Questions fréquentes
Flex Logs remplace-t-il l’indexation standard ?
Non. La documentation présente des options complémentaires : on peut conserver des logs en standard puis prolonger avec Flex. Les monitors et Watchdog restent liés à l’indexation standard.
Quelle différence avec l’archivage ?
L’archive est un stockage dans votre propre bucket, accédé par réhydratation ou recherche d’archive. Flex Logs reste interrogeable dans le Log Explorer avec une capacité de compute dédiée.
Où trouver les prix ?
Uniquement sur la page de tarification officielle de Datadog, qui fait foi et peut changer. Nous ne citons aucun prix issu de sites tiers.
Conclusion
Sortir des logs de l’indexation standard est une décision de fiabilité autant que de coût. Gardez en standard ce qui alerte, envoyez en Flex ce qui se consulte longtemps après coup, archivez le reste. Testez d’abord sur un flux sans monitor.
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Datadog Inc. Les noms de produits appartiennent à leurs propriétaires ; les valeurs viennent de la documentation officielle consultée le 30 octobre 2026 et peuvent changer.