
تتضاعف فاتورة السجلات كل ربع سنة، ونادرًا ما يقرأ أحد ما تخزّنه. فهل يلزم فعلًا فهرسة كل كلمة في كل سطر؟ مع تسميات Loki (labels) تقترح Grafana Labs العكس: فهرسة بضع تسميات لكل مجرى فقط، والبحث في الباقي وقت القراءة. كان مستودع grafana/loki يعرض نحو 29 200 نجمة في 11 نوفمبر 2026، وهو موزّع برخصة AGPL-3.0.
يخفض هذا الخيار التكلفة، لكنه يفرض انضباطًا. ننطلق هنا من قرار التشغيل: أي التسميات تُبقي، وأيها ترفض، وماذا تفعل بالقيم التي لا تتوقف عن التغيّر. المعلومات مأخوذة من الوثائق الرسمية ومن المستودع، واطُّلع عليها في 11 نوفمبر 2026.
توضيح منهجي: لم تنشر span.observer خدمة Loki من أجل هذا المقال. اللقطتان أدناه مقتطفان توضيحيان كتبناهما بأنفسنا ولم يُنفَّذا. ولوضع Loki ضمن منظومة كاملة، راجع مقارنتنا بين Dynatrace وGrafana.
لماذا تخفّض تسميات Loki تكلفة السجلات
يبني محرك البحث النصي الكامل فهرسًا على محتوى الأسطر. يكبر هذا الفهرس مع الحجم، ويجب تخزينه وإبقاؤه في الذاكرة. أما Loki فلا يفهرس محتوى السجلات، بحسب وثائقه، وإنما بيانات وصفية على شكل تسميات لكل مجرى (stream).
- المجرى هو التركيبة الفريدة من كل أزواج المفتاح والقيمة للتسميات.
- أسطر كل مجرى تُضغط وتُجمع في أجزاء (chunks) تُحفظ في تخزين كائني مثل S3 أو GCS.
- الفهرس يدل فقط على مكان أجزاء مجموعة معينة من التسميات.
التخزين الكائني هو الآلية الوحيدة لحفظ البيانات، فيرث Loki تكلفته وموثوقيته مقارنة بالأقراص المحلية. وحين يكبر حجم السجلات يأتي الوفر من فهرس صغير وأجزاء مضغوطة.
يُدفع الثمن عند القراءة. يحدد Loki المجرى أولًا بالتسميات ثم يمرّ على أسطره. والاستعلام الذي لا يضيّق المجاري يقرأ كمية كبيرة من البيانات.
القرار: أي تسميات تمنحها للمجرى؟
كل شيء يدور حول الكاردينالية (cardinality)، أي عدد التركيبات الفريدة من التسميات وقيمها. تحذّر الوثائق من أن الكاردينالية العالية تُلزم Loki ببناء فهرس ضخم وكتابة آلاف الأجزاء الصغيرة في التخزين الكائني. وكل قيمة جديدة لتسمية تنشئ مجرى جديدًا.
هذا هو الفرز الذي أقترحه، مستندًا إلى توصيات الوثائق.
- احتفظ بالقيم المستقرة المحدودة: المنطقة، والعنقود (cluster)، ومساحة الاسم (namespace)، والتطبيق، والبيئة. تسمية مضيف بألف قيمة تبقى مقبولة.
- ارفض القيم العابرة: معرّفات التتبع أو الطلبات، وعناوين IP، والطوابع الزمنية.
- ارفض التسميات التي لا يستعلم عنها أحد: فهي تضخّم الفهرس وتجزّئ المجاري بلا فائدة.
- احذر استخدام
levelكتسمية ديناميكية: المرشّح|= "level=error"غالبًا بالسرعة نفسها ولا يقسّم المجاري.
توجد أرقام مرجعية. ينبغي أن تحمل التسميات الديناميكية قيمًا قليلة، ربما بضع عشرات. ويطبّق Loki افتراضيًا حدًّا أقصى هو 15 تسمية فهرس، وتنصح الوثائق بألا تتجاوز التسميات المخصّصة 10 إلى 15.
الحالة المؤلمة: معرّف الطلب كتسمية
تعرض الوثائق مثالًا واضحًا. أظهر تحليل بالأمر logcli series --analyze-labels تسمية requestId بـ 24 653 قيمة مقابل 24 979 مجرى. ووصفها الدليل بأنها «المثال الأمثل على ما لا ينبغي أن يكون تسمية».
الحل أن تحذف التسمية وتبحث داخل السطر، مثلًا بالمرشّح |= "requestId=32422355". يعود المجرى فريدًا، وتمتلئ الأجزاء، ويبقى البحث معقولًا ما دام المحدِّد دقيقًا.
وهناك أثر ثانٍ أقل ظهورًا. مع كثرة المجاري تُكتب الأجزاء قبل أن تمتلئ، بسبب انقضاء مهلة الخمول أو بلوغ العمر الأقصى، فتنتج أجزاء صغيرة كثيرة. وتبيّن المقياس loki_ingester_chunks_flushed_total مجمّعًا حسب reason سبب إرسالها.
قيد آخر يجدر بك معرفته: داخل المجرى الواحد يجب أن تصل الإدخالات مرتبة زمنيًا، ضمن نافذة افتراضية مدتها ساعتان. وبعدها يرفض Loki السطر بخطأ «too far behind». ويمنع فصلُ مصدرين بتسميتين مختلفتين خلطهما في مجرى واحد.
البيانات الوصفية المهيكلة: احتفظ بالقيمة دون فهرستها
ماذا تفعل بمعرّف حاوية (pod) أو خيط أو عملية، مفيد لكنه غير مستقر بما يكفي ليكون تسمية؟ تقترح الوثائق البيانات الوصفية المهيكلة (structured metadata): بيانات مرفقة بالسطر، بلا فهرس وبلا إدراجها في النص. وتوصي بها خصوصًا لبيانات OpenTelemetry الواردة عبر Grafana Alloy أو OpenTelemetry Collector. وعن Alloy راجع المقال عن المجمّع الذي يحل محل Promtail.
لها متطلبات محددة:
- مخطط بالإصدار 13 أو أحدث (صيغة الأجزاء V4)؛
- فهرس
tsdb: أماboltdb-shipperالقديم المهجور فلا يدعمها؛ - ضبط
allow_structured_metadata: trueداخلlimits_config.
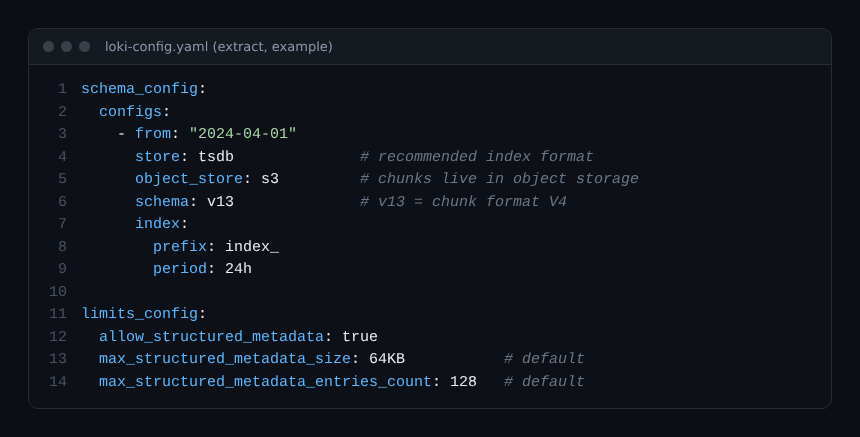
الحدود الافتراضية هي 64 كيلوبايت و128 إدخالًا لكل سطر. وإذا تجاوزتها رُفض السطر بخطأ HTTP 400. وعند القراءة تظهر هذه القيم كتسميات في النتيجة وتُرشَّح بالطريقة نفسها. انتبه: في استعلام المقاييس قد تُضخّم عدد السلاسل كثيرًا، وتزيل الخطوتان keep أو drop ما لا حاجة إليه.
الوثائق التي قرأتها لا تذكر في أي إصدار من Loki ظهرت هذه الميزة، ولذلك لا أجزم بذلك.
الاستعلام بلغة LogQL
يتكون استعلام LogQL من جزأين: محدِّد مجرى إلزامي، ثم خط معالجة اختياري. يستخدم المحدِّد العوامل = و!= و=~ و!~. ويربط خط المعالجة بين مرشّحات الأسطر (|= و!= و|~) ومحلّلات مثل json أو logfmt، ثم مرشّحات على الحقول المستخرجة.
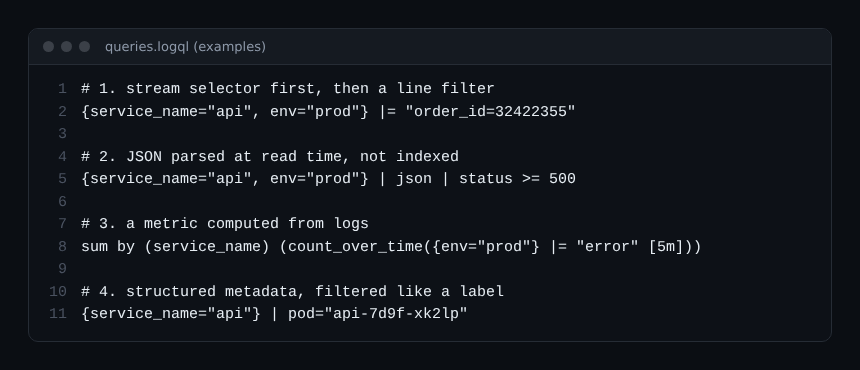
القاعدة العملية: محدِّد ضيق أولًا، ثم مرشّح سطر، ثم محلّل. فالمحلّل مكلف حين تكثر الأسطر، أما المحدِّد فلا. ولمعرفة مقاربة مختلفة لتحليل السجلات، راجع تحليل أنماط السجلات.
رخصة AGPL-3.0: ما الذي تفرضه
يذكر ملف README في المستودع أن Loki موزّع برخصة AGPL-3.0-only، ويحوي ملف LICENSE نص رخصة GNU Affero العامة، الإصدار 3. ولم أجد أي استثناء في هذا الملف.
خصوصية AGPL تكمن في بندها 13: إذا عدّلت البرنامج وتفاعل معه مستخدمون عن بُعد، فعليك أن تتيح لهم الشيفرة المصدرية لنسختك المعدّلة. أما للاستخدام الداخلي دون تعديل، فيُنظر إلى الالتزام عادةً على أنه خفيف. هذه القراءة ليست استشارة قانونية: اعرض حالتك على مختص، خاصة إذا عدّلت Loki أو قدمته كخدمة. ولم أتحقق من شروط العروض التجارية لدى Grafana Labs.
ممارسات جيدة
- أحصِ التسميات التي تستخدمها استعلاماتك فعلًا واحذف الباقي.
- قِس الكاردينالية قبل الإنتاج بالأمر
logcli series --analyze-labels. - انقل القيم عالية الكاردينالية إلى البيانات الوصفية المهيكلة بعد التحقق من المخطط والفهرس.
- راقب أسباب تفريغ الأجزاء وعدد المجاري النشطة لكل مستأجر (tenant).
- أبقِ الاستعلامات بمحدِّد ضيق: فهو الذي يضبط تكلفة القراءة.
- أعد قراءة رخصة AGPL قبل تعديل الشيفرة أو إتاحتها لأطراف خارجية.
الأسئلة الشائعة
هل Loki أرخص فعلًا من محرك بحث نصي كامل؟
تؤكد الوثائق ذلك من جهة التشغيل، بفضل فهرس صغير وأجزاء مضغوطة في تخزين كائني. لم أقس هذا الوفر بنفسي: فهو يتوقف على حجمك وتسمياتك واستعلاماتك.
هل يمكن البحث عن قيمة ليست تسمية؟
نعم، بمرشّح سطر أو بمحلّل أو عبر البيانات الوصفية المهيكلة. يمرّ البحث حينئذ على أسطر المجاري المختارة، لذا يبقى المحدِّد الدقيق ضروريًا.
ما الحد الذي لا ينبغي تجاوزه؟
تذكر الوثائق مرجعًا للمستأجرين الكبار جدًا: أقل من 100 000 مجرى نشط وأقل من مليون مجرى خلال 24 ساعة. وعلى المستأجر الأصغر أن ينخفض عن ذلك بنسبة مماثلة.
خلاصة
يجعل Loki السجلات رخيصة إن قبلت قاعدة بسيطة: تسميات قليلة ومستقرة تُختار من أجل الاستعلامات. وما يتغير يوضع في السطر أو في البيانات الوصفية المهيكلة. المستودع والوثائق: grafana/loki وgrafana.com/docs/loki.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Grafana Labs. العلامات التجارية المذكورة ملك لأصحابها. الأدوات تتغير بسرعة: تحقق دائمًا من الأوامر والخيارات في الوثائق الرسمية الخاصة بإصدارك.