Una pasarela LLM es un proxy situado entre tus aplicaciones y los proveedores de modelos: todas las peticiones pasan por un punto único, que puede contar los tokens, atribuir cada gasto a un equipo y cortar un presupuesto agotado. Para un SRE, es la forma más directa de responder a la pregunta «¿quién consume qué y por qué se ha duplicado la factura?» sin modificar el código de cada servicio. Este artículo compara dos proyectos de código abierto, LiteLLM y Helicone, solo para ese uso: seguir los costes.
El principio es el mismo que el de una API gateway clásica: la identidad del llamante (clave virtual, cabecera) se convierte en una dimensión de la métrica. Sin ella, un contador global de tokens no dice nada sobre el equipo responsable. Con ella, un presupuesto por clave y una alerta por equipo pasan a ser posibles.
Precisión de honestidad: span.observer no ha desplegado ni LiteLLM ni Helicone para este artículo. Los extractos, nombres de métricas y cabeceras proceden de las páginas oficiales de documentación consultadas el 31 de octubre de 2026. Aquí no se ha medido ninguna cifra de coste.
Pasarela LLM: lo que ofrecen los dos proyectos
- LiteLLM: el repositorio
BerriAI/litellmmuestra unas 62 400 estrellas en la fecha de consulta. El archivo LICENSE indica la licencia MIT, salvo la carpetaenterprise/, sujeta a su propia licencia. El README presenta el proxy como una «AI Gateway» autoalojada para más de 100 LLM, detrás de una interfaz en formato OpenAI, con claves virtuales, seguimiento del gasto, barreras de protección, reparto de carga e interfaz de administración. Las versiones publicadas no se recogen aquí: la página del repositorio no mostraba ninguna de forma fiable. - Helicone: el repositorio
Helicone/heliconetiene licencia Apache 2.0 (archivo LICENSE leído), con unas 6200 estrellas. Se describe como una plataforma de AI Gateway y observabilidad LLM. La documentación da la URLhttps://ai-gateway.helicone.aicomo base para un cliente compatible con OpenAI. El repositorio ofrece un despliegue con Docker Compose; el chart de Helm de producción está reservado a los clientes enterprise, según el README.
La diferencia de fondo está en cómo conserva cada uno los datos. LiteLLM guarda sus líneas de gasto en tu base de datos PostgreSQL y expone métricas Prometheus que recopilas tú mismo. Helicone, en el uso descrito por su documentación, centraliza costes y uso en su propio panel; la opción autoalojada existe, pero no se detalló en las páginas leídas. Este punto debe verificarse antes de cualquier elección.
Configurar LiteLLM para seguir los costes
Requisitos previos
Una base de datos PostgreSQL y la variable DATABASE_URL: la documentación de las claves virtuales indica que son necesarias para generar claves, y el seguimiento del gasto se apoya en la misma base. El formato esperado es postgresql://<user>:<password>@<host>:<port>/<dbname>.
Paso 1 — Declarar los modelos y activar las métricas
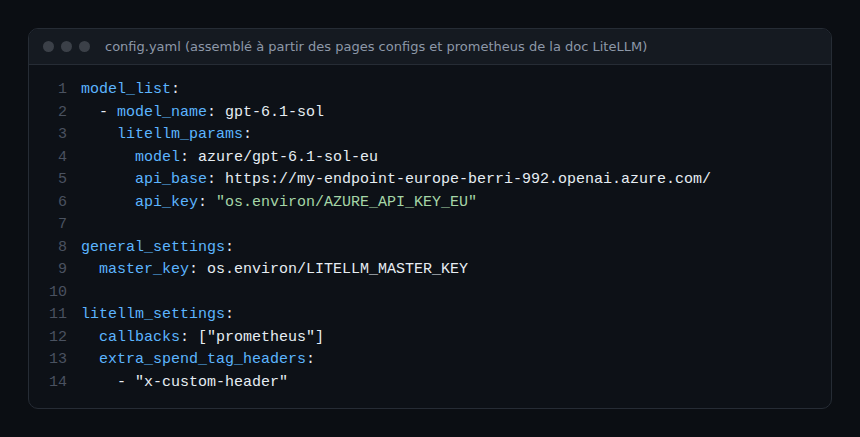
El archivo de configuración enumera los modelos expuestos, una clave maestra y los callbacks. La captura reúne los ejemplos de las páginas «configs» y «prometheus» de la documentación; los nombres de modelos proceden de la documentación y son ficticios.
Líneas que conviene recordar:
master_keylee su valor del entorno (prefijoos.environ/): ninguna clave en claro en el archivo.callbacks: ["prometheus"]activa el endpoint/metricsen el puerto del proxy.extra_spend_tag_headersconvierte una cabecera de petición (aquíx-custom-header) en una etiqueta de gasto, por ejemplo para un identificador de proyecto.
Arranque, según la documentación:
export DATABASE_URL="postgresql://user:password@localhost:5432/litellm"
litellm --config /path/to/config.yaml
Paso 2 — Crear una clave por equipo con un presupuesto
El gasto se atribuye a la clave virtual y, después, a su usuario y a su equipo. La documentación da la llamada /key/generate con la clave maestra en la cabecera Authorization; max_budget y budget_duration figuran como parámetros de la petición, pero no en un único ejemplo:
curl 'http://0.0.0.0:4000/key/generate' \
  --header 'Authorization: Bearer <your-master-key>' \
  --header 'Content-Type: application/json' \
  --data-raw '{"models": ["gpt-6.1-sol"], "max_budget": 10, "budget_duration": "30d", "metadata": {"user": "equipe-plateforme"}}'
Los valores 10 y 30d son ejemplos que hay que adaptar, y el nombre del modelo es el de la documentación. Cada aplicación o equipo recibe así su propia clave: es lo que hace legible el gasto. Atención a la observación de la documentación: el parámetro user de una petición se registra como usuario final, pero no modifica los totales del propietario de la clave. Para un seguimiento por usuario fiable, hay que rellenar user_id al crear las claves.
Paso 3 — Etiquetar las peticiones
Cada llamada escribe una línea en la tabla LiteLLM_SpendLogs: clave con hash, usuario, equipo, etiquetas, modelo, gasto y número de tokens. Las etiquetas se pasan por petición mediante metadata.tags, por clave o equipo al crearlos, o por cabecera con extra_spend_tag_headers. La respuesta lleva también el coste calculado en la cabecera x-litellm-response-cost. Para releer las líneas: GET /spend/logs (con summarize=false para el detalle) o GET /spend/logs/v2 paginado, cuya documentación señala un total limitado a 10 000.
Cómo comprobar que funciona
Tras unas cuantas peticiones, consulta el endpoint de métricas. La documentación precisa que, desde la versión 1.85.0, /metrics exige por defecto una clave de API de LiteLLM: añade un bloque authorization de tipo Bearer a la configuración de scrape de Prometheus. La página de referencia enumera, entre otras:
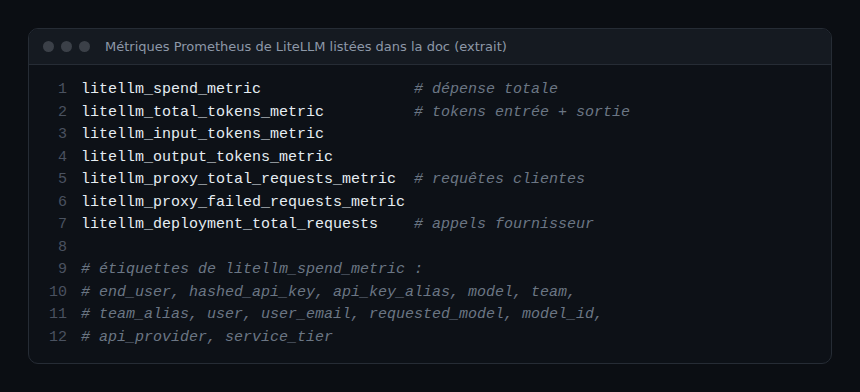
La página indica que estos contadores se consultan con el sufijo _total en las consultas PromQL. Una consulta útil para el equipo de finanzas interno, que debes validar en tu instancia: la suma de litellm_spend_metric_total agrupada por team_alias y model, en una ventana de 24 horas. Un contador litellm_zero_cost_requests_total señala además las peticiones que consumieron tokens sin ser valoradas: un modelo ausente de la tabla de precios falsearía de lo contrario tus totales sin hacer ruido.
Las métricas de gasto no están marcadas como «enterprise» en la página leída, a diferencia de las métricas de batch gestionados. Las etiquetas (team, api_key_alias, model, user_email…) son numerosas: vigila la cardinalidad de tu Prometheus antes de activarlas todas, véase OpenTelemetry y Prometheus.
Helicone: el seguimiento por cabeceras
Con Helicone, la configuración del lado del cliente se reduce a dos cambios: la URL base y la clave. Las dimensiones de coste pasan por cabeceras: Helicone-User-Id, reservada al seguimiento por usuario, y Helicone-Property-[Nombre] para cualquier propiedad personalizada, como el entorno o la aplicación.
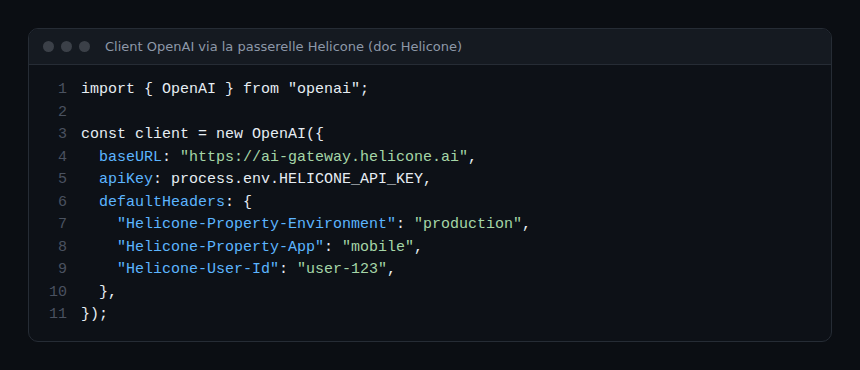
La documentación de la pasarela afirma seguir el uso, los costes y el rendimiento de todos los proveedores en un panel y anuncia un margen del 0 % sobre los tokens con sus créditos, frente al 5,5 % de OpenRouter: estas cifras son las del editor, no verificadas aquí. Una página vecina, dedicada al modo proxy histórico (gateway.helicone.ai con la cabecera Helicone-Target-Url), señala que la valoración de costes no es compatible con varios proveedores, entre ellos AWS Bedrock y Cohere. Antes de adoptar uno u otro, comprueba que tus proveedores y modelos están cubiertos.
¿Y la traza en OpenTelemetry y Dynatrace?
La documentación de LiteLLM prevé un callback otel: callbacks: ["otel"], con variables de entorno. Para un colector OTLP HTTP, la página utiliza OTEL_EXPORTER_OTLP_ENDPOINT, OTEL_EXPORTER_OTLP_PROTOCOL y OTEL_EXPORTER_OTLP_HEADERS. La página no proporciona una configuración completa: pruébala antes de fiarte de ella. La exportación gRPC requiere el paquete grpcio.
En Dynatrace SaaS, la documentación de exportación OTLP da la base https://{id-entorno}.live.dynatrace.com/api/v2/otlp con las rutas /v1/traces, /v1/metrics y /v1/logs. Precisa que gRPC no es compatible y que el formato es Protobuf binario; recomienda un Collector para convertir. El token se pasa como Authorization=Bearer; los permisos de ingesta que lista la página son de la familia openpipeline:…:ingest, que debes comprobar en la documentación de tokens de tu versión. Para Managed, esta página no da ninguna URL: consulta la documentación de Managed. No se encontró ninguna integración de Dynatrace propia de LiteLLM o Helicone en las páginas leídas; solo OTLP está documentado.
El camino más seguro es, por tanto, pasarela → Collector de OpenTelemetry → Dynatrace. Para relacionar los tokens y los costes con las trazas de un agente, véase el coste de un agente de IA con OpenTelemetry, y para el mismo papel de punto de control sobre las herramientas MCP, agentgateway. Si la traza detallada de los prompts importa más que el gasto, Langfuse y OpenLLMetry responden a otra necesidad.
Buenas prácticas
- Una clave virtual por aplicación y por equipo: sin ella, el gasto no se atribuye a nadie.
- Fija un presupuesto por clave desde el principio, y alerta antes del límite en lugar de al rechazar las peticiones (un presupuesto alcanzado corta un servicio: es un riesgo de disponibilidad, no solo de coste).
- Limita las etiquetas de métricas a las que necesites: el equipo y el modelo suelen bastar.
- Vigila las peticiones de coste cero: un modelo sin valorar falsea el seguimiento.
- Trata la pasarela como un componente crítico: se convierte en un punto único de paso y, por tanto, de fallo. Prevé réplicas, una alerta sobre la tasa de fallos (
litellm_proxy_failed_requests_metric) y una versión fijada. - No registres los prompts sin una política de retención: suelen contener datos personales.
Preguntas frecuentes
¿Una pasarela LLM sustituye a la observabilidad de la aplicación?
No. Cuenta tokens, costes y errores a nivel de las llamadas a los modelos. No dice nada del resto de la petición del usuario: las trazas de aplicación siguen siendo necesarias para situar la latencia.
¿LiteLLM o Helicone para seguir los costes?
Según su documentación, LiteLLM se autoaloja con tu PostgreSQL y expone métricas Prometheus; Helicone se usa cambiando la URL y las cabeceras, con su panel. La elección depende de dónde quieras conservar los datos y de la cobertura de tus proveedores.
¿Se pueden enviar estos datos a Dynatrace?
Solo por OTLP, según las páginas leídas, y no por gRPC directo: pasa por un Collector que convierta a OTLP/HTTP. No hay documentado ningún conector específico.
Conclusión
Una pasarela LLM da por fin una dimensión de «equipo» y «aplicación» a los costes de los modelos, siempre que crees claves distintas, etiquetes las peticiones y examines la valoración de los tokens. LiteLLM encaja de forma natural en una pila Prometheus; Helicone se conecta más rápido, pero desplaza el dato. Fuentes: métricas Prometheus de LiteLLM, seguimiento del gasto de LiteLLM, pasarela Helicone y exportación OTLP a Dynatrace.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC, a BerriAI ni a Helicone. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba siempre los comandos y las opciones en su documentación oficial.