بوابة LLM هي وكيل (proxy) يقف بين تطبيقاتك ومزوّدي النماذج: تمرّ كل الطلبات عبر نقطة واحدة تستطيع عدّ الرموز (tokens) ونسبة كل إنفاق إلى فريق وقطع الميزانية عند استنفادها. بالنسبة لمهندس SRE، هذه أقصر طريق للإجابة عن سؤال «من يستهلك ماذا، ولماذا تضاعفت الفاتورة؟» دون تعديل شيفرة كل خدمة. تقارن هذه المقالة مشروعين مفتوحي المصدر، LiteLLM وHelicone، لهذا الغرض وحده: تتبّع التكاليف.
المبدأ هو نفسه في بوابة API التقليدية: تصبح هوية المستدعي (مفتاح افتراضي أو ترويسة) بُعدًا في المقياس. وبدونها لا يدلّ عدّاد الرموز الإجمالي على الفريق المسؤول. أما معها فتصبح الميزانية لكل مفتاح والتنبيه لكل فريق ممكنين.
توضيح للأمانة: لم تنشر span.observer أداة LiteLLM ولا Helicone لهذه المقالة. المقتطفات وأسماء المقاييس والترويسات مأخوذة من صفحات الوثائق الرسمية التي روجعت في 31 أكتوبر 2026. ولم تُقَس هنا أي أرقام للتكلفة.
بوابة LLM: ما يقدّمه المشروعان
- LiteLLM: يعرض مستودع
BerriAI/litellmنحو 62 400 نجمة في تاريخ الاطلاع. يشير ملف LICENSE إلى ترخيص MIT، باستثناء المجلدenterprise/الخاضع لترخيصه الخاص. يقدّم README الوكيل على أنه «AI Gateway» ذاتي الاستضافة لأكثر من 100 نموذج LLM خلف واجهة بصيغة OpenAI، مع مفاتيح افتراضية وتتبّع للإنفاق وحواجز حماية وتوزيع للحمل وواجهة إدارة. لا تُذكر هنا الإصدارات المنشورة: لم تعرض صفحة المستودع أيًّا منها بشكل موثوق. - Helicone: مستودع
Helicone/heliconeبترخيص Apache 2.0 (قُرئ ملف LICENSE)، وله نحو 6200 نجمة. يصف نفسه بأنه منصة AI Gateway وقابلية ملاحظة LLM. تعطي الوثائق العنوانhttps://ai-gateway.helicone.aiأساسًا لعميل متوافق مع OpenAI. يقترح المستودع نشرًا عبر Docker Compose؛ أما مخطط Helm للإنتاج فمخصص لعملاء المؤسسات، بحسب README.
يكمن الفرق الجوهري في طريقة حفظ كل منهما للبيانات. يحتفظ LiteLLM بسطور الإنفاق في قاعدة PostgreSQL الخاصة بك ويعرض مقاييس Prometheus تجمعها بنفسك. أما Helicone، في الاستخدام الذي تصفه وثائقه، فيجمع التكاليف والاستخدام في لوحته الخاصة؛ والاستضافة الذاتية موجودة لكنها لم تُفصَّل في الصفحات المقروءة. هذه النقطة تستوجب التحقق قبل أي اختيار.
إعداد LiteLLM لتتبّع التكاليف
المتطلبات المسبقة
قاعدة PostgreSQL والمتغير DATABASE_URL: تذكر وثائق المفاتيح الافتراضية أنها ضرورية لتوليد المفاتيح، ويعتمد تتبّع الإنفاق على القاعدة نفسها. الصيغة المتوقعة هي postgresql://<user>:<password>@<host>:<port>/<dbname>.
الخطوة 1 — الإعلان عن النماذج وتفعيل المقاييس
يسرد ملف الإعداد النماذج المعروضة ومفتاحًا رئيسيًا ودوال callbacks. تجمع اللقطة أمثلة من صفحتي «configs» و«prometheus» في الوثائق؛ وأسماء النماذج مأخوذة من الوثائق وهي وهمية.
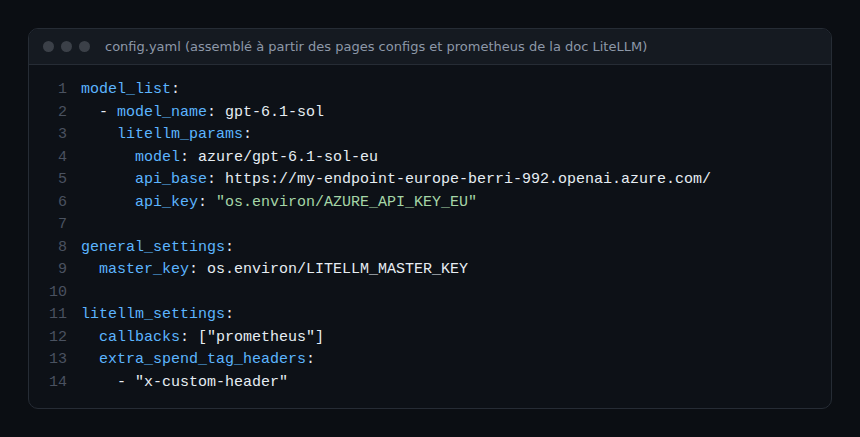
أسطر تستحق التذكّر:
- يقرأ
master_keyقيمته من البيئة (البادئةos.environ/): لا مفتاح بنص صريح في الملف. - يفعّل
callbacks: ["prometheus"]نقطة النهاية/metricsعلى منفذ الوكيل. - يحوّل
extra_spend_tag_headersترويسة في الطلب (هناx-custom-header) إلى وسم للإنفاق، مثلًا لمعرّف مشروع.
التشغيل، بحسب الوثائق:
export DATABASE_URL="postgresql://user:password@localhost:5432/litellm"
litellm --config /path/to/config.yaml
الخطوة 2 — إنشاء مفتاح لكل فريق مع ميزانية
يُنسب الإنفاق إلى المفتاح الافتراضي ثم إلى مستخدمه وفريقه. تعطي الوثائق الاستدعاء /key/generate مع المفتاح الرئيسي في الترويسة Authorization؛ ويظهر max_budget وbudget_duration بوصفهما معاملَي طلب، لكن ليس في مثال واحد:
curl 'http://0.0.0.0:4000/key/generate' \
  --header 'Authorization: Bearer <your-master-key>' \
  --header 'Content-Type: application/json' \
  --data-raw '{"models": ["gpt-6.1-sol"], "max_budget": 10, "budget_duration": "30d", "metadata": {"user": "equipe-plateforme"}}'
القيمتان 10 و30d مثالان يجب تكييفهما، واسم النموذج هو الوارد في الوثائق. وهكذا يحصل كل تطبيق أو فريق على مفتاحه الخاص: وهذا ما يجعل الإنفاق مقروءًا. انتبه إلى ملاحظة الوثائق: يُسجَّل المعامل user في الطلب بوصفه المستخدم النهائي، لكنه لا يغيّر إجماليات مالك المفتاح. ولتتبّع موثوق لكل مستخدم يجب ملء user_id عند إنشاء المفاتيح.
الخطوة 3 — وسم الطلبات
يكتب كل استدعاء سطرًا في الجدول LiteLLM_SpendLogs: المفتاح المجزَّأ (hash) والمستخدم والفريق والوسوم والنموذج والإنفاق وعدد الرموز. تُمرَّر الوسوم لكل طلب عبر metadata.tags، أو لكل مفتاح أو فريق عند إنشائه، أو عبر ترويسة مع extra_spend_tag_headers. وتحمل الاستجابة أيضًا التكلفة المحسوبة في الترويسة x-litellm-response-cost. لإعادة قراءة السطور: GET /spend/logs (مع summarize=false للتفاصيل) أو GET /spend/logs/v2 المقسّم إلى صفحات، وتشير وثائقه إلى إجمالي محدود بـ 10 000.
كيف تتحقق من أن كل شيء يعمل
بعد بضعة طلبات، استعلم عن نقطة نهاية المقاييس. توضح الوثائق أنه منذ الإصدار 1.85.0 يتطلب /metrics افتراضيًا مفتاح API من LiteLLM: أضف كتلة authorization من نوع Bearer إلى إعداد scrape في Prometheus. وتسرد صفحة المرجع ما يلي، من بين أمور أخرى:
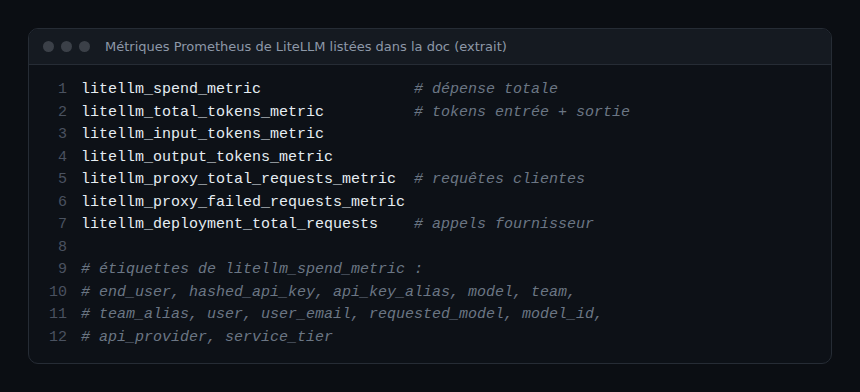
تذكر الصفحة أن هذه العدّادات يُستعلم عنها باللاحقة _total في استعلامات PromQL. استعلام مفيد لفريق المالية الداخلي، يجب التحقق منه على نسختك: مجموع litellm_spend_metric_total مجمّعًا حسب team_alias وmodel، على نافذة 24 ساعة. كما يشير العدّاد litellm_zero_cost_requests_total إلى الطلبات التي استهلكت رموزًا دون تسعير: فالنموذج الغائب عن جدول الأسعار سيشوّه إجمالياتك بصمت لولا ذلك.
مقاييس الإنفاق غير موسومة بـ«enterprise» في الصفحة المقروءة، بخلاف مقاييس الدفعات المُدارة. والوسوم (team وapi_key_alias وmodel وuser_email…) كثيرة: راقب كاردينالية Prometheus لديك قبل تفعيلها جميعًا، انظر OpenTelemetry وPrometheus.
Helicone: التتبّع عبر الترويسات
مع Helicone يقتصر الإعداد من جهة العميل على تغييرين: عنوان URL الأساسي والمفتاح. وتمرّ أبعاد التكلفة عبر ترويسات: Helicone-User-Id المخصصة للتتبّع لكل مستخدم، وHelicone-Property-[Name] لأي خاصية مخصصة، مثل البيئة أو التطبيق.
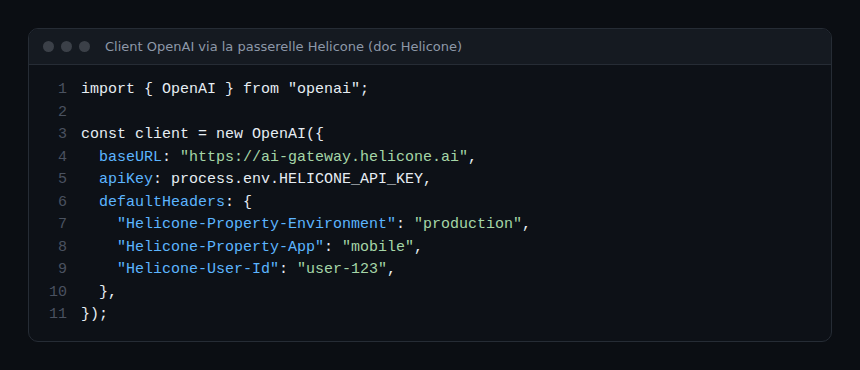
تزعم وثائق البوابة أنها تتتبّع الاستخدام والتكاليف والأداء لدى جميع المزوّدين في لوحة واحدة، وتعلن هامشًا قدره 0 % على الرموز مع رصيدها، مقابل 5,5 % لدى OpenRouter: هذه الأرقام من الناشر ولم يُتحقق منها هنا. وتشير صفحة مجاورة مخصصة لوضع الوكيل القديم (gateway.helicone.ai مع الترويسة Helicone-Target-Url) إلى أن تسعير التكاليف غير مدعوم لدى عدة مزوّدين، منهم AWS Bedrock وCohere. قبل اعتماد أحدهما، تحقق من أن مزوّديك ونماذجك مشمولون.
وماذا عن التتبّع في OpenTelemetry وDynatrace؟
تتيح وثائق LiteLLM دالة callback باسم otel: callbacks: ["otel"]، مع متغيرات بيئة. ولمجمّع OTLP عبر HTTP تستخدم الصفحة OTEL_EXPORTER_OTLP_ENDPOINT وOTEL_EXPORTER_OTLP_PROTOCOL وOTEL_EXPORTER_OTLP_HEADERS. لا تقدّم الصفحة إعدادًا كاملًا: اختبره قبل الاعتماد عليه. ويتطلب التصدير عبر gRPC الحزمة grpcio.
في Dynatrace SaaS، تعطي وثائق تصدير OTLP العنوان الأساسي https://{id-environnement}.live.dynatrace.com/api/v2/otlp مع المسارات /v1/traces و/v1/metrics و/v1/logs. وتوضح أن gRPC غير مدعوم وأن الصيغة هي Protobuf ثنائية؛ وتوصي باستخدام Collector للتحويل. يُمرَّر الرمز المميز بصيغة Authorization=Bearer؛ وصلاحيات الاستيعاب التي تسردها الصفحة من عائلة openpipeline:…:ingest، ويجب التحقق منها في وثائق الرموز المميزة لإصدارك. أما بالنسبة إلى Managed، فلا تعطي هذه الصفحة أي عنوان URL: ارجع إلى وثائق Managed. لم يُعثر على أي تكامل مع Dynatrace خاص بـLiteLLM أو Helicone في الصفحات المقروءة؛ والموثّق هو OTLP فقط.
لذلك فالمسار الأكثر أمانًا هو بوابة ← OpenTelemetry Collector ← Dynatrace. ولربط الرموز والتكاليف بتتبعات وكيل، انظر تكلفة وكيل ذكاء اصطناعي مع OpenTelemetry، ولنفس دور نقطة التحكم على أدوات MCP انظر agentgateway. وإذا كان التتبّع التفصيلي للـ prompts أهم من الإنفاق، فإن Langfuse وOpenLLMetry يلبّيان حاجة أخرى.
أفضل الممارسات
- مفتاح افتراضي لكل تطبيق ولكل فريق: وبدونه لا يُنسب الإنفاق إلى أحد.
- حدّد ميزانية لكل مفتاح منذ البداية، ونبّه قبل بلوغ السقف بدل التنبيه عند رفض الطلبات (فبلوغ الميزانية يقطع خدمة: إنه خطر على التوافر، لا على التكلفة فحسب).
- اقصر وسوم المقاييس على ما تحتاجه: غالبًا ما يكفي الفريق والنموذج.
- راقب الطلبات ذات التكلفة الصفرية: فالنموذج غير المسعَّر يشوّه التتبّع.
- تعامل مع البوابة بوصفها مكوّنًا حرجًا: فهي تصبح نقطة مرور واحدة، وبالتالي نقطة عطل واحدة. وفّر نسخًا متماثلة (replicas)، وتنبيهًا على معدل الفشل (
litellm_proxy_failed_requests_metric)، وإصدارًا مثبّتًا. - لا تسجّل الـ prompts دون سياسة احتفاظ: فهي تحتوي غالبًا على بيانات شخصية.
الأسئلة الشائعة
هل تحلّ بوابة LLM محل قابلية ملاحظة التطبيق؟
لا. فهي تعدّ الرموز والتكاليف والأخطاء على مستوى استدعاءات النماذج. ولا تقول شيئًا عن بقية طلب المستخدم: تبقى تتبعات التطبيق ضرورية لتحديد موضع الكمون.
LiteLLM أم Helicone لتتبّع التكاليف؟
بحسب وثائقهما، يُستضاف LiteLLM ذاتيًا مع PostgreSQL الخاصة بك ويعرض مقاييس Prometheus؛ ويُستخدم Helicone بتغيير العنوان والترويسات مع لوحته. ويتوقف الاختيار على المكان الذي تريد حفظ البيانات فيه وعلى تغطية مزوّديك.
هل يمكن إرسال هذه البيانات إلى Dynatrace؟
عبر OTLP فقط، بحسب الصفحات المقروءة، وليس عبر gRPC مباشر: مرّر البيانات عبر Collector يحوّلها إلى OTLP/HTTP. ولا يوجد موصّل مخصص موثّق.
الخلاصة
تمنح بوابة LLM أخيرًا بُعدَي «الفريق» و«التطبيق» لتكاليف النماذج، بشرط إنشاء مفاتيح منفصلة ووسم الطلبات وتدقيق تسعير الرموز. يندمج LiteLLM بطبيعته مع حزمة Prometheus، أما Helicone فيُوصَل أسرع لكنه ينقل البيانات. المصادر: مقاييس Prometheus في LiteLLM وتتبّع الإنفاق في LiteLLM وبوابة Helicone وتصدير OTLP إلى Dynatrace.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة BerriAI ولا لـHelicone. العلامات المذكورة تعود إلى مالكيها. الأدوات تتطور بسرعة: تحقق دائمًا من الأوامر والخيارات في وثائقها الرسمية.