Le tail-based sampling APM Server décide de conserver ou non une trace après l’avoir vue en entier, ce qui permet de garder toutes les erreurs et de réduire le reste. Selon la documentation Elastic, la décision est prise à la fin de la trace, et non à son début comme avec le head-based sampling.
Ce guide se concentre sur les réglages qui font mal quand on les ignore : interval, ttl, storage_limit et le comportement en cas de saturation du disque. Il complète notre article sur le tail sampling OpenTelemetry avant Dynatrace, qui traite l’approche Collector. Ici, tout se passe dans APM Server, côté Elastic.
Toutes les valeurs ci-dessous viennent des pages de configuration et de présentation du tail-based sampling de la documentation Elastic (version « current » consultée le 30 octobre 2026), sauf mention contraire.
En bref
- Le tail-based sampling d’APM Server ne fonctionne qu’avec une sortie Elasticsearch et demande des privilèges renforcés.
- Les événements attendent leur décision sur le disque local, pas en mémoire : le stockage et le TTL sont les deux réglages critiques.
- Par défaut,
ttlvaut30m,interval1metstorage_limit0GB(jusqu’à 80 % du disque). - Saturation : par défaut, les événements sont indexés sans échantillonnage, ce qui peut surcharger Elasticsearch.
Tail-based sampling APM Server : principe et prérequis
Avec le head-based sampling, chaque transaction est tirée au sort dès son début, sans savoir si elle échouera. Avec le tail-based sampling, APM Server garde les événements d’une trace en attendant la fin de la transaction racine, puis applique des politiques. La documentation précise que l’échantillonnage est aléatoire pondéré : les traces dont la transaction racine dure plus longtemps ont plus de chances d’être retenues. Les métriques sont calculées sur tous les événements, échantillonnés ou non, et les erreurs sont conservées quelle que soit la décision.
Prérequis cités par la documentation : une sortie Elasticsearch (les autres sorties ne sont pas prises en charge), des privilèges renforcés accordés par un rôle dédié, et une disponibilité sur la Elastic Stack (pas sur Elastic Cloud Serverless). Les agents Elastic APM et les SDK OpenTelemetry sont concernés ; pour OpenTelemetry, la documentation recommande ce mécanisme plutôt que le tailsamplingprocessor en raison des limites de ce dernier.
Écrire les politiques d’échantillonnage
Une politique doit avoir un sample_rate entre 0 et 1. Les conditions facultatives sont trace.name (nom de la transaction racine), trace.outcome (success, failure ou unknown), service.name et service.environment. Les politiques sont évaluées dans l’ordre, toutes les conditions d’une politique doivent correspondre, et la liste doit se terminer par une politique qui ne définit que sample_rate. Sans elle, une transaction qui ne correspond à rien est rejetée avec l’erreur « no matching policy ».
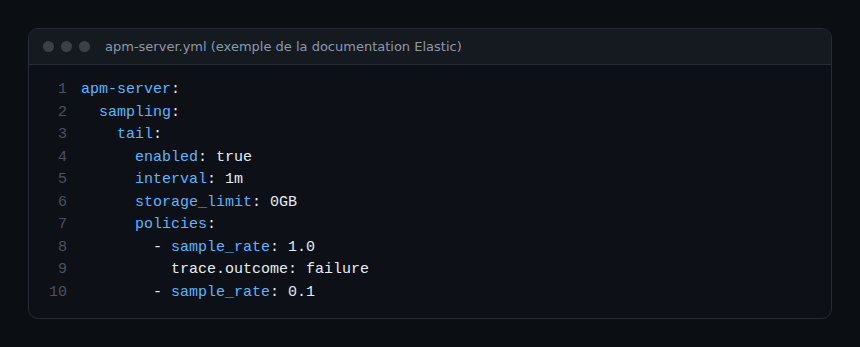
Cet exemple de la documentation garde toutes les traces en échec et 10 % des autres. Les règles s’appliquent par trace, selon le service qui l’a démarrée, et non selon un service ou un span individuel.
Régler interval, TTL et storage_limit
Étape 1 : interval
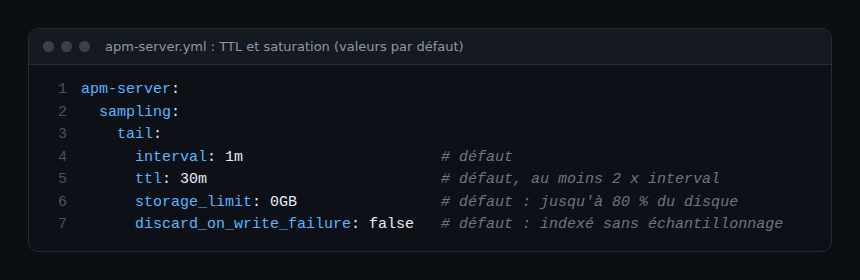
apm-server.sampling.tail.interval (défaut 1m) est l’intervalle de synchronisation entre plusieurs APM Server. La documentation recommande quelques dizaines de secondes à quelques minutes. Envoyez tous les services d’une trace vers le même cluster APM Server : si la transaction racine n’arrive jamais, les événements sont perdus silencieusement.
Étape 2 : TTL
apm-server.sampling.tail.ttl (défaut 30m) fixe combien de temps les événements attendent une décision dans le stockage local. Il doit valoir au moins deux fois l’interval. Si le TTL expire avant la décision, l’événement est supprimé sans être indexé. Un TTL plus long exige plus de disque. Dans Fleet, le champ TTL apparaît à partir de la version 9.1.
Étape 3 : storage_limit
apm-server.sampling.tail.storage_limit (défaut 0GB) : à zéro, APM Server peut utiliser jusqu’à 80 % du disque qui porte la base d’échantillonnage. Une valeur en GB plafonne l’usage. Depuis la version 9.0.0, la limite de stockage est illimitée par défaut mais l’écriture s’arrête à 80 % d’occupation, et l’usage réel peut légèrement dépasser la limite.
Comportement en saturation du stockage
Quand le disque est plein, APM Server journalise « configured limit reached ». Ensuite, tout dépend de discard_on_write_failure :
false(défaut) : les événements sautent l’échantillonnage et sont indexés tout de suite danstraces-apm-*. Le taux effectif devient 100 %, ce qui peut surcharger Elasticsearch.true: les événements sont supprimés. La charge d’indexation reste bornée, mais des traces sont perdues et peuvent apparaître incomplètes.
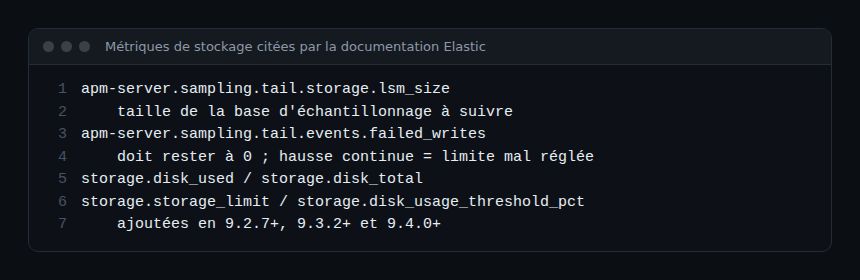
Le choix est un arbitrage d’équipe plateforme : protéger Elasticsearch ou protéger l’exhaustivité des traces. Les versions 9.2.7+, 9.3.2+ et 9.4.0+ ajoutent un seuil d’usage disque : au-delà, les nouvelles écritures sont rejetées et ce comportement s’applique. Selon la documentation, le disque doit être rapide (SSD à fort IOPS), car les écritures croissent avec le débit d’ingestion.
Surveiller et dimensionner
Activez la supervision d’APM Server et suivez lsm_size pour l’occupation. Le compteur failed_writes doit rester à 0 ; une hausse continue indique une limite mal réglée. Pensez aussi à l’erreur « too many open files » : vérifiez LimitNOFILE sous systemd ou ulimit -n. Pour comprendre pourquoi garder les traces rares malgré le volume, voir observabilité et monitoring.
Ce que cela change pour une équipe SRE
Le tail-based sampling déplace le coût du réseau vers le disque : dimensionner le stockage devient une tâche d’exploitation. Les approches diffèrent selon l’outil : dans le Collector OpenTelemetry, le tailsamplingprocessor garde les spans en mémoire (decision_wait de 30 s et num_traces de 50 000 par défaut selon son README) et exige que tous les spans d’une trace arrivent sur la même instance, voir notre guide du Collector sur Kubernetes. Pour une vue d’ensemble côté éditeurs, lisez le comparatif Dynatrace et Datadog. Nous n’affirmons aucune intégration entre APM Server et Dynatrace.
Bonnes pratiques
- Terminez toujours la liste par une politique
sample_rateseule. - Gardez le TTL à au moins deux fois l’intervalle, et chiffrez le disque nécessaire avant de l’allonger.
- Décidez à l’avance de
discard_on_write_failure, puis alertez surfailed_writes. - Testez sur un environnement non critique avant la production.
Questions fréquentes
Quelle est la valeur par défaut du TTL en tail-based sampling ?
Selon la documentation Elastic, apm-server.sampling.tail.ttl vaut 30m, avec un minimum de deux fois l’intervalle.
Que se passe-t-il quand le stockage est plein ?
Par défaut, les événements sont indexés sans échantillonnage, ce qui peut surcharger Elasticsearch. Avec discard_on_write_failure: true, ils sont supprimés.
Le tail-based sampling fonctionne-t-il avec une autre sortie qu’Elasticsearch ?
Non, la documentation indique qu’il n’est pris en charge qu’avec la sortie Elasticsearch.
Sources
- Transaction sampling, documentation Elastic
- Tail-based sampling configuration, documentation Elastic
- Tail sampling processor, OpenTelemetry
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les valeurs viennent de la documentation Elastic, à vérifier pour votre version.