Las recording rules de Prometheus precalculan una expresión PromQL a intervalos regulares y guardan el resultado como una nueva serie. Un panel o una alerta lee entonces esa serie ya preparada, en lugar de recalcular una agregación costosa en cada visualización. Este artículo muestra cómo escribir estas reglas, nombrarlas según la convención level:metric:operations, probarlas con promtool y revisarlas desde un enfoque SRE.
La necesidad aparece pronto: un SLI de tasa de errores calculado sobre cientos de instancias, mostrado en diez paneles y evaluado por tres alertas, repite diez veces el mismo trabajo. Una regla de registro lo hace una sola vez, con un nombre que todo el equipo entiende. El tema complementa la recopilación de métricas de Prometheus en Kubernetes, que trata de la ingesta más que del cálculo.
En resumen
- Una recording rule es un par
record(nombre de la nueva serie) yexpr(expresión PromQL), dentro de un grupo evaluado a intervalo fijo. - La convención oficial de nombres es
level:metric:operations: nivel de agregación, métrica de origen, operaciones aplicadas. - Se agregan siempre el numerador y el denominador por separado y después se divide; nunca se promedia un ratio.
promtool check rulesvalida la sintaxis ypromtool test rulesverifica los resultados sobre series fabricadas.
Por qué usar recording rules de Prometheus
Una consulta como sum(rate(http_requests_total[5m])) recorre todas las series implicadas en cada ejecución. En un clúster Kubernetes cargado, basta con unas decenas de paneles que la repitan para ralentizar la interfaz. Precalcular una vez por minuto traslada el coste a un único punto, predecible y medible.
El beneficio también es organizativo. Un nombre estable como path:http_requests:rate5m se convierte en un contrato: las alertas, los paneles y los informes de SLO se apoyan en la misma definición del tráfico. Eso reduce el toil de revisión y las diferencias entre dos pantallas que no muestran la misma cifra. Para situar Prometheus respecto a OpenTelemetry, consulta OpenTelemetry vs Prometheus.
La estructura de un archivo de reglas
Según la documentación de Prometheus, los archivos de reglas son YAML y se cargan mediante el campo rule_files de la configuración. Un grupo lleva un name obligatorio y único dentro del archivo, un interval opcional (por defecto global.evaluation_interval) y una lista rules. Una recording rule contiene record, un nombre de métrica válido, expr, una expresión PromQL, y labels opcionales que se añaden o sobrescriben en cada resultado almacenado.
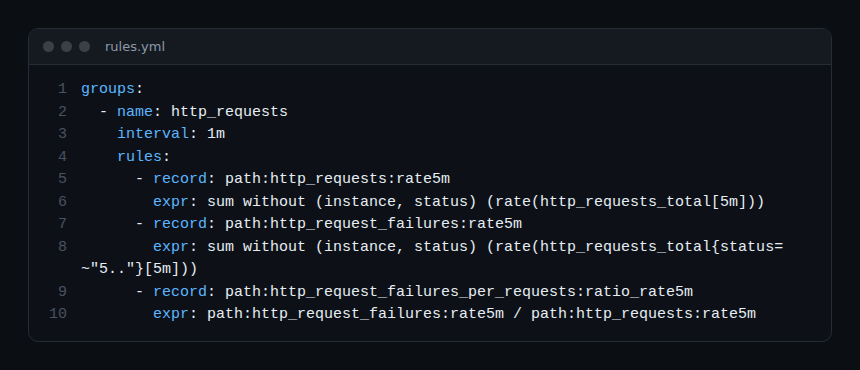
Este es un archivo de tres reglas que calcula el tráfico, los fallos y el ratio de fallos por ruta.
groups:
  - name: http_requests
    interval: 1m
    rules:
      - record: path:http_requests:rate5m
        expr: sum without (instance, status) (rate(http_requests_total[5m]))
      - record: path:http_request_failures:rate5m
        expr: sum without (instance, status) (rate(http_requests_total{status=~"5.."}[5m]))
      - record: path:http_request_failures_per_requests:ratio_rate5m
        expr: path:http_request_failures:rate5m / path:http_requests:rate5m
Las métricas http_requests_total y sus labels (instance, path, status) son aquí un ejemplo del artículo, no una métrica impuesta por Prometheus. El ratio reutiliza los nombres de las dos primeras reglas, lo que mantiene su expresión legible.
Nombrar con level:metric:operations
La página Recording rules de las buenas prácticas de Prometheus describe la forma general level:metric:operations.
- level: el nivel de agregación, es decir, los labels de la salida. Aquí
path. - metric: el nombre de la métrica, sin cambios, salvo que se quita
_totalde los contadores usados conrate()oirate(). Aquíhttp_requests_totalpasa a serhttp_requests. - operations: la lista de operaciones aplicadas, la más reciente primero. Aquí
rate5m.
La misma página añade algunas reglas: sin una operación evidente, usar sum; para un ratio, separar las dos métricas con _per_ y llamar a la operación ratio, de ahí path:http_request_failures_per_requests:ratio_rate5m. Las operaciones asociativas pueden fusionarse: min_min se escribe min.
Agregar con without en lugar de by
La documentación recomienda usar siempre una cláusula without que enumere los labels eliminados, para conservar labels como job. El nivel de salida solo debe diferir del nivel de entrada por los labels suprimidos: si los niveles no coinciden, es señal de error. El prefijo path del nombre de la regla recuerda qué labels permanecen junto a job.
No promediar nunca un ratio
Según la misma página, hay que agregar numerador y denominador por separado y luego dividir. Promediar ratios o promedios no es estadísticamente válido, porque una instancia que recibe poco tráfico pesaría tanto como una muy solicitada. Es exactamente lo que hace el archivo anterior.
Probar las reglas con promtool
Antes de cualquier despliegue, valida el archivo sin arrancar ningún servidor:
promtool check rules rules.ymlSegún la documentación, el comando muestra las reglas analizadas y devuelve el código 0 si tiene éxito; ante un error de sintaxis, escribe en stderr y devuelve 1. Ese código de retorno se integra directamente en un paso de integración continua.
Para verificar los valores, la página Unit testing for rules describe promtool test rules test.yml. El archivo de prueba declara las reglas que se cargan, las series de entrada y las muestras esperadas. La notación 0+90x10 genera una serie que empieza en 0 y aumenta 90 en cada uno de los 10 pasos.
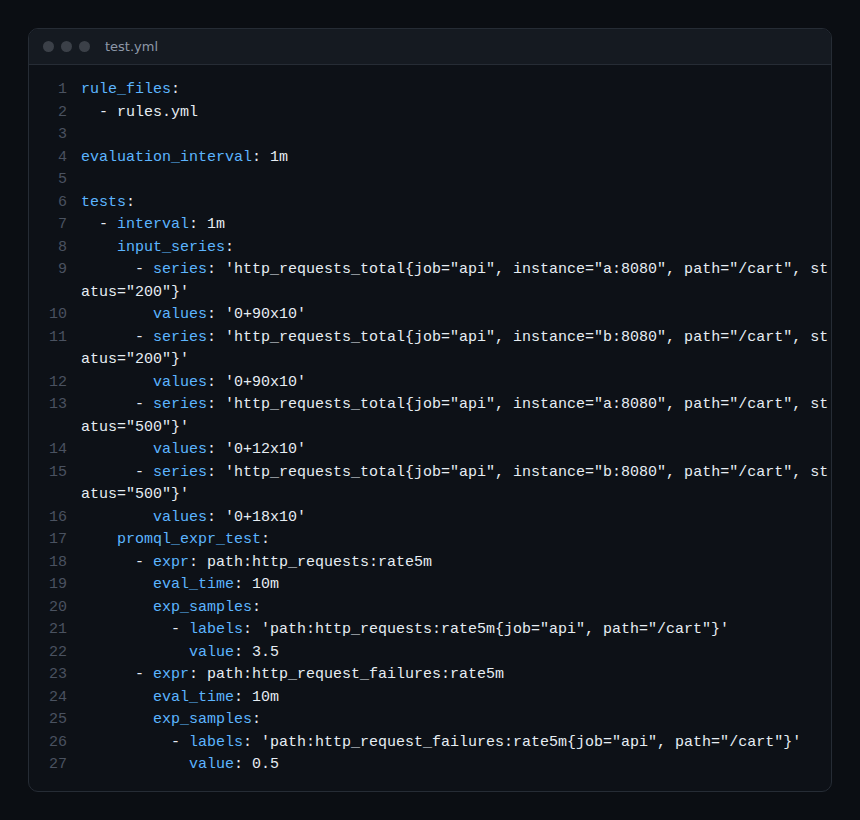
Los valores esperados (3,5 peticiones por segundo en total, 0,5 con fallo) resultan de un cálculo a mano: 90 peticiones por minuto y por instancia con éxito, es decir, 1,5 por segundo, dos instancias, más 12 y 18 por minuto con error. Este archivo no se ejecutó para este artículo: ejecútalo en tu entorno y corrige el valor esperado si tu versión de Prometheus extrapola de otra forma.
Recargar y vigilar las reglas
Para recargar los archivos en caliente, la documentación indica enviar SIGHUP al proceso de Prometheus; los cambios solo se aplican si todos los archivos de reglas están bien formados. Hay un punto de atención en cuanto a fiabilidad: si un grupo no ha terminado su evaluación antes de la siguiente, esta se omite y la serie registrada presenta un hueco. El contador rule_group_iterations_missed_total aumenta con cada iteración perdida. Crea una alerta sobre él, porque un SLI con huecos distorsiona el consumo del error budget. Para los SLO, consulta la comparativa de SLO con Prometheus.
Buenas prácticas
- Un grupo por tema (tráfico, latencia, saturación) y un
intervaladaptado a la ventana de la consulta. - Un nombre conforme a
level:metric:operationspara cada regla, sin abreviaturas propias. - Pruebas
promtool test rulesen el repositorio, ejecutadas en CI junto concheck rules. - Pocas reglas, dirigidas a las consultas pesadas y reutilizadas: cada regla crea nuevas series que almacenar.
- Una alerta sobre las evaluaciones perdidas.
Preguntas frecuentes
¿Cuál es la diferencia entre una recording rule y una alerting rule?
Ambas viven en un grupo de reglas. La recording rule almacena el resultado de una expresión en una nueva serie; la alerting rule evalúa una condición y dispara alertas. Una alerta puede apoyarse en una serie registrada.
¿Debo respetar la convención de nombres?
Prometheus no la impone: record acepta cualquier nombre de métrica válido. La convención procede de las buenas prácticas oficiales y hace que las series se lean de un vistazo, lo que importa durante una guardia.
¿Se pueden usar estas series con OpenTelemetry o Dynatrace?
Una serie registrada sigue siendo una métrica de Prometheus normal. Para transportarla a otra plataforma, sigue el método descrito en este artículo sobre Prometheus y Kubernetes y comprueba en la documentación de la plataforma de destino el tratamiento de contadores y gauges. Las reglas en sí las sigue evaluando Prometheus.
Conclusión
Las recording rules de Prometheus sacan las agregaciones costosas de los paneles y dan a los SLI un nombre estable. Aplica level:metric:operations, agrega con without, divide después de agregar, prueba con promtool y vigila las iteraciones perdidas. La diferencia entre observabilidad y simple monitorización, que motiva este trabajo sobre los SLI, se detalla en este artículo.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Prometheus es un proyecto de la Cloud Native Computing Foundation. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.