التنبيه على الأعراض بدل الأسباب يعني إيقاظ شخص ما حين يتأثر المستخدمون، لا حين يتجاوز مؤشر داخلي عتبة معيّنة. يصوغ كتاب Google SRE هذا الفرق هكذا: يجب أن تجيب المراقبة عن سؤالين، «ما المعطّل؟» (العرض) و«لماذا؟» (السبب). وبحسب الكتاب، ينبغي أن يتعلق التنبيه الذي يرنّ بالسؤال الأول.
يقترح هذا الدليل طريقة لفرز التنبيهات الحالية، وإعادة كتابة التي تنبّه على سبب، والإبقاء على الأسباب عونًا للتشخيص. وهو يكمّل مقال تقليل ضجيج التنبيهات مع Davis الذي يركّز على ضبط أداة بعينها: هنا تسبق قاعدة التصميم الأداة.
باختصار
- العرض يُعاش من جهة المستخدم: أخطاء HTTP 500 وصفحات بطيئة ومدفوعات مرفوضة. أما السبب فيُقرأ من جهة النظام: قاعدة بيانات ترفض الاتصالات أو معالج مشبع أو قرص يكاد يمتلئ.
- بحسب كتاب Google SRE، من الأفضل «بذل جهد أكبر بكثير في التقاط الأعراض مقارنةً بالأسباب».
- الأسباب لا تختفي: مكانها لوحات المراقبة والتذاكر وروابط التعليقات، لا جهاز الاستدعاء (pager).
- التنبيه على معدل استهلاك ميزانية الأخطاء (burn rate) هو أكمل صور التنبيه على الأعراض.
التنبيه على الأعراض: الفرق بين العرض والسبب
يعطي كتاب Monitoring Distributed Systems مثالين. «أُعيد أخطاء HTTP 500 أو 404» عرض. «خوادم قاعدة البيانات ترفض الاتصالات» سبب. ويضيف الفصل نفسه أن زاوية النظر مهمة: فقد يكون عرض فريق ما سببًا عند فريق آخر. وبالنسبة إلى الفريق المالك لقاعدة البيانات، فإن الاتصالات المرفوضة عرض فعلًا.
القاعدة العملية: ضع التنبيه أقرب ما يمكن إلى ما يشعر به مستخدم الخدمة، عند حدّ مسؤوليتك. في واجهة API يعني ذلك نسبة الأخطاء وزمن الاستجابة كما يراهما المستدعون. وفي طابور المعالجة يعني تأخر التسليم، لا الحجم الداخلي لمخزن مؤقت.
وتصوغ Prometheus الفكرة نفسها في ممارسات التنبيه: أبقِ التنبيه بسيطًا، ونبّه على الأعراض، ووفّر لوحات جيدة لتحديد الأسباب، وتجنّب الصفحات التي لا إجراء ممكنًا بعدها.
لماذا تُرهق التنبيهات على الأسباب المناوبة (on-call)
يطرح التنبيه على سبب ثلاث مشكلات. أولًا، هو ناقص: توجد عشرات الطرق لتعطيل خدمة، وكل قاعدة تغطي طريقة واحدة فقط. ثانيًا، هو مزعج: معالج عند 90 % لمدة دقيقة لا نتيجة مرئية له في الغالب. ثالثًا، هو مكرر: عطل في قاعدة البيانات يطلق أيضًا تنبيهات كل خدمة تابعة لها، فتتلقى المناوبة عشر صفحات عن حادثة واحدة.
يقترح كتاب Google SRE أسئلة تُطرح على كل قاعدة صفحة:
- هل تكشف حالة عاجلة وقابلة للتنفيذ لولاها لبقيت غير مكتشفة؟
- هل سأتمكن يومًا من تجاهلها لعلمي أنها غير مؤذية؟
- هل أستطيع التصرف استجابةً لها؟
- هل تدل بلا لبس على أن مستخدمين تأثروا؟
- هل نُبّه آخرون بالفعل بشأن المشكلة نفسها؟
التنبيه على سبب يفشل في السؤال الرابع تقريبًا دائمًا. هذا هو toil المناوبة: ردود آلية لا ينبغي، بحسب الفصل نفسه، أن تكون صفحات.
الخطوة 1: جرد التنبيهات وتصنيفها
صدّر قائمة القواعد التي ترسل إشعارًا إلى المناوبة. وسجّل لكل سطر ثلاثة أعمدة: ما تقيسه القاعدة، ومن يتلقاها، وآخر مرة أفضت فيها إلى إجراء. ثم صنّف كل قاعدة في إحدى ثلاث فئات.
- عرض يلمسه المستخدم: أخطاء أو زمن استجابة أو انقطاع أو تأخر معالجة. تبقى صفحة.
- سبب شديد الصلة بعرض مستقبلي: قرص سيمتلئ خلال أربع ساعات، أو شهادة توشك على الانتهاء. تصبح تذكرة أو تنبيهًا في ساعات النهار.
- سبب بلا صلة مثبتة: المعالج أو الذاكرة أو إعادة تشغيل معزولة لـ pod. تخرج من الـ pager وتغذّي لوحة مراقبة.
وتقرّ وثائق Prometheus نفسها بالحالة الوسطى: الوضع القريب من التشبّع لا أثر فوريًا له على المستخدم، لكنه «يتطلب غالبًا تدخلًا بشريًا» لتفادي عطل وشيك. هذه هي الفئة 2، وتستحق تذكرة لا إيقاظًا.
الخطوة 2: إعادة كتابة تنبيه سبب إلى تنبيه عرض
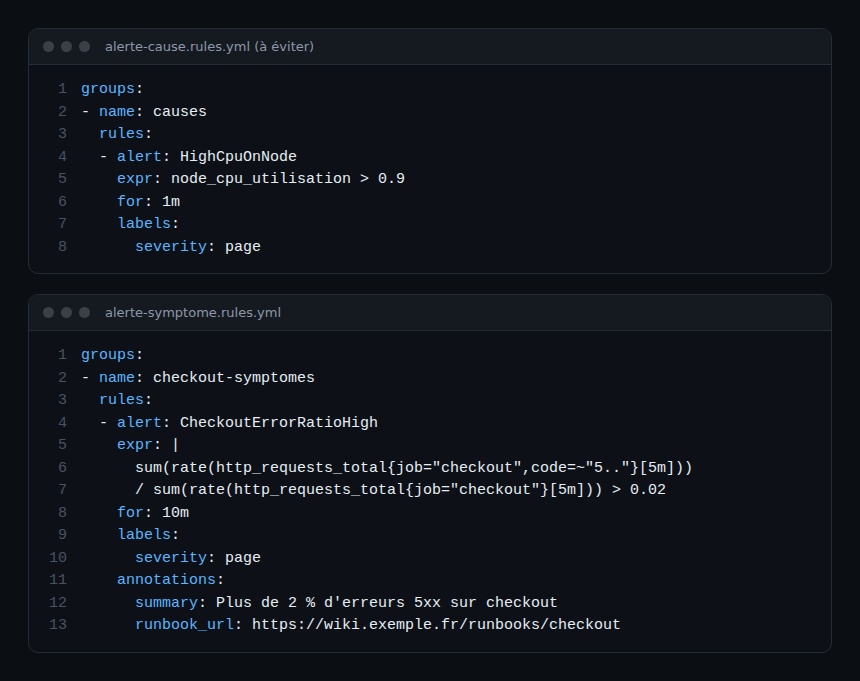
إليك الحاجة نفسها مكتوبة بطريقتين، في قواعد Prometheus. أسماء المقاييس وعناوين URL وهمية. والمفاتيح (alert وexpr وfor وlabels وannotations) مأخوذة من صفحة Alerting rules.
groups:
- name: checkout-symptomes
  rules:
  - alert: CheckoutErrorRatioHigh
    expr: |
      sum(rate(http_requests_total{job="checkout",code=~"5.."}[5m]))
      / sum(rate(http_requests_total{job="checkout"}[5m])) > 0.02
    for: 10m
    labels:
      severity: page
    annotations:
      summary: Plus de 2 % d'erreurs 5xx sur checkout
      runbook_url: https://wiki.exemple.fr/runbooks/checkout
ثلاثة خيارات مهمة هنا:
- الشرط يقوم على نسبة الأخطاء كما يراها المستدعون، لا على مورد داخلي. والعتبة 2 % مثال: تُضبط وفق SLO الخاص بك.
- البند
for: 10mيجعل Prometheus ينتظر بين أول ملاحظة وحالة «firing». وبحسب الوثائق، تكون العناصر النشطة التي لم تنطلق بعد في حالة «pending»، ودونforيُفعَّل التنبيه منذ أول تقييم. هذا هو الهامش الذي يمتص الهفوات الصغيرة. - التعليق
runbook_urlيشير إلى الإجراء. وتوصي Prometheus بأن يحيل التنبيه إلى لوحات تتيح العثور سريعًا على المكوّن المعطوب: هنا تستعيد الأسباب مكانها.
وبالنسبة إلى زمن الاستجابة، تنصح Prometheus بالتنبيه في موضع واحد فقط من الطبقات: «Only page on latency at one point in a stack». فتجنّب إذن تنبيه زمن استجابة لكل طبقة، وإلا أيقظ بطء في قاعدة البيانات أربع خدمات.
الخطوة 3: الإبقاء على الأسباب عونًا للتشخيص
إزالة الصفحة عن المعالج لا تزيل البيانات. احتفظ بالمقياس في لوحة مراقبة مرتبطة بتنبيه العرض. ويوصي كتاب Google SRE بالتقسيم نفسه: المراقبة بالصندوق الأسود تلتقط المشكلات الجارية، والمراقبة بالصندوق الأبيض تكشف الأسباب والأعطال الوشيكة. وإذا كنت تحسب نسبًا مكلفة مسبقًا فسمّها جيدًا باستخدام recording rules في Prometheus.
وتعطي الإشارات الذهبية الأربع في الكتاب نفسه (زمن الاستجابة وحركة المرور والأخطاء والتشبّع) نقطة انطلاق للأعراض التي تُغطّى أولًا. أما التشبّع فيبقى إشارة استباقية: عامله كتذكرة ما دام لم يمسّ المستخدم بعد. وللاطلاع على الفرق بين هذه الإشارات والاستكشاف الحر، راجع قابلية الملاحظة والمراقبة.
الخطوة 4: الانتقال إلى burn rate للصفحات
يدافع SRE Workbook عن التنبيهات المستمدة من SLO، لأنها تقيس الموثوقية «كما يعيشها عملاؤك». ويعرّف burn rate بأنه السرعة التي تستهلك بها الخدمة ميزانية أخطائها مقارنةً بـ SLO: معدل استهلاك 1 يستنفد الميزانية تمامًا في نهاية النافذة. وبالنسبة إلى SLO بنسبة 99,9 %، يوصي بدمج عدة نوافذ.
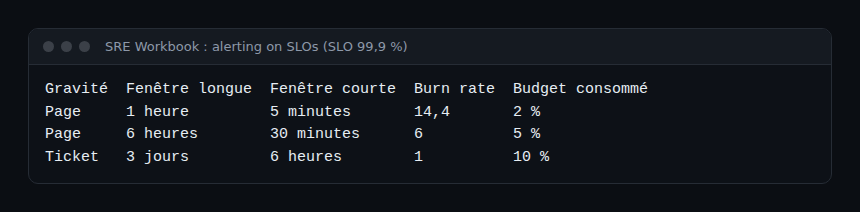
لا ينطلق التنبيه إلا إذا تجاوزت النافذتان العتبة. فالنافذة القصيرة، وهي نحو جزء من اثني عشر من الطويلة، تتحقق من أن الميزانية ما زالت تُستهلك، ويُغلق التنبيه سريعًا بعد الإصلاح. أما التنفيذ في Dynatrace فمفصّل في تنبيهات burn rate لـ SLO.
وماذا عن Dynatrace؟
يستند هذا الجزء إلى وثائق Dynatrace SaaS؛ ولم تُراجَع وثائق Managed لهذا المقال، ولا تُستنتج وظائفها منه. بحسب صفحة تطبيق Problems، تُنشأ مشكلة حين تُبلغ Dynatrace Intelligence عن مشكلات تطلقها حدث واحد أو أكثر. تُحفظ الأحداث المدمجة في الحقل dt.davis.event_ids، ويُشار إلى الكيان المعدّ سببًا جذريًا في العرض التفصيلي. ويسرد قسم «Impact» الكيانات المتأثرة.
عمليًا، تجمع المشكلة العرض والسبب المحتمل في سجل واحد، بينما تنتج تنبيهات العتبة لكل مقياس إشعارات بعددها. ولا تفصّل الوثائق التي قُرئت معايير التجميع: فلا تفترضها. ولتوجيه هذه المشكلات، راجع إنشاء تنبيه في Dynatrace.
كيف تتحقق من أن ذلك يعمل
- احسب عدد الصفحات أسبوعيًا قبل إعادة التصميم وبعدها. الهدف ليس الصفر، بل صفر صفحات بلا إجراء.
- أعد تشغيل ثلاث حوادث سابقة: هل كان تنبيه العرض سينطلق، وفي أي دقيقة؟ إن جاء متأخرًا فالنافذة أو العتبة فضفاضة جدًا.
- تأكد من أن كل صفحة تحمل رابطًا إلى runbook وإلى لوحة الأسباب المحتملة.
- عند مراجعة المناوبة، أعد قراءة كل صفحة واطرح الأسئلة الخمسة أعلاه. الإجابة «لا» تعني حذف القاعدة أو خفض مرتبتها.
أفضل الممارسات
- صفحة واحدة = مستخدم متأثر أو ميزانية أخطاء في خطر.
- تنبيه واحد، ومسؤول واحد، وrunbook واحد.
- الأسباب تغذّي لوحات المراقبة والتذاكر، لا الـ pager.
- قيّم القواعد دون لوم (blameless): الإيجابية الكاذبة عيب في القاعدة، لا في شخص.
- احتفظ بتنبيهات للأعطال غير المرئية للمستخدم فقط إن كانت تتطلب تدخلًا بشريًا، كما توضح Prometheus.
الأسئلة الشائعة
هل يجب حذف كل التنبيهات على المعالج أو الذاكرة؟
لا. أزلها من الـ pager لا من لوحات المراقبة. التشبّع الذي ينذر بعطل وشيك يستحق تذكرة، كما تقرّ وثائق Prometheus.
كيف أنبّه على عرض دون SLO محدد؟
ابدأ بنسبة الأخطاء وزمن الاستجابة كما يراهما المستدعون، مع بند for يمتص الهفوات. ثم حدّد SLO للانتقال إلى burn rate. وتصلح الإشارات الذهبية الأربع في كتاب Google SRE قائمة انطلاق.
ألا يصل العرض متأخرًا جدًا؟
يصل حين يتأثر المستخدم، وهذا هو المقصود. وللاستباق استخدم نوافذ burn rate (استهلاك سريع للميزانية ينبّه قبل نفادها) وعامل إشارات التشبّع كتذاكر.
الخلاصة
يعيد التنبيه على الأعراض تركيز الـ pager على الأثر ويترك الأسباب للتشخيص. والعمل متواضع: تصنيف القواعد، وإعادة كتابة الصفحات كنسب أخطاء وزمن استجابة، ثم الانتقال إلى burn rate. وتكسب المناوبة نومًا ويكسب الفريق ثقة بتنبيهاته.
المصادر
- Monitoring Distributed Systems, Google SRE book
- Alerting on SLOs, Google SRE Workbook
- Alerting، ممارسات Prometheus
- Alerting rules، وثائق Prometheus
- Problems، وثائق Dynatrace
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC. أسماء المنتجات المذكورة تعود إلى مالكيها، وأمثلة الشيفرة والمقاييس وعناوين URL وهمية وللأغراض التعليمية. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.