يتوقف دفعة (batch) الفوترة مساء الجمعة. لا يتشبع أي معالج (CPU) ولا تتباطأ أي خدمة، وليس لدى Davis ما يبلّغ عنه، لأن شيئًا غير طبيعي لا يظهر في المقاييس المدمجة. وفي يوم الاثنين يكون العملاء هم من ينبّهونك. لتفادي هذا السيناريو عليك أن تعرف كيف تنفّذ إنشاء تنبيه في Dynatrace على ما يهمك فعلًا: عتبة تخص عملك، أو مقياس مخصص، أو غياب البيانات نفسه.
يشرح هذا الدرس التطبيقي إنشاء تنبيه في Dynatrace من البداية إلى النهاية: تعريف metric event (عتبة ثابتة أو متكيفة أو خط أساس موسمي)، وتفعيل التنبيه عند فقدان البيانات (alert on missing data)، وكتابة رسالة حدث مفيدة، ثم توجيه الإشعار عبر Alerting profile. ويُختتم بنسخة «ككود» عبر Settings API وبطريقة للتحقق.
تصلح الخطوات لـ Dynatrace Managed ولبيئات Dynatrace SaaS التي ما زالت تستخدم metric events (وتُوسَم في الوثائق بـ «Dynatrace Classic»). في SaaS توصي Dynatrace الآن بالتنبيهات المخصصة (custom alerts) المبنية على DQL: يشرح القسم المخصص لذلك ما الذي يتغير.
ما يجب معرفته قبل إنشاء تنبيه في Dynatrace
يُبنى التنبيه في Dynatrace على مرحلتين، والخلط بينهما أول مصدر للضجيج:
- الكشف: يقيّم metric event مقياسًا كل دقيقة ويطلق حدثًا حين تُنتهك العتبة. يربط Davis هذا الحدث بكيان ويدمجه في مشكلة (Problems).
- الإشعار: يرشّح Alerting profile المشكلات (منطقة الإدارة، والخطورة، والمدة، والوسوم، والأحداث)؛ ويرسل تكامل (بريد إلكتروني أو Slack أو webhook…) مرتبط بهذا الملف الرسالة.
لـ metric events نوعان. النوع Metric key يقيّم القياسات الخام لمقياس واحد، بعتبة ثابتة فقط. أما النوع Metric selector فيقيّم استعلامًا كاملًا (تحويلات وتعبيرات بين المقاييس والسجل التاريخي) ويتيح الاستراتيجيات الثلاث: Static threshold وAuto-adaptive threshold وSeasonal baseline. نقطة مهمة: التنبيه عند فقدان البيانات غير متاح للنوع Metric key. إن أردت اكتشاف تدفق توقف، فابدأ من metric selector.
بعض الحدود التي يجب أن تبقى في بالك (وثائق Dynatrace Managed): 10 000 إعداد metric event لكل بيئة، و100 000 بُعد (dimension) مراقب لكل بيئة، و1 000 بُعد لكل إعداد (500 في seasonal baseline)، و100 metric selector لكل استراتيجية. كما يُحدّ metric event من نوع Metric key بـ 200 تنبيه متزامن.
المتطلبات
- بيئة Dynatrace Managed أو SaaS، مع صلاحية تعديل الإعدادات (مسؤول لإنشاء metric event دون منطقة إدارة).
- المقياس المراد مراقبته، ظاهرًا في Data Explorer. بالنسبة إلى مقياس يخص العمل، راجع إنشاء مقياس مخصص في Dynatrace.
- لجزء API: رمز بالنطاقين
settings.readوsettings.write.
درس تطبيقي: إنشاء تنبيه في Dynatrace عبر metric event
الخطوة 1: افتح صفحة Metric events
انتقل إلى Settings > Anomaly detection > Metric events. تبدأ الصفحة بنظرة عامة على الحدود المستهلكة وتسرد الإعدادات الفاشلة خلال الـ 24 ساعة الأخيرة مع حالة: THROTTLED (بلوغ حدود الاستعلام) أو QUERY_FAILED (اختفاء منطقة إدارة أو وسم، أو غياب البيانات، أو عدم توفر دقة الدقيقة الواحدة) أو CONFIG_BLOCKED (إعداد مكلف جدًا فحُجب). ألقِ نظرة عليها قبل إضافة تنبيه: الإعداد المحجوب لا يكشف شيئًا بعد الآن.
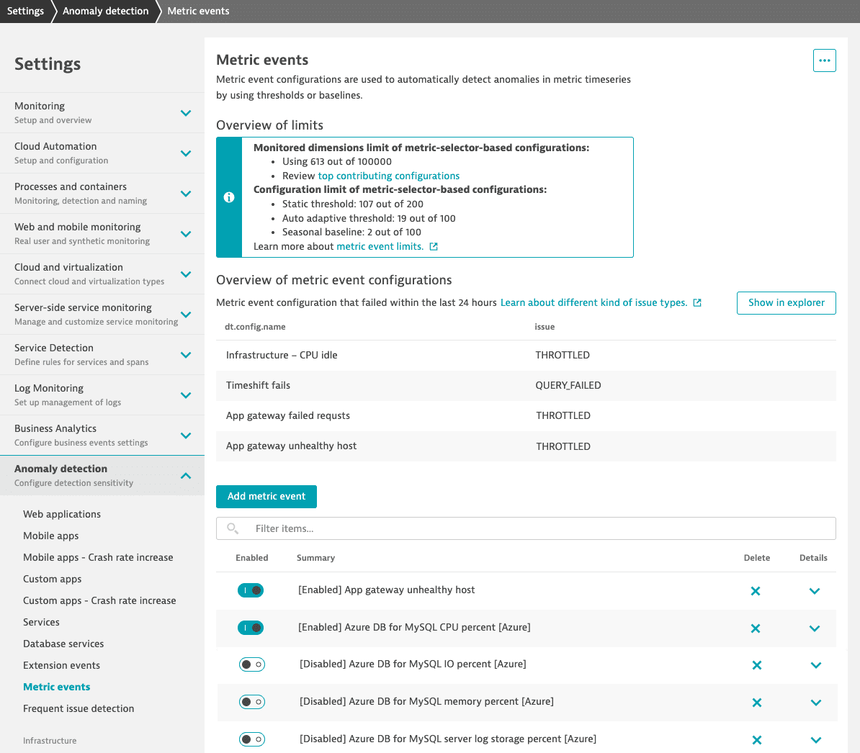
اختر Add metric event ثم املأ Summary: وصف قصير يسمح بالعثور على الإعداد بعد ستة أشهر («Batch facturation : exécutions manquantes»).
الخطوة 2: عرّف الاستعلام
في Query definition اختر النوع Metric selector وأدخل الاستعلام. مثال لدفعة ترسل نقطة عن كل تنفيذ عبر API الاستيعاب:
batchjob.executions:splitBy("dt.entity.host"):sum- Management zone: تحصر التقييم في بيانات هذه المنطقة. اتركها فارغة لتشمل البيئة كلها. مناطق الإدارة المعرَّفة بقواعد على البيانات متعددة الأبعاد غير مدعومة.
- Query offset (في Advanced query definition): إزاحة بالدقائق للمقاييس التي تصل متأخرة (مقاييس السحابة، والاستيعاب على دفعات). بدونها يرى metric event دقائق فارغة وينتج تنبيهات كاذبة.
مع النوع Metric key تختار المقياس بمفتاحه أو اسمه، ثم دالة تجميع، ويمكنك بعد ذلك إضافة entity filters (الاسم أو الوسم أو host group أو management zone…) وdimension filters، وتُجمع بالعامل «و» (AND).
الخطوة 3: اختر الاستراتيجية والعتبة
في Monitoring strategy اختر النموذج:
| الاستراتيجية | متى تُستخدم |
|---|---|
| Static threshold | حد مطلق معروف: معدل خطأ تعاقدي، أو أقصى طول لطابور، أو صفر تنفيذ. |
| Auto-adaptive threshold | مقياس يتطور مستواه الطبيعي؛ يحسب Dynatrace العتبة ويعدّلها. |
| Seasonal baseline | مقياس ذو نمط موسمي (حركة نهار/ليل، أسبوع/عطلة نهاية الأسبوع)؛ يحسب Dynatrace نطاق ثقة. |
بالنسبة إلى العتبة الثابتة، يقترح الخيار Use suggested threshold قيمة مبنية على السجل التاريخي: نقطة انطلاق جيدة تحتاج إلى مراجعة. ثم اختر الشرط: فوق العتبة أو دونها، أو، في metric selector، خارج (outside) النطاق.
الخطوة 4: فعّل التنبيه عند فقدان البيانات (alert on missing data)
هذا هو الخيار الذي كان سينقذ دفعة الجمعة. عند تفعيله تُحتسب كل عيّنة مدتها دقيقة بلا بيانات عيّنةً منتهِكة؛ ويُجمع مع شرط العتبة بالعامل «أو» (OR). وعند تعطيله لا يُعدّ غياب البيانات انتهاكًا، لكنه يظل محتسبًا في إغلاق الحدث.
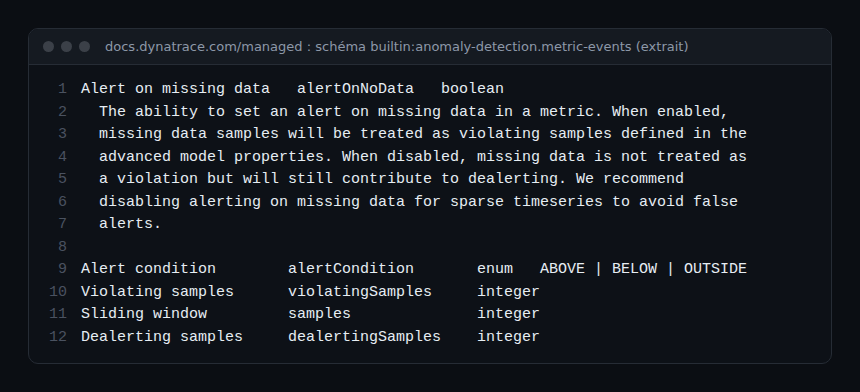
تقول الوثائق ذلك بوضوح: عطّل هذا الخيار في السلاسل المتفرقة (مقياس لا تكون له قيمة إلا عند حدوث خطأ مثلًا)، وإلا أطلقت كل دقيقة هادئة تنبيهًا. خصّصه للإشارات التي يُفترض أن تصل باستمرار: نبضة الحياة (heartbeat) وعدّاد تنفيذ مهمة متكررة ومقياس إضافة (extension). بالنسبة إلى دفعة كل 15 دقيقة، يجب أن تغطي النافذة المنزلقة أكثر من فترة واحدة (انظر الخطوة التالية).
الخطوة 5: اضبط النافذة المنزلقة
في Advanced model properties تتحكم ثلاث قيم في حساسية التنبيه:
- Violating samples (
violatingSamples): عدد العيّنات (مدة كل منها دقيقة) المنتهِكة اللازمة لإطلاق الحدث؛ - Sliding window (
samples): حجم النافذة، حتى 60 عيّنة؛ - Dealerting samples (
dealertingSamples): العيّنات التي عادت إلى الوضع الطبيعي لإغلاق الحدث.
لا يشترط أن تكون الانتهاكات متتالية. بالنسبة إلى الدفعة كل 15 دقيقة، تعني نافذة من 30 عيّنة مع اشتراط 30 انتهاكًا «لا تنفيذ منذ 30 دقيقة»، أي دورتان فائتتان. استخدم بعد ذلك المعاينة (preview) على يوم أو 3 أو 7 أيام: تُظهر كم حدثًا كان الإعداد سيطلق.
الخطوة 6: اكتب الرسالة واختر نوع الحدث
أعطِ Title قصيرًا («Batch facturation arrêté») وDescription يستفيد منها فريق المناوبة. العناصر النائبة (placeholders) المتاحة: {alert_condition} و{baseline} و{dims} (أو {dims:dt.entity.<entity>}) و{entityname} و{metricname} و{missing_data_samples} و{severity} و{threshold}. أدرج {missing_data_samples}: توصي به الوثائق للتمييز بين تنبيه ناتج عن بيانات مفقودة وانتهاك للعتبة.
Le batch {dims:dt.entity.host} n'a pas signalé d'exécution.
Échantillons sans donnée : {missing_data_samples}. Condition : {alert_condition} {threshold}.
Runbook : https://wiki.exemple.local/runbooks/batch-facturation
اختر Event type (مثل AVAILABILITY للتوقف، أو ERROR أو SLOWDOWN أو RESOURCE أو CUSTOM_ALERT): فهو يحدد خطورة المشكلة، وبالتالي قواعد Alerting profile التي تلتقطه. اترك Allow merge مفعّلًا ليربط Davis الحدث بمشكلة قائمة بدل فتح مشكلة جديدة. أضف عند الحاجة خصائص مفتاح-قيمة (الفريق، وrunbook)، ثم Save changes.
الخطوة 7: وجّه الإشعار عبر Alerting profile
انتقل إلى Settings > Alerting > Problem alerting profiles واختر Add alerting profile. يجمع النطاق بالعامل «و» منطقة إدارة وقواعد خطورة (severity rules، حتى 100 قاعدة تُجمع بالعامل «أو») ومرشحات أحداث (event filters، حتى 20). في حالتنا:
- منطقة الإدارة الخاصة بفريق الفوترة؛
- قاعدة خطورة: Availability، بمهلة 0 دقيقة؛
- مرشح حدث Custom: عنوان يبدأ بـ «Batch facturation».
الملف Default موجود دائمًا؛ يمكن تعديله لكن لا يمكن حذفه. اربط بعد ذلك تكاملًا من Problem notifications بملفك الجديد، لا بـ Default: راجع إرسال تنبيهات Dynatrace إلى Slack وTeams وملفات التنبيه والتكاملات.
إنشاء التنبيه نفسه عبر Settings API
التنبيه المنشأ بالنقر في الواجهة ينتهي بأن يتباين بين البيئات. يصف المخطط builtin:anomaly-detection.metric-events الحقول التي رأيناها أعلاه بدقة. مثال (في Managed: https://{votre-domaine}/e/{id-environnement}):
curl -s -X POST "https://{votre-domaine}/e/{id-environnement}/api/v2/settings/objects?validateOnly=true" \
  -H "Authorization: Api-Token {token}" -H "Content-Type: application/json" \
  -d '[{
  "schemaId": "builtin:anomaly-detection.metric-events",
  "scope": "environment",
  "value": {
    "enabled": true,
    "summary": "Batch facturation : exécutions manquantes",
    "queryDefinition": {
      "type": "METRIC_SELECTOR",
      "metricSelector": "batchjob.executions:splitBy(\"dt.entity.host\"):sum"
    },
    "modelProperties": {
      "type": "STATIC_THRESHOLD",
      "threshold": 1,
      "alertCondition": "BELOW",
      "alertOnNoData": true,
      "violatingSamples": 30,
      "samples": 30,
      "dealertingSamples": 5
    },
    "eventTemplate": {
      "title": "Batch facturation arrêté",
      "description": "Échantillons sans donnée : {missing_data_samples}",
      "eventType": "AVAILABILITY",
      "davisMerge": true
    }
  }
}]'
الخيار validateOnly=true يتحقق دون حفظ: احذفه حين تصل استجابة بلا أخطاء. لا يقبل المخطط للحقل alertCondition إلا ABOVE وBELOW وOUTSIDE. اجلب بعد ذلك المخطط الكامل لإصدارك (GET /api/v2/settings/schemas/builtin:anomaly-detection.metric-events) قبل الأتمتة. ولإدارة هذه الكائنات بالإصدارات، تؤدي Monaco أو Terraform العمل نفسه بملفات.
Dynatrace SaaS: metric events أم custom alerts؟
في SaaS تبقى metric events قابلة للاستخدام، لكن الوثائق تشجّع على الانتقال إلى التنبيهات المخصصة المبنية على DQL: فهي تستعلم من Grail ويمكنها التنبيه على السجلات أو الـ spans أو business events. منذ الإصدار 1.344 تُدار من Settings > Analyze and alert > Alerts > All alerts، تبويب Custom alerts (تطبيق Anomaly Detection مهجور). يأخذ الوضع Simple استعلام DQL (يوصى بـ interval: 1m) ومحلِّلًا وعتبة وقالب حدث؛ ويضيف الوضع Advanced الاختيار بين بيانات Timeseries وRecords، ومهلة تنفيذ من 1 إلى 60 دقيقة، والفاعل (مستخدم أو service user).
يحوّل الخيار Improve metric events with DQL metric event قائمًا: يُعطَّل الإعداد الأصلي تلقائيًا. انتبه: مناطق الإدارة غير مدعومة في هذه التنبيهات وتضيع عند التحويل. أما في Managed فلا شيء من ذلك موجود: تبقى metric events هي الأداة.
كيف تتحقق من أن كل شيء يعمل
- في محرر metric event، يجب أن تُظهر المعاينة على 7 أيام أحداثًا في اللحظات التي توقفت فيها الدفعة فعلًا، ولا أحداث في بقية الوقت.
- أوقف الدفعة في بيئة اختبار: بعد النافذة المختارة تظهر مشكلة في Problems بعنوانك وعدد العيّنات المفقودة في الوصف.
- في التكامل المرتبط بالملف، يؤكد Send test notification سلامة القناة؛ ثم يجب أن تصل المشكلة الحقيقية بالمحتوى نفسه.
- عد إلى صفحة Metric events في اليوم التالي: يجب ألا يظهر إعدادك في قائمة الإخفاقات (
THROTTLEDوQUERY_FAILED).
أفضل الممارسات
- تنبيه واحد = عَرَض واحد يراه المستخدم أو العمل؛ وتُقرأ الأسباب في مشكلة Davis.
- التنبيه عند فقدان البيانات للإشارات المستمرة فقط، وليس للسلاسل المتفرقة أبدًا.
- نافذة منزلقة مضبوطة على الفترة الفعلية للإشارة، ومؤكَّدة بالمعاينة.
- runbook في كل وصف؛ وخصائص مفتاح-قيمة للفريق المالك.
- ملفات تنبيه لكل فريق؛ ولا تكامل على الملف Default.
لتقليل حجم التنبيهات عمومًا بعد ذلك، راجع تقليل ضجيج تنبيهات Davis وإعدادات الحد من الإيجابيات الكاذبة.
الأسئلة الشائعة
لماذا لا يظهر خيار التنبيه عند فقدان البيانات؟
أنت في النوع Metric key. هذا الخيار موجود فقط لـ metric event من النوع Metric selector: غيّر نوع الاستعلام، ويمكن أن يبقى المقياس نفسه.
يطلق metric event الخاص بي تنبيهًا لكن لا أحد يتلقى إشعارًا. لماذا؟
نجح الكشف؛ أما الإشعار فيعتمد على Alerting profile. تحقق من أن الخطورة المقابلة لـ Event type المختار مغطاة بقاعدة خطورة، وأن المهلة ليست طويلة جدًا، وأن التكامل مربوط بهذا الملف.
هل أفضّل العتبة المتكيفة على العتبة الثابتة؟
ليس من حيث المبدأ. العتبة المتكيفة تتبع انجرافًا بطيئًا دون تنبيه، وهذا لا يناسب حدًا مطلقًا. احتفظ بالثابتة للحدود المعروفة، واستخدم المتكيفة أو seasonal baseline للمقاييس التي يتغير مستواها الطبيعي.
الخلاصة
إنشاء تنبيه مفيد في Dynatrace يقوم على قرارات قليلة: الاستعلام المناسب، والاستراتيجية المناسبة، ونافذة واقعية، والتنبيه عند فقدان البيانات حيث يكون الصمت حادثة، وملف يرسل المشكلة إلى الفريق الصحيح. يُقاس المكسب بمتوسط زمن الإصلاح (MTTR): تُكتشف دفعة الجمعة خلال 30 دقيقة بدل ثلاثة أيام.
المراجع: Metric selector events (وثائق Managed) وConfigure a simple custom alert (وثائق SaaS).
span.observer مدوّنة مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace وDavis علامتان تجاريتان لشركة Dynatrace LLC. المعلومات مأخوذة من الوثائق العامة؛ تحقق منها في إصدارك قبل أي تعديل في الإنتاج.