Alertar sobre síntomas en lugar de sobre causas significa despertar a alguien cuando hay usuarios afectados, y no cuando un indicador interno supera un umbral. El libro Google SRE plantea la distinción así: la supervisión debe responder a dos preguntas, «qué está roto» (el síntoma) y «por qué» (la causa). Según el libro, la alerta que suena debe referirse a lo primero.
Esta guía propone un método para clasificar las alertas existentes, reescribir las que avisan por una causa y conservar las causas como ayuda al diagnóstico. Complementa el artículo sobre la reducción del ruido con Davis, centrado en el ajuste de una herramienta: aquí la regla de diseño va antes que la herramienta.
En resumen
- Un síntoma se vive del lado del usuario: errores HTTP 500, páginas lentas, pagos rechazados. Una causa se lee del lado del sistema: base de datos que rechaza conexiones, CPU saturada, disco casi lleno.
- Según el libro Google SRE, conviene «dedicar mucho más esfuerzo a detectar los síntomas que las causas».
- Las causas no desaparecen: viven en paneles, tickets y enlaces de anotación, no en el pager.
- Una alerta sobre la tasa de consumo del presupuesto de errores (burn rate) es la forma más completa de alerta sobre síntomas.
Alertar sobre síntomas: la diferencia entre síntoma y causa
El libro Monitoring Distributed Systems da dos ejemplos. «Devuelvo HTTP 500 o 404» es un síntoma. «Los servidores de base de datos rechazan conexiones» es una causa. El mismo capítulo añade que el punto de vista importa: el síntoma de un equipo puede ser la causa de otro. Para el equipo propietario de la base de datos, las conexiones rechazadas sí son un síntoma.
La regla práctica: colocar la alerta lo más cerca posible de lo que siente quien usa el servicio, en el límite de su responsabilidad. En una API, eso es la tasa de errores y la latencia que ven quienes la llaman. En una cola de procesamiento, es el retraso de entrega, no el tamaño interno de un búfer.
Prometheus formula la misma idea en sus prácticas de alertas: mantener la alerta simple, alertar sobre síntomas, disponer de buenas consolas para localizar las causas y evitar las páginas sin acción posible.
Por qué las alertas sobre causas agotan a la guardia (on-call)
Una alerta sobre una causa plantea tres problemas. Primero, es incompleta: hay decenas de formas de romper un servicio y cada regla cubre solo una. Segundo, es ruidosa: una CPU al 90 % durante un minuto suele no tener ninguna consecuencia visible. Tercero, es redundante: una caída de la base de datos dispara también las alertas de cada servicio dependiente, y la guardia recibe diez páginas por un incidente.
El libro Google SRE propone preguntas que hacer a cada regla de página:
- ¿Detecta una condición urgente y accionable que de otro modo pasaría inadvertida?
- ¿Podré ignorarla alguna vez sabiendo que es inofensiva?
- ¿Puedo actuar en respuesta?
- ¿Indica sin ambigüedad que hay usuarios afectados?
- ¿Hay otras personas ya avisadas por el mismo problema?
Una alerta de causa casi siempre falla en la cuarta pregunta. Es el toil de la guardia: respuestas mecánicas que, según el mismo capítulo, no deberían ser páginas.
Paso 1: inventariar y clasificar las alertas
Exporte la lista de reglas que envían una notificación a la guardia. Para cada línea, anote tres columnas: qué mide la regla, quién la recibe y la última vez que condujo a una acción. Después clasifique cada regla en una de las tres categorías.
- Síntoma de usuario: errores, latencia, indisponibilidad, retraso de procesamiento. Sigue siendo una página.
- Causa con fuerte vínculo con un síntoma futuro: disco que estará lleno en cuatro horas, certificado que caduca. Pasa a ser un ticket o una alerta de horario diurno.
- Causa sin vínculo demostrado: CPU, memoria, reinicio aislado de un pod. Sale del pager y alimenta un panel.
La documentación de Prometheus admite ella misma el caso intermedio: una situación cercana a la saturación no tiene impacto inmediato en el usuario, pero «a menudo requiere intervención humana» para evitar una caída próxima. Es la categoría 2, que merece un ticket más que un despertar.
Paso 2: reescribir una alerta de causa como alerta de síntoma
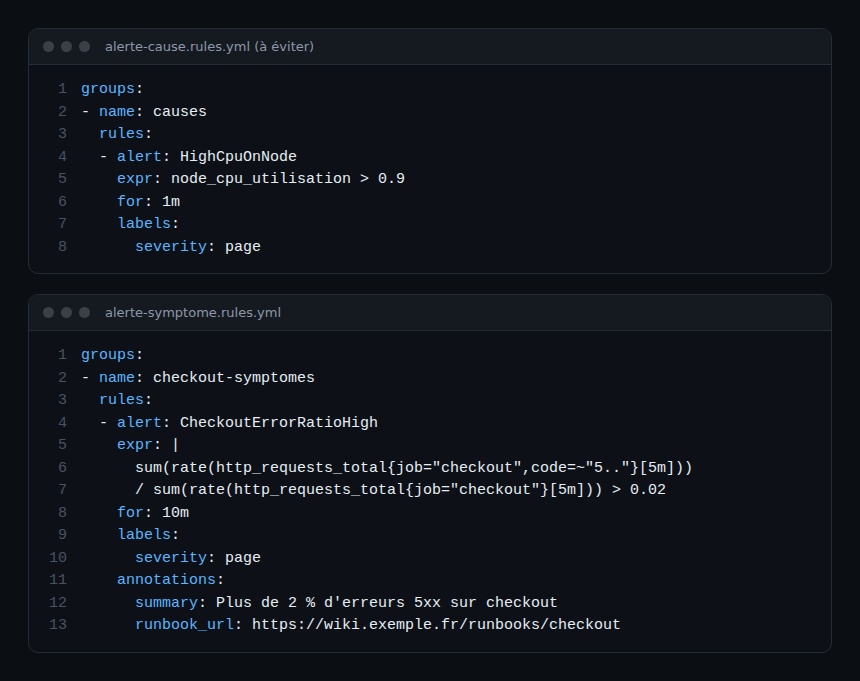
Esta es la misma necesidad escrita de dos maneras, en reglas de Prometheus. Los nombres de métricas y de URL son ficticios. Las claves (alert, expr, for, labels, annotations) proceden de la página Alerting rules.
groups:
- name: checkout-symptomes
  rules:
  - alert: CheckoutErrorRatioHigh
    expr: |
      sum(rate(http_requests_total{job="checkout",code=~"5.."}[5m]))
      / sum(rate(http_requests_total{job="checkout"}[5m])) > 0.02
    for: 10m
    labels:
      severity: page
    annotations:
      summary: Plus de 2 % d'erreurs 5xx sur checkout
      runbook_url: https://wiki.exemple.fr/runbooks/checkout
Tres decisiones son importantes:
- La condición se basa en un ratio de errores visto por quienes llaman al servicio, no en un recurso interno. El umbral del 2 % es un ejemplo: se ajusta según su SLO.
- La cláusula
for: 10mhace que Prometheus espere entre la primera observación y el estado «firing». Según la documentación, los elementos activos pero aún no en disparo están en «pending», y sinforla alerta se activa desde la primera evaluación. Es el margen que absorbe los pequeños tropiezos. - La anotación
runbook_urlapunta al procedimiento. Prometheus recomienda que la alerta remita a consolas para encontrar rápido el componente defectuoso: ahí es donde las causas recuperan su lugar.
Para la latencia, Prometheus aconseja avisar en un único punto de la pila: «Only page on latency at one point in a stack». Evite, por tanto, una alerta de latencia por capa; de lo contrario, una lentitud en la base de datos despierta a cuatro servicios.
Paso 3: conservar las causas como ayuda al diagnóstico
Quitar la página sobre la CPU no elimina el dato. Conserve la métrica en un panel enlazado a la alerta de síntoma. El libro Google SRE recomienda la misma división: la supervisión de caja negra detecta los problemas en curso, y la de caja blanca revela las causas y las averías inminentes. Si precalcula ratios costosos, nómbrelos bien con las recording rules de Prometheus.
Las cuatro señales de oro del mismo libro (latencia, tráfico, errores, saturación) dan un punto de partida para los síntomas que cubrir primero. La saturación, por su parte, sigue siendo una señal de anticipación: trátela como un ticket mientras no afecte todavía al usuario. Para la diferencia entre estas señales y la exploración libre, consulte observabilidad y monitorización.
Paso 4: pasar al burn rate para las páginas
El SRE Workbook defiende las alertas basadas en SLO, porque miden la fiabilidad «tal como la viven sus clientes». Define el burn rate como la velocidad a la que el servicio consume su presupuesto de errores respecto al SLO: un burn rate de 1 agota exactamente el presupuesto al final de la ventana. Para un SLO del 99,9 %, recomienda combinar varias ventanas.
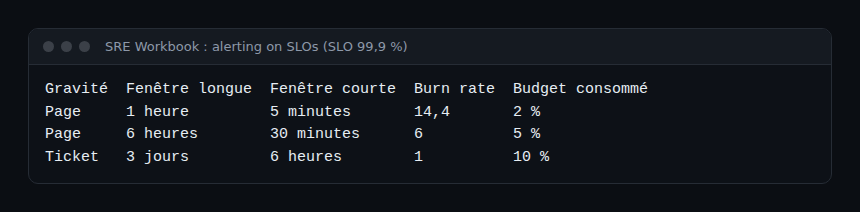
La alerta solo se dispara si ambas ventanas superan el umbral. La ventana corta, de aproximadamente un doceavo de la larga, comprueba que el presupuesto se sigue consumiendo, y la alerta se cierra pronto tras la corrección. La implementación en Dynatrace se detalla en alertas burn rate SLO.
¿Y con Dynatrace?
Este apartado se apoya en la documentación de Dynatrace SaaS; la documentación de Managed no se ha consultado para este artículo y sus funciones no se deducen de ella. Según la página de la aplicación Problems, se crea un problema cuando Dynatrace Intelligence señala problemas desencadenados por uno o varios eventos. Los eventos fusionados se conservan en el campo dt.davis.event_ids, y la entidad considerada causa raíz se indica en la vista detallada. La sección «Impact» enumera las entidades afectadas.
En concreto, un problema agrupa síntoma y causa probable en un mismo registro, mientras que las alertas de umbral por métrica producirían otras tantas notificaciones. La documentación consultada no detalla los criterios de agrupación: no los suponga. Para enrutar estos problemas, consulte crear una alerta de Dynatrace.
Cómo comprobar que funciona
- Cuente las páginas por semana antes y después del rediseño. El objetivo no es cero, sino cero páginas sin acción.
- Reproduzca tres incidentes pasados: ¿se habría disparado la alerta de síntoma y en qué minuto? Si llega demasiado tarde, la ventana o el umbral son demasiado laxos.
- Verifique que cada página lleve un enlace a un runbook y al panel de causas probables.
- En la revisión de guardia, relea cada página y plantee las cinco preguntas anteriores. Una respuesta «no» retira la regla o la rebaja.
Buenas prácticas
- Una página = un usuario afectado o un presupuesto de errores en peligro.
- Una alerta, un responsable, un runbook.
- Las causas alimentan paneles y tickets, no el pager.
- Evalúe las reglas sin culpar (blameless): un falso positivo es un defecto de la regla, no de una persona.
- Conserve alertas para fallos invisibles al usuario solo si exigen intervención humana, como precisa Prometheus.
Preguntas frecuentes
¿Hay que eliminar todas las alertas sobre CPU o memoria?
No. Retírelas del pager, no de los paneles. Una saturación que anuncia una caída próxima merece un ticket, como reconoce la documentación de Prometheus.
¿Cómo alertar sobre un síntoma sin SLO definido?
Empiece por la tasa de errores y la latencia que ven quienes llaman al servicio, con una cláusula for que absorba los tropiezos. Después defina un SLO para pasar al burn rate. Las cuatro señales de oro del libro Google SRE sirven como lista de partida.
¿Un síntoma no llega demasiado tarde?
Llega cuando el usuario está afectado, y ese es el objetivo. Para anticiparse, use las ventanas de burn rate (un consumo rápido del presupuesto avisa antes de que se agote) y trate las señales de saturación como tickets.
Conclusión
Alertar sobre síntomas recentra el pager en el impacto y deja las causas para el diagnóstico. La tarea es modesta: clasificar las reglas, reescribir las páginas como ratios de errores y de latencia, y después migrar al burn rate. La guardia gana en sueño y el equipo, en confianza en sus alertas.
Fuentes
- Monitoring Distributed Systems, Google SRE book
- Alerting on SLOs, Google SRE Workbook
- Alerting, prácticas de Prometheus
- Alerting rules, documentación de Prometheus
- Problems, documentación de Dynatrace
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos citados pertenecen a sus respectivos propietarios; los ejemplos de código, métricas y URL son ficticios y se ofrecen con fines didácticos. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.