تقوم معظم الاستعلامات المكتوبة أثناء المناوبة (on-call) على أربع لبنات: filter، والدالة in()، وsummarize مع المعامل by، وtimeseries. وإتقان أوامر DQL هذه يوفّر دقائق في كل حادثة، ويجنّبك خصوصًا النتائج الخاطئة التي لا تنتبه إليها: limit وُضع مبكرًا جدًا، أو مجموعة null منسية، أو وحدة قياس أُسيء قراءتها.
لا يكرر هذا المقال مجموعة استعلامات مرتبة بحسب حالات الاستخدام، فهي موجودة في استعلامات DQL للتشغيل. بل يتبع الزاوية المعاكسة: الأمر أولًا، مع 30 مثالًا قصيرًا موضحًا تُظهر سلوكه الدقيق ومعاملاته وفخاخه.
النطاق: يستعلم DQL عن Grail، لذلك فإن كل ما يلي ينطبق على Dynatrace SaaS. أما Dynatrace Managed فلا يملك Grail ولا DQL؛ ويمر ما يعادلهما عبر Data Explorer وmetric selector. وتتوقف أسماء الحقول على المصدر: شغّل fetch logs | limit 5 قبل نسخ أي استعلام.
كيف يربط DQL الأوامر ببعضها
استعلام DQL خط معالجة (pipeline): يستقبل كل أمر جدولًا ويحوّله ويمرّره إلى الأمر التالي بالرمز |.
إن كانت الأساسيات (fetch وfields وsort) جديدة عليك، فابدأ بـوحدة أساسيات DQL.
filter: التقليص مبكرًا وبدقة (الأمثلة 1 إلى 8)
// 1. Strict equality: the value is known
fetch logs | filter loglevel == "ERROR"

// 2. Several conditions and a short window (better performance)
fetch logs, from: -2h
| filter loglevel == "ERROR" and k8s.namespace.name == "checkout"

// 3. Partly known value: ~ operator with a wildcard
fetch logs | filter k8s.container.name ~ "core*"

// 4. Search for a phrase in the content
fetch logs | filter matchesPhrase(content, "connection refused")

// 5. Case-insensitive substring
fetch logs | filter contains(content, "timeout", caseSensitive: false)

// 6. Exclude: filterOut keeps records where the condition is null
fetch logs | filterOut loglevel == "DEBUG"

// 7. Active Problems, without duplicates
fetch dt.davis.problems
| filter not(dt.davis.is_duplicate)
| filter event.status == "ACTIVE"
| fields display_id, event.name, event.category

// 8. Server spans with HTTP 5xx errors
fetch spans
| filter span.kind == "server" and http.response.status_code >= 500
أدق نقطة هي المثال 6. إن filterOut x لا يحذف إلا السجلات التي تكون فيها x مساوية لـ true: أما السجلات التي تكون فيها x مساوية لـ null فتبقى. بينما filter not x يحذف أيضًا قيم null. وعلى سجلات بلا loglevel، لا يعيد الاستعلامان إذن العدد نفسه من الأسطر.
in(): اختبار قائمة قيم (الأمثلة 9 إلى 12)
تعيد in(needle, haystack, …) قيمة منطقية. ويمكن أن تكون haystack مصفوفة أو سلسلة قيم.
// 9. Array literal in braces
fetch logs | filter in(loglevel, {"ERROR", "WARN"})

// 10. Several values passed directly
fetch logs | filter in(k8s.namespace.name, "checkout", "payment")

// 11. Excluding a list
fetch logs | filter not in(k8s.namespace.name, {"kube-system", "monitoring"})

// 12. In timeseries, in() filters on dimensions
timeseries cpu = avg(dt.host.cpu.usage), by: { dt.entity.host },
  filter: in(dt.entity.host, "HOST-1", "HOST-2")
فضّل in() على سلسلة من or: يصبح الاستعلام أوضح، ويسهل استبدال القائمة بمتغير في لوحة المعلومات.
summarize وby: التجميع دون أخطاء (الأمثلة 13 إلى 21)
الصيغة هي summarize [field =] aggregation, … [, by: {[field =] expression, …}].
// 13. Count everything: a single output row
fetch logs | summarize count()

// 14. Group by one dimension and name the result
fetch logs | summarize c = count(), by: { loglevel } | sort c desc

// 15. Several dimensions, alias on the group
fetch logs, from: -1h
| summarize c = count(), by: { ns = k8s.namespace.name, loglevel }

// 16. Error rate in one pass with countIf
fetch logs, from: -1h
| summarize total = count(), errors = countIf(loglevel == "ERROR"),
    by: { k8s.namespace.name }
| fieldsAdd error_pct = 100.0 * errors / total

// 17. Duration percentile per endpoint (duration is in nanoseconds)
fetch spans
| filter span.kind == "server"
| summarize p95 = percentile(duration, 95), by: { endpoint.name }

// 18. Exact number of distinct log sources
fetch logs | summarize sources = countDistinctExact(log.source)

// 19. List of distinct values per group
fetch logs | summarize sources = collectDistinct(log.source), by: { k8s.namespace.name }

// 20. Sampling: 1 record in 100, then correction
fetch spans, samplingRatio: 100
| summarize c = count(), by: { span.kind }
| fieldsAdd c = c * 100

// 21. Problems per category
fetch dt.davis.problems
| filter not(dt.davis.is_duplicate)
| summarize problems = count(), by: { event.category }
سلوكان ينبغي تذكرهما. إذا لم يكن حقل من حقول by موجودًا في بعض السجلات، ينشئ summarize مجموعة null: لا تحذفها دون أن تفهم مصدرها، فهي غالبًا مصدر لم يُثرَ بالبيانات كما ينبغي. وبدون by، يعيد summarize دائمًا سطرًا واحدًا، حتى على صفر سجل: تكون قيمة count() حينئذ 0 وقيمة بقية التجميعات null.
timeseries وmakeTimeseries: المنحنيات (الأمثلة 22 إلى 30)
الأمر timeseries أمر بداية: يحمّل المقاييس ويصفّيها ويجمّعها في خطوة واحدة. وكل السلاسل المعادة لها البداية نفسها والنهاية نفسها والفاصل الزمني نفسه.
// 22. Average CPU per host
timeseries usage = avg(dt.host.cpu.usage), by: { dt.entity.host }

// 23. One week, one-hour steps
timeseries max(dt.host.cpu.usage), by: { dt.entity.host }, interval: 1h, from: -7d

// 24. Fill gaps with a default value
timeseries mem = avg(dt.host.memory.usage, default: 0), by: { dt.entity.host }

// 25. p99 response time (in microseconds) per service
timeseries p99 = percentile(dt.service.request.response_time, 99),
  by: { dt.entity.service }

// 26. Failure rate: element-wise operations with []
timeseries total = sum(dt.service.request.count),
  failed = sum(dt.service.request.failure_count),
  by: { dt.entity.service }
| fieldsAdd failure_pct = failed[] / total[] * 100

// 27. Top 10 hosts by average CPU over the period
timeseries cpu = avg(dt.host.cpu.usage), by: { dt.entity.host }
| fieldsAdd avg_cpu = arrayAvg(cpu)
| sort avg_cpu desc
| limit 10

// 28. Same period one week earlier
timeseries cpu_last_week = avg(dt.host.cpu.usage), shift: -7d

// 29. Aggregate all series into a single line
timeseries usage = avg(dt.host.cpu.usage), by: { dt.entity.host }
| summarize usage = avg(usage[]), by: { timeframe, interval }

// 30. Chart from logs (non-metric data)
fetch logs
| filter loglevel == "ERROR"
| makeTimeseries errors = count(), by: { k8s.namespace.name }, interval: 5m
ثلاثة فخاخ شائعة. الدالة percentile بدون rollup لا تعمل إلا على dt.service.request.response_time وdt.service.request.service_mesh.response_time؛ وللمقاييس الأخرى أضف rollup: avg. وتقدير النسبة المئوية دقيق بحوالي 2.2%. وأخيرًا، يستبعد interval وbins أحدهما الآخر: اختر أحدهما. وللمضي أبعد في التنبيهات المبنية على هذه المنحنيات، راجع وحدة timeseries والتنبيهات.
أفضل الممارسات مع أوامر DQL
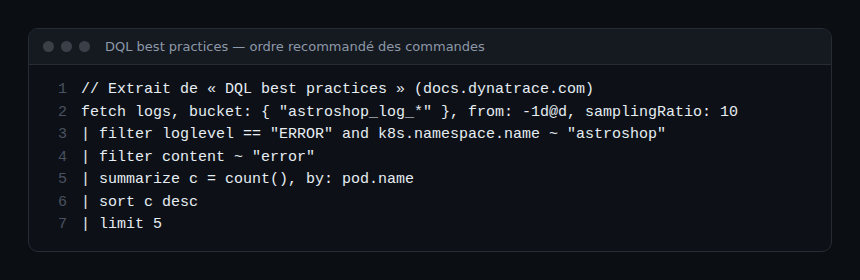
أفضل الممارسات
- صفِّ أولًا، ثم اختر الحقول، ثم جمّع أخيرًا؛ و
sortفي نهاية الاستعلام. - لا
limitقبلsummarizeأبدًا، إلا بقصد صريح: فسيُحسب التجميع على عيّنة عشوائية. - صفِّ على الحقل الخام:
k8s.namespace.name ~ "astro*"بدلmatchesValue(lower(…)). ==حين تكون القيمة معروفة، و~فقط حين تُعرف جزئيًا؛ والمرشحات الاحتوائية بدل النفي.- قلّص النافذة (
from: -2h) والحجم (bucketوsamplingRatioوscanLimitGBytes). - اقرأ الوحدة:
durationفي spans بالنانوثانية، وdt.service.request.response_timeبالميكروثانية.
تهم هذه القواعد الموثوقية: استعلام SLI بطيء أو خاطئ يعطي ميزانية أخطاء (error budget) خاطئة. وعندما تستقر الاستعلامات، احفظها في لوحة معلومات Dynatrace SaaS؛ وللأوامر lookup وjoin وparse، راجع DQL المتقدم.
كيف تتحقق من استعلاماتك
- شغّل الاستعلام في Notebook على نافذة قصيرة، ثم قارن
count()قبل كلfilterوبعده. - في
summarize، ابحث في النتيجة عن مجموعةnullغير متوقعة. - في
timeseries، تحقق من العمودينtimeframeوintervalالمعادين: فهما يخبرانك أي خطوة طُبّقت فعلًا.
الأسئلة الشائعة
ما الفرق بين summarize وmakeTimeseries؟
ينتج summarize جدولًا (سطرًا لكل مجموعة). أما makeTimeseries فينتج سلاسل زمنية من بيانات غير مقاييس مثل السجلات أو الأحداث. وللمقاييس، استخدم timeseries مباشرة.
لماذا لا يعيد استعلام timeseries شيئًا بينما أتوقع 0؟
افتراضيًا، قيمة nonempty هي false: عند غياب البيانات لا يُعاد أي سطر. اجمع بين nonempty: true وdefault: 0 للحصول على سلسلة من الأصفار.
هل تعمل هذه الاستعلامات على Dynatrace Managed؟
لا. إن DQL وGrail خاصان بـ Dynatrace SaaS. وعلى Managed، استخدم Data Explorer وmetric selector مع المفاتيح builtin:.
الخلاصة
أربعة أوامر DQL تغطي معظم التشخيص: filter للتقليص، وin() لاستهداف قائمة، وsummarize للعدّ والتصنيف، وtimeseries لرؤية التطور. احتفظ بهذه الأمثلة الثلاثين في Notebook مشترك للفريق والتزم بالترتيب: صفِّ، ثم اختر، ثم جمّع، ثم رتّب. والمرجع الكامل في وثائق أوامر DQL وفي صفحة DQL best practices.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لمالكها. الأمثلة مقدّمة على سبيل الإرشاد: تحقق منها في بيئتك قبل استخدامها في الإنتاج.