تكلفة Elastic Observability Serverless تعتمد على حجمين فقط: ما ترسله إلى المشروع كل شهر وما تحتفظ به فيه. وبالنسبة لفريق SRE أو فريق المنصة، يتلخص العمل في تقدير هذين الرقمين قبل ربط المصادر، ثم مراقبتهما. تقدّم هذه المقالة الطريقة، والأرقام المقروءة في وثائق Elastic، ومثال حساب يمكنك إعادته بحجومك الخاصة.
لا يأتي هنا أي سعر من موقع طرف ثالث. الأسعار المذكورة قُرئت من صفحة Elastic الرسمية في 30 أكتوبر 2026 وقد تتغير: أعد قراءتها قبل أي ميزانية.
باختصار
- بُعدان للحجم: الاستيعاب (ingestion، أي عدد GB المرسلة خلال الشهر) والاحتفاظ (retention، أي عدد GB المخزّنة).
- الحجم المفوتر هو حجم البيانات بعد إثرائها وتطبيعها في نهاية خط الاستيعاب، وقبل ضغط Elasticsearch.
- اختيار وكيل الجمع، بما فيه OpenTelemetry، لا يغيّر التكلفة وفق الوثائق.
- يُضبط الاحتفاظ لكل تدفق بيانات (
data_retention): وهو أبسط وسيلة للتحكم.
كيف تُحسب تكلفة Elastic Observability Serverless
تصف صفحة Observability billing dimensions بُعدين للبيانات. يُقاس الاستيعاب بـ«عدد GB من البيانات التي ترسلها إلى مشروع Observability خلال شهر». ويُقاس الاحتفاظ بـ«الكمية الإجمالية للبيانات المستوعَبة المخزّنة» في المشروع. تتبع السجلات والتتبعات التعرفة القياسية؛ ولا تشكل بند فوترة منفصلاً.
هناك استثناء للمقاييس. وفق الصفحة نفسها، تُفوتر المقاييس المخزّنة بنمط فهرس السلاسل الزمنية بنسبة 25% من تعرفة الاحتفاظ القياسية لكل GB، وينطبق المعامل نفسه على استيعابها. تعرفة المقاييس المنشورة تغيّرت: تذكر صفحة الأسعار تسعيرة جديدة سارية من 1 يوليو 2026.
ما الذي يقيسه حجم الاستيعاب بالضبط
وفق هذه الوثائق، يُحسب الحجم على حجم البيانات «المُثراة والمطبَّعة بالكامل» في نهاية خط الاستيعاب، قبل ضغط Elasticsearch. والنتيجة العملية: قد يتجاوز الحجم المفوتر حجم الفهرس على القرص، وكذلك الأحجام الظاهرة في سجلات وكيل (proxy) مزوّد السحابة. لذلك لا تحدد الحجم اعتمادًا على حجم فهارس عنقود قديم ولا على حركة الشبكة.
نقطة مطمئنة للفرق التي توحّد معاييرها على OpenTelemetry: تذكر الصفحة أن بنية الاستيعاب (Elastic Agent أو Logstash أو OpenTelemetry أو مجمّعات أخرى) لا تؤثر في التكلفة. تناولنا هذه المسارات في مقالتنا عن Elastic Agent ومجمّع OpenTelemetry.
الأسعار المنشورة، مع التاريخ والتحفظات
تعرض صفحة Serverless Observability pricing، التي اطلعنا عليها في 30 أكتوبر 2026، مستويين من الميزات. المبالغ بالدولار («$») ولا تذكر الصفحة اسم العملة.
| المستوى | الاستيعاب (سجلات، تتبعات، أخرى) | الاحتفاظ (سجلات، تتبعات، أخرى) |
|---|---|---|
| Logs Essentials | ابتداءً من 0.07 $ لكل GB | ابتداءً من 0.017 $ لكل GB في الشهر |
| Complete | ابتداءً من 0.09 $ لكل GB | 0.019 $ لكل GB في الشهر |
بالنسبة للمقاييس، تعرض الصفحة 0.023 $ لكل GB للاستيعاب و0.005 $ لكل GB في الشهر للاحتفاظ في مستوى Complete. انتبه إلى عبارة «ابتداءً من»: فهي حدود دنيا معروضة وليست سعرًا مضمونًا لحجمك. لذا فكل حساب بهذه الأرقام هو تقدير أدنى. لميزانية نهائية، استخدم الحاسبة أو فريق المبيعات في Elastic.
تحديد حجم الاستيعاب والاحتفاظ خطوة بخطوة
هذه طريقة من أربع خطوات. تصلح لمشروع Observability على Elastic Cloud Serverless؛ ولا تخص Dynatrace Managed ولا Dynatrace SaaS.
- قِس الحجم الخام لكل مصدر. احسب عدد GB يوميًا لكل مصدر (سجلات التطبيقات، التتبعات، المقاييس) قبل الضغط، مع احتساب الإثراء الذي تضيفه خطوط المعالجة لديك.
- اضرب في 30 للحصول على الاستيعاب الشهري.
- حدّد الاحتفاظ لكل نوع من البيانات. فتتبعات تصحيح الأخطاء لا تحتاج إلى المدة نفسها التي تحتاجها سجلات التدقيق.
- احسب المخزون المخزّن: الحجم اليومي مضروبًا في عدد أيام الاحتفاظ، بعد بلوغ النظام المستقر.
مثال بـ50 GB يوميًا من السجلات في مستوى Complete، بالأسعار الدنيا أعلاه. يبلغ الاستيعاب 1500 GB في الشهر، أي 135 $. مع احتفاظ مدته 30 يومًا يبلغ المخزون 1500 GB، أي 28.5 $ في الشهر؛ ومع 90 يومًا يبلغ 4500 GB، أي 85.5 $ في الشهر.
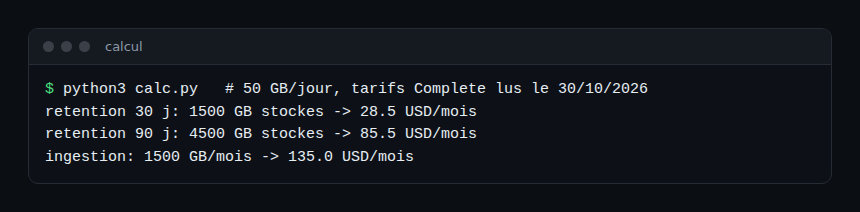
يُظهر الحساب رتبة مقدار مفيدة: الانتقال من 30 إلى 90 يومًا يضاعف المخزون المخزّن ثلاث مرات، لكنه لا يمس الاستيعاب. هنا يزن الاستيعاب أكثر من الاحتفاظ. لذلك يبقى خفض الحجم المرسل الوسيلة الأولى، والاحتفاظ الثانية. هذه النتيجة جاءت من حسابنا على أسعار دنيا، لا من قياس.
لم نتحقق مما إذا كان الاحتفاظ يحتسب الحجم «المُثرى» نفسه الذي يحتسبه الاستيعاب أم الحجم المضغوط: فالوثائق التي قرأناها لا توضح ذلك. احتفظ بهامش، وقارن أول فاتورة بتقديرك.
ضبط الاحتفاظ في قالب فهرس
وفق وثائق الاحتفاظ بتدفقات البيانات، يُحدَّد المعامل data_retention لكل تدفق بيانات. وللتدفقات الجديدة يوضع في قالب فهرس؛ والاسم logs-app-* أدناه مثال.
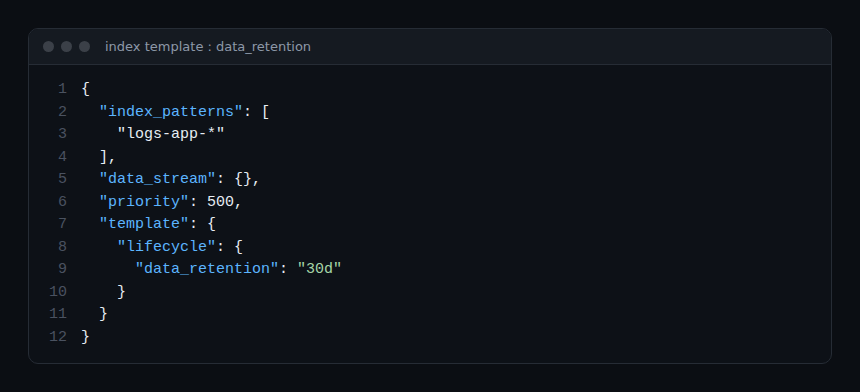
{
  "index_patterns": ["logs-app-*"],
  "data_stream": {},
  "priority": 500,
  "template": {
    "lifecycle": {
      "data_retention": "30d"
    }
  }
}
تعديل تدفق موجود
بالنسبة لتدفق أُنشئ مسبقًا، يعطي مرجع واجهة Elasticsearch Serverless البرمجية الطلب PUT /_data_stream/{name}/_lifecycle. يحدد المعامل data_retention الحد الأدنى لمدة الاحتفاظ بالمستندات؛ والقيمة الفارغة تحتفظ بها إلى أجل غير محدد.
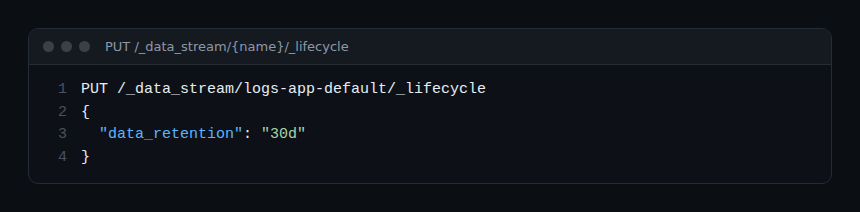
PUT /_data_stream/logs-app-default/_lifecycle
{
  "data_retention": "30d"
}
في Kibana، تقترح صفحة Streams أيضًا تبويب Retention لعرض احتفاظ التدفق وتعديله. وبلا ضبط، يكون الاحتفاظ الفعلي لانهائيًا: وهي القيمة الافتراضية الموثقة، وبالتالي خطر تكلفة يكبر بصمت. توجد الإعدادات على مستوى العنقود data_streams.lifecycle.retention.default وdata_streams.lifecycle.retention.max في صفحة الوثائق؛ ولم نتحقق من توفرها في مشروع Serverless، الذي لا يعرض بالضرورة إعدادات العنقود. كما تذكر أن اللقطات القابلة للبحث (frozen_after) غير متاحة في Serverless: فالمستوى المجمّد الموصوف في مقالتنا عن المستوى المجمّد (frozen tier) لا ينطبق هنا.
كيف تتحقق من أن الإعداد يعمل
- استعلم عن التدفق بواجهة Get data stream lifecycle: يجب أن تُظهر الاستجابة
"lifecycle": {"enabled": true}وقيمةdata_retentionالتي ضبطتها. - قارن، مرة في الأسبوع، الحجم المرسل بتقديرك اليومي. الفارق المستمر يدل على مصدر مفرط في الإسهاب.
- بعد الشهر الكامل الأول، قارن الفاتورة بحسابك وعدّل معامل الهامش.
أفضل الممارسات للتحكم في التكلفة
- رشّح عند المصدر. احذف سجلات مستوى debug في الإنتاج من المجمّع، قبل الاستيعاب. كما أن أخذ عينات من التتبعات، مثل tail sampling، يخفض الحجم المرسل.
- حدّد احتفاظًا لكل تدفق بدل ترك القيمة اللانهائية الافتراضية.
- راقب عمليات الإثراء. كل حقل يضيفه خط معالجة يزيد الحجم المفوتر.
- عامِل التكلفة كمؤشر SLI داخلي. ميزانية استيعاب لكل خدمة، مرتبطة بأهداف SLO لديك، تجنّب المفاجآت.
إذا قارنت بمنصات أخرى، فاحتفظ بالطريقة نفسها: الحجم، والاحتفاظ، ووحدة الفوترة. يوضح مقارنتنا Dynatrace وDatadog أنهما لا تفوتران الوحدات نفسها. وللمفاهيم الأساسية، راجع أيضًا قابلية الملاحظة والمراقبة، ودليلنا عن الاحتفاظ بالبيانات وتخزينها في Dynatrace.
الأسئلة الشائعة
هل تعتمد تكلفة Elastic Observability Serverless على الوكيل المستخدم؟
لا، وفق صفحة الفوترة في Elastic: بنية الاستيعاب (Elastic Agent أو Logstash أو OpenTelemetry أو مجمّعات أخرى) لا تؤثر في التكلفة. المهم فقط الحجم المقيس في نهاية خط المعالجة.
لماذا تتجاوز فاتورتي حجم فهارسي؟
لأن الحجم المفوتر هو حجم البيانات المُثراة والمطبَّعة قبل ضغط Elasticsearch. لذلك قد يتجاوز حجم الفهرس والأحجام التي يراها وكيل (proxy) سحابي.
ما الاحتفاظ الافتراضي؟
بلا ضبط، تذكر الوثائق أن الاحتفاظ الفعلي لانهائي وأن البيانات تُحفظ إلى أجل غير محدد. اضبط data_retention على كل تدفق لتحديد سقف للمخزون.
الخلاصة
لتقدير تكلفة Elastic Observability Serverless، قِس الحجم الخام المُثرى، واضربه في مدة الاحتفاظ المطلوبة، ثم طبّق الأسعار المقروءة من الصفحة الرسمية مع ذكر تاريخها. اخفض الاستيعاب أولاً، ثم حدّد الاحتفاظ تدفقًا بتدفق.
المصادر
- Observability billing dimensions، وثائق Elastic
- Serverless Observability pricing، Elastic (اطُّلع عليها في 30 أكتوبر 2026)
- Data stream retention، وثائق Elastic
- Put data stream lifecycle، واجهة Elasticsearch Serverless البرمجية
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Elastic N.V. أسماء المنتجات المذكورة تعود إلى مالكيها؛ والأسعار هي التي يعرضها الناشر في التاريخ المذكور، وأمثلة أسماء التدفقات وهمية. تحقق دائمًا من القيم في الوثائق الرسمية الخاصة بإصدارك.