Una alerta de logs en Dynatrace convierte una línea de log en un Problem, sin esperar a que una persona revise una consola. La trampa clásica se resume en dos palabras: demasiado o demasiado poco. Una alerta sobre cada línea «error» despierta a la guardia diez veces por la misma causa. Una alerta demasiado prudente deja pasar el error que importa.
Este artículo muestra cómo crear la alerta y cómo mantenerla en silencio mientras nada exija una acción. La parte principal vale para Dynatrace SaaS (OpenPipeline y Anomaly Detection). Una sección aparte cubre Dynatrace Managed, donde la cadena pasa por las log metrics y los metric events. Las dos plataformas no comparten las mismas pantallas: no las mezclo.
En breve
- Según la documentación de Dynatrace SaaS, hay tres vías para una alerta de logs en Dynatrace: eventos Davis extraídos de los logs, métricas extraídas de los logs con una custom alert, o una consulta DQL en una custom alert.
- El evento extraído reacciona más rápido y no necesita umbral. La métrica extraída exige más ajustes, pero permite umbrales y analizadores.
- El ruido se reduce en tres sitios: el filtro (matcher), la ventana deslizante y la decisión de no alertar por datos ausentes en un flujo escaso.
Elegir la vía adecuada para una alerta de logs en Dynatrace (SaaS)
La página Alerting on logs compara los tres enfoques. Esto es lo esencial, reformulado.
| Vía | Cuándo | Retraso | Coste (según la doc) |
|---|---|---|---|
| Evento Davis extraído de los logs | Patrón raro, sin umbral | El más rápido | Número y tamaño de los eventos |
| Métrica extraída + custom alert | Umbral o analizador, valor de un campo | Evaluación cada minuto | Puntos de datos y tamaño de la métrica |
| Consulta DQL en una custom alert | Cuando las otras dos no son posibles | Evaluación cada minuto | Complejidad y volumen escaneado |
La documentación precisa que la consulta DQL no se recomienda como estrategia principal: se ejecuta cada minuto y puede aumentar el consumo de licencia. Déjala como último recurso.
Desde el punto de vista SRE, la regla es sencilla. Un evento único y grave («la cola de exportación está llena») merece el evento extraído. Una deriva («sube la tasa de errores») merece una métrica y un umbral. Esta elección determina directamente el volumen de alertas y, por tanto, el toil de la guardia.
Crear la alerta desde un evento extraído de los logs
Requisitos previos
Los logs llegan a Dynatrace y tienes permiso para configurar OpenPipeline. La documentación cita la política predeterminada «Data Processing and Storage» como ejemplo. Para la ingesta en sí, consulta el artículo sobre la Log ingestion API.
Paso 1: aislar los logs con DQL
En Logs, escribe la consulta que encuentra la línea objetivo. El ejemplo de la documentación busca una frase precisa.
fetch logs
| filter matchesPhrase(content, "Dropping data because sending_queue is full")
| sort timestamp desc
Abre un registro y lee el campo dt.openpipeline.pipelines: indica qué pipeline procesa ese log.
Paso 2: añadir el processor Davis event
- Ve a Settings > Process and contextualize > OpenPipeline > Logs > Pipelines, abre el pipeline deseado (o crea uno) y elige Edit.
- En la etapa Davis, añade un processor Davis event.
- En Matching condition, pega el filtro extraído de tu consulta.
- En Event template, rellena las propiedades del evento.
matchesPhrase(content, "Dropping data because sending_queue is full")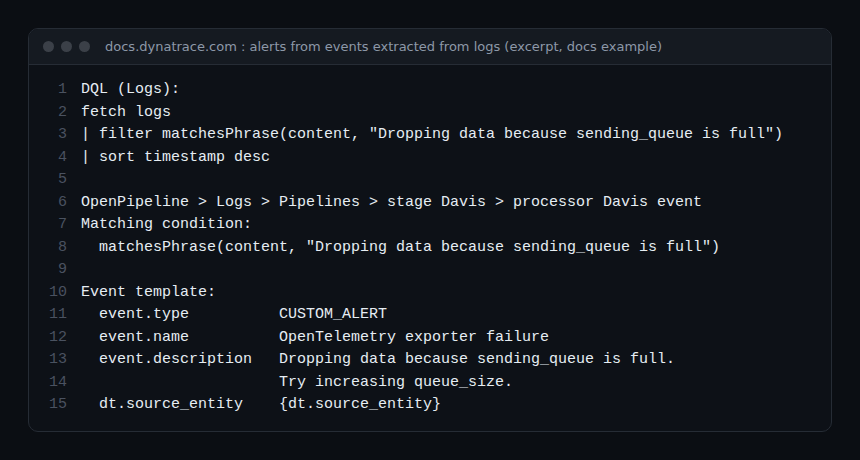
La plantilla de la documentación fija event.type en CUSTOM_ALERT, un event.name, una event.description y dt.source_entity. Este último campo, tomado del log, vincula la alerta a una entidad y ayuda al análisis de causa raíz de Davis.
Paso 3: enrutar los logs si el pipeline es nuevo
Si has modificado un pipeline existente, no hay nada más que hacer. Si no, crea una ruta en OpenPipeline > Logs > Dynamic routing, con la misma condición que el matcher. La documentación da dos reglas. Las rutas se evalúan de arriba abajo y gana la primera que coincide. El enrutamiento va antes del procesamiento: un campo añadido durante el procesamiento, como dt.entity.service, no puede servir de condición de ruta.
Para profundizar en los pipelines, consulta el módulo Logs y OpenPipeline.
Reducir el ruido en el evento
Un evento por log es la receta del diluvio. Hay tres palancas.
- Un matcher estrecho. Prefiere una frase precisa a
loglevel == "ERROR"a secas. Cuanto más fino el filtro, menos eventos, y la documentación indica que el coste sigue al número de eventos generados. - El tiempo de expiración. Según la documentación, el campo
dt.davis.event_timeoutfija cuánto tiempo permanece abierto el Problem sin un nuevo evento. El valor predeterminado es de 15 minutos. Mientras los eventos se repitan dentro de ese plazo, el Problem sigue siendo el mismo; sin nuevo evento, se cierra solo. - El uso adecuado. Reserva este mecanismo para patrones raros y serios. Para un flujo ruidoso, pasa a una métrica.
Para una visión de conjunto de la reducción de ruido en Davis, lee también reducir el ruido de las alertas de Davis.
Crear la alerta desde una métrica extraída de los logs (SaaS)
Cuando quieres un umbral, extrae primero una métrica. En el pipeline, abre Metric extraction, da un nombre y un identificador a la métrica y añade la misma Matching condition. Añade dimensiones. Para vincular los logs a las entidades, añade dt.source_entity u otro campo que contenga un identificador de entidad.
Ve después a Anomaly Detection y crea una custom alert, en modo simple. La página Set up custom alerts based on metrics extracted from logs describe cuatro gestos:
- definir el alcance de la alerta;
- referenciar la métrica en DQL, con
by: {dt.source_entity}para vincular la alerta a una entidad; - elegir las condiciones y el analizador que generan el evento Davis;
- escribir el título y la descripción.
Dos botones evitan adivinar. Suggest values propone un umbral. Preview estima cuántas alertas se habrían emitido en las dos últimas horas. La documentación no da la consulta completa de la métrica: consúltala para la sintaxis exacta antes de escribirla.
Los analizadores de métricas se ejecutan cada minuto, así que esta vía no sirve para una alerta en tiempo real. La documentación recomienda además dimensiones de baja cardinalidad.
Reducir el ruido en la métrica: ventana y datos ausentes
El analizador de umbral estático de Dynatrace SaaS, descrito en la página Anomaly detection configuration, no reacciona a una muestra aislada.
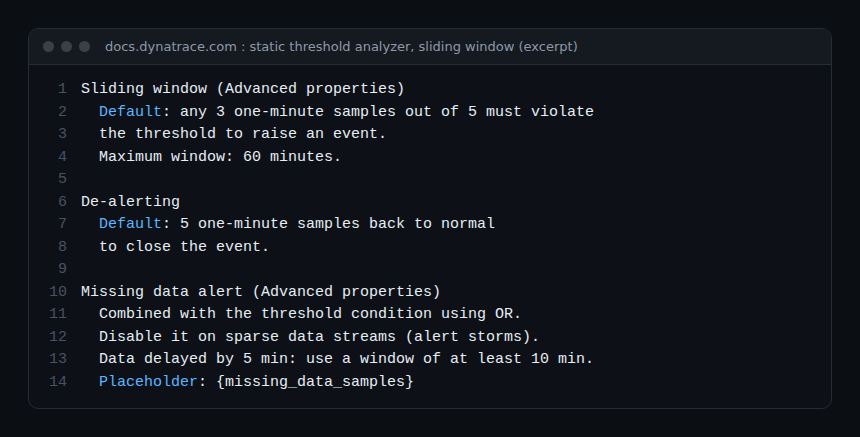
- Ventana deslizante. De forma predeterminada, tres muestras de un minuto de cinco deben superar el umbral para abrir un evento. La ventana puede llegar a 60 minutos.
- Cierre. De forma predeterminada, cinco muestras de un minuto que vuelven a la normalidad cierran el evento. Las nuevas violaciones se añaden al Problem existente en lugar de crear otro.
- Datos ausentes. Esta opción, en las propiedades avanzadas, se combina con el umbral mediante un OR. Dynatrace recomienda desactivarla para los flujos escasos, porque puede provocar una tormenta de alertas.
Esto se vincula directamente con un SLO: un log de error aislado casi no consume error budget, mientras que una serie dentro de la ventana es una señal real. Para datos con cinco minutos de retraso, la documentación aconseja una ventana de al menos diez minutos. Para el mismo razonamiento con metric events, consulta crear una alerta de Dynatrace paso a paso.
Dynatrace Managed: log metric y después metric event
En Dynatrace Managed, la documentación describe las log metrics de Logs Classic. Las páginas Log metrics (Logs Classic) de la documentación de Managed dan el procedimiento.
- Ve a Settings > Log Monitoring > Metrics extraction y elige Add log metric.
- Introduce la clave tras el prefijo obligatorio
log., la consulta en Matcher y una Measure: «Occurrence of log records» (a partir de la versión 1.206) o «Attribute value» (a partir de 1.229). - Añade una dimensión si hace falta y guarda.
- Ve a Settings > Anomaly detection > Metric events, elige Add metric event y construye el evento sobre tu métrica.
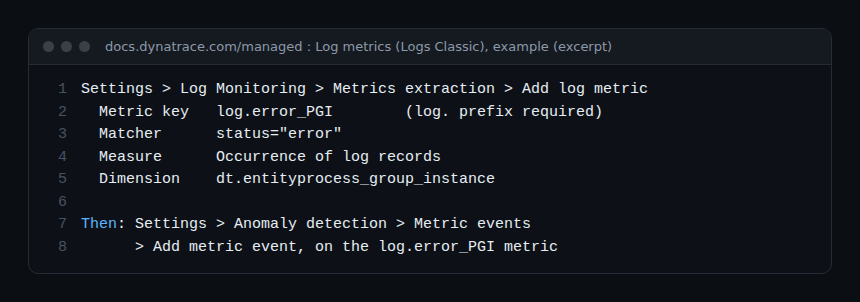
Aquí el ruido se ajusta con el matcher y la cardinalidad. La documentación fija límites de 1 000 000 de dimensiones por métrica y de 50 000 000 para el conjunto, y aconseja ajustar primero la consulta. Una métrica nueva no contiene nada hasta que llegan nuevos logs coincidentes. Cambiar la clave crea una métrica nueva: el histórico se queda bajo la clave anterior.
Los ajustes del metric event (ventana, datos ausentes) se explican en el artículo crear una alerta de Dynatrace. Para limitar los falsos positivos en Managed, consulta falsos positivos en Dynatrace Managed.
Cómo comprobar que funciona
- Repite la consulta DQL en Logs y comprueba que devuelve las líneas buscadas, y nada más.
- Produce o espera un log coincidente y abre Problems: debe aparecer un Problem con el nombre y la descripción de la plantilla.
- Con una custom alert, usa Preview para contar las alertas que habría emitido en las dos últimas horas.
- En Managed, consulta la métrica
log.en Data Explorer y comprueba que tiene valores antes de activar el metric event.
Buenas prácticas
- Una alerta debe exigir una acción humana. Si no, conviértela en un gráfico.
- Vincula siempre la alerta a una entidad con
dt.source_entity. - Estima el volumen antes de activar y revisa el número de alertas tras una semana.
- Para enviar las notificaciones, consulta alertas de Dynatrace en Slack y Teams y, para crear otras métricas, crear una métrica custom.
Preguntas frecuentes
¿Hace falta una métrica o un evento para alertar sobre logs?
Un evento extraído basta para un patrón raro que debe abrir un Problem de inmediato. Una métrica conviene cuando hace falta un umbral, una duración o un analizador, a costa de una evaluación cada minuto.
¿Por qué no se dispara mi alerta de logs en Dynatrace?
Comprueba primero que el matcher coincide con el log tal como llega al pipeline, y que la ruta envía el log al pipeline modificado. El enrutamiento va antes del procesamiento: un campo creado más tarde no sirve ahí.
¿Cómo evitar ráfagas de alertas en un flujo de logs ruidoso?
Estrecha el filtro, pasa a una métrica, alarga la ventana deslizante y desactiva la alerta por datos ausentes en un flujo escaso. Las violaciones siguientes se añaden al Problem abierto en lugar de crear nuevos.
Conclusión
Una buena alerta de logs en Dynatrace empieza con un filtro preciso y se ajusta por la duración, no por el volumen. Elige el evento para lo raro, la métrica para la deriva, y deja la consulta DQL como último recurso. La ganancia se nota en el MTTR y en el número de noches en que nadie se despierta para nada. Referencia: Set up alerts based on events extracted from logs.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace y Davis son marcas de Dynatrace LLC. La información procede de la documentación pública; compruébala en tu versión antes de cualquier cambio en producción.