El tamaño de shard Elasticsearch determina la velocidad de tus búsquedas, la memoria que consume el clúster y lo fácil que resulta operarlo. Si los shards son demasiado pequeños, se acumulan y saturan el nodo maestro. Si son demasiado grandes, ralentizan la recuperación tras un incidente. Este artículo reúne las referencias oficiales y te guía para aplicarlas con el rollover de ILM.
Objetivo: fijar un tamaño objetivo, automatizarlo en una política ILM y después comprobar el resultado. Las cifras de abajo provienen de la página Size your Elasticsearch shards (página consultada el 30 de octubre de 2026, sin número de versión visible). Son referencias de Elastic, no mediciones de span.observer: pruébalas con tus datos.
En resumen
- Según Elastic, apunta a shards de 10 GB a 50 GB y a menos de 200 millones de documentos por shard.
- La trampa clásica es el exceso de fragmentación (oversharding): muchos shards pequeños cuestan más que uno solo grande.
- El rollover por tamaño (
max_primary_shard_size) evita los índices diminutos creados «a hora fija». - Los shards son inmutables: corregir un tamaño inadecuado obliga a copiar el índice (Split o Reindex).
Tamaño de shard Elasticsearch: las referencias oficiales
La documentación da tres referencias. Primero, el tamaño: «aim for shard sizes between 10GB and 50GB». Después, el número de documentos: mantenlo por debajo de 200 millones por shard. Por último, el límite duro de Lucene, 2 147 483 519 documentos por shard (incluidos los documentos eliminados), muy por encima de la recomendación.
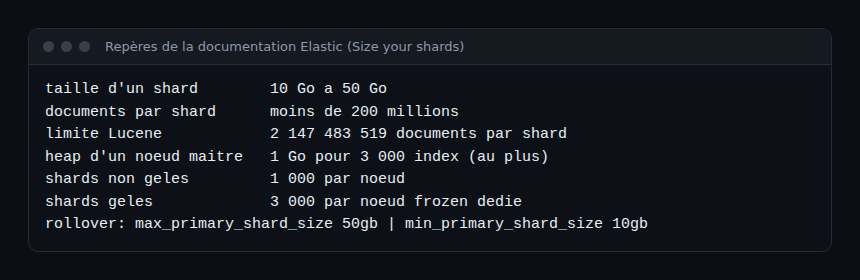
El mismo documento fija límites de clúster: 1000 shards no congelados por nodo y 3000 shards congelados por nodo frozen dedicado. En cuanto a los nodos maestros, indica como máximo 3000 índices por GB de heap. Un maestro con 4 GB de heap admite, por tanto, menos de 12 000 índices, antes de contar la memoria base.
Para un SRE, el vínculo con la fiabilidad es directo. Un clúster que supera estos límites se ralentiza con cada cambio de estado, y esa lentitud degrada tus SLO de búsqueda antes de que suene la alerta. Consulta también nuestra guía para supervisar Elasticsearch con Dynatrace.
Por qué demasiados shards pequeños salen caros
Cada shard tiene un coste fijo en memoria y en trabajo de búsqueda. El ejemplo de Elastic es elocuente: buscar en mil shards de 50 MB cuesta «sustancialmente» más que buscar en un shard de 50 GB con los mismos datos.
Según la página, existen varios remedios: reducir el número de shards con Shrink, reindexar índices de periodo corto hacia índices de periodo más largo y eliminar los índices vacíos. El force merge también reduce el número de segmentos, pero consume muchos recursos. Lánzalo fuera de las horas punta, sobre índices en los que ya no escribes.
En cambio, los shards demasiado grandes no aparecen en estos límites: la página no cuantifica su efecto en la recuperación. Por eso no lo afirmamos aquí; mide el tiempo de reubicación en tu clúster.
Controlar el tamaño con el rollover de ILM
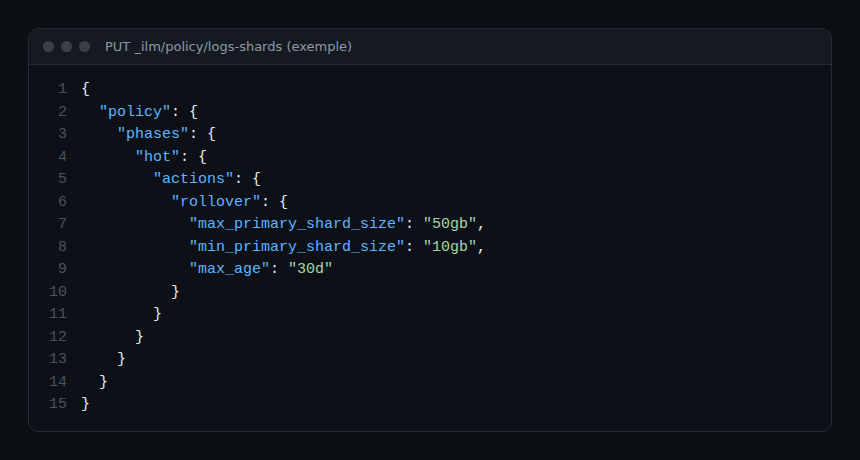
La forma más sencilla de mantener el objetivo es el rollover en la fase hot de una política ILM. Según la referencia de la acción rollover, la acción exige al menos una condición max_*, y el rollover se produce cuando se alcanza una condición max_* y también se cumplen todas las condiciones min_*.
PUT _ilm/policy/logs-shards
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_primary_shard_size": "50gb",
            "min_primary_shard_size": "10gb",
            "max_age": "30d"
          }
        }
      }
    }
  }
}
Esta política es un ejemplo construido a partir de las opciones documentadas; el valor de 30 días es una elección del autor, no una recomendación de Elastic. Los dos umbrales de tamaño recogen los de la página «Size your shards»: 50 GB como máximo, 10 GB como mínimo para evitar shards demasiado pequeños.
Puntos de atención sobre las opciones
max_primary_shard_sizeapunta al shard primario más grande, sin contar las réplicas.max_size, por su parte, figura como obsoleto desde la versión 9.3, conmax_primary_shard_sizecomo sustituto.- Un shard que alcanza 200 000 000 de documentos desencadena un rollover implícito. Un
max_primary_shard_docssuperior no tiene ningún efecto. - Un índice vacío no se pasa a rollover por defecto, aunque se alcance
max_age. Añade"min_docs": 0para permitirlo. - Elastic desaconseja basar el rollover solo en el tiempo: suele producir muchos índices pequeños.
Pasos: auditar tus shards y corregir
- Inventaría los shards, de los más grandes a los más pequeños, con la API cat shards.
- Localiza los índices por debajo de 10 GB y los que superan los 50 GB.
- Aplica una política ILM de rollover por tamaño a los índices nuevos.
- Corrige lo existente con Shrink, Reindex o Split según el caso.
- Vigila el número de shards por nodo a lo largo del tiempo.
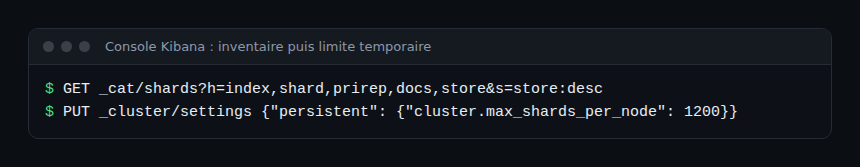
GET _cat/shards?h=index,shard,prirep,docs,store&s=store:descLas columnas index, shard, prirep (primario o réplica), docs y store figuran en la referencia de la API. El parámetro s ordena la salida. Busca las filas cuyo store sea muy pequeño, señal de exceso de fragmentación.
Si el clúster alcanza el límite por nodo, Elastic cita el ejemplo de un cluster.max_shards_per_node elevado a 1200, pero precisa que este ajuste debe ser temporal. Oculta el problema sin resolverlo.
Corregir shards ya mal dimensionados
Los shards son inmutables. Para cambiar su número o su tamaño hay que copiar el índice: Split para añadir shards primarios, Reindex hacia un índice bien configurado para agrupar. Según la página, Restore Snapshot y Clone Index no bastan para este uso.
Cómo comprobar que funciona
Tras algunos ciclos de rollover, vuelve a lanzar la consulta _cat/shards. Los índices nuevos deben situarse entre 10 GB y 50 GB por shard primario. Si muchos índices siguen siendo diminutos, revisa la condición max_age y añade un umbral min_primary_shard_size. En Dynatrace puedes seguir el número de shards y la latencia de búsqueda mediante la extensión descrita en el artículo anterior (SaaS o Managed según la extensión desplegada).
Relación con OpenTelemetry y tus datos de observabilidad
Las trazas, métricas y logs de OpenTelemetry llegan en volumen variable: un pico de tráfico produce un pico de indexación. Un rollover por tamaño se adapta a ese ritmo, mientras que un índice diario no. Para reducir el volumen antes del índice, consulta el tail sampling de OpenTelemetry y, para la diferencia entre señales, observabilidad y monitorización. Para comparar plataformas, nuestra comparativa de Dynatrace y Datadog plantea los criterios de operación.
Buenas prácticas
- Parte de un objetivo de 10 a 50 GB y ajusta con tus propias pruebas de carga.
- Prefiere el rollover por tamaño o por número de documentos al rollover puramente temporal.
- Usa la subida de
max_shards_per_nodesolo como medida temporal. - Planifica el force merge fuera de las horas punta, sobre índices de solo lectura.
- Documenta el tamaño objetivo en tu runbook, sin culpar al equipo que creó los índices existentes.
Preguntas frecuentes
¿Cuál es el tamaño ideal de un shard de Elasticsearch?
Elastic recomienda entre 10 GB y 50 GB, con menos de 200 millones de documentos por shard. Es una referencia: la cifra correcta depende de tus consultas y de tu hardware.
¿Qué ocurre si mis shards son demasiado pequeños?
El clúster soporta un coste fijo por shard y las búsquedas recorren más shards. Agrúpalos con Shrink o Reindex y evita el rollover puramente temporal.
¿Puedo cambiar el tamaño de un shard existente?
No, un shard es inmutable. Hay que copiar el índice con Split o Reindex hacia un índice correctamente configurado.
Conclusión
Quédate con una regla: de 10 a 50 GB por shard, un rollover por tamaño y una auditoría periódica con _cat/shards. Los valores exactos deben validarse con tus datos. Los límites y opciones citados proceden de las páginas oficiales de Elastic consultadas el 30 de octubre de 2026.
Este artículo procede de un blog independiente, no afiliado a Dynatrace LLC ni a Elastic N.V. Elasticsearch es una marca de Elastic N.V. Las cifras citadas son las de la documentación oficial, no mediciones de span.observer. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.