Error Inspector Dynatrace se cita a menudo como «la herramienta de los errores», pero solo cubre una parte del tema. Según la documentación, es una aplicación de la plataforma Dynatrace (SaaS, última generación) que sirve para descubrir, seguir y analizar los errores de front-end de las aplicaciones web y móviles. Los errores del lado de los servicios (HTTP 5xx, excepciones) dependen de otro mecanismo: la detección de fallos de los servicios.
Confundir ambos lleva a discusiones interminables durante un incidente: «Dynatrace dice que hay un 2 % de fallos, el navegador ve un 8 %». Las dos cifras pueden ser correctas, porque no cuentan lo mismo. Entender qué códigos de error se cuentan, de qué lado y con qué ajuste es la condición para construir un SLI de disponibilidad que se sostenga.
Esta guía aclara tres capas: la detección de fallos de los servicios (Managed y SaaS), los errores de petición en RUM Classic con sus códigos especiales 970–979 (Managed y SaaS) y la aplicación Error Inspector (solo SaaS).
Error Inspector Dynatrace: lo que hace realmente la aplicación
Error Inspector es una app de la plataforma que requiere que el RUM esté activado para los frontends web y móviles. Tiene dos páginas:
- Overview: número de errores en el tiempo, desglosado por frontend (los 10 primeros) o por tipo de error (error de petición, excepción, error CSP), y después repartos por
error.type,os.name,url.provider(origen propio o de terceros),browser.nameydt.rum.user_type(real_user, robot, synthetic) en web, yapp.short_versionen móvil. Cada gráfico se abre en un Notebook (Edit in Notebook), se fija en un dashboard o exporta su consulta DQL (Open With). - Explorer: los errores agrupados en todos los frontends, ordenados por número de usuarios afectados. Los filtros se conservan en la URL, lo que permite compartir un análisis con un compañero autorizado.
En el detalle de un error se encuentra la pila de llamadas (legible solo si se han enviado los source maps o archivos de símbolos, por API o por la interfaz clásica), la tabla Affected pages y una tabla Occurrences que abre la sesión en Users & Sessions y, si existen, las trazas en Distributed Tracing. El botón Send transmite un resumen estructurado a Jira, Microsoft Teams o por correo mediante los conectores de Workflows.
Lo que Error Inspector no es: una herramienta de análisis de los errores de servicios de back-end, ni una función de Dynatrace Managed.
Del lado de los servicios: ¿qué códigos HTTP son errores?
Por defecto, la detección de fallos de los servicios cuenta:
- las excepciones (Java, .NET, Node.js, PHP) que interrumpen la llamada al servicio;
- las páginas de error de los contenedores web para las excepciones gestionadas;
- los códigos 500–599 como errores del lado del servidor;
- los códigos 400–599 como errores del lado del cliente.
¿Por qué incluye el lado del cliente los 5xx? Es cuestión de perspectiva: para el servidor, un 4xx es una falta del cliente; para el cliente, un 5xx sigue siendo un error aunque no sea culpa suya. Dos casos particulares están desactivados por defecto: la ausencia de código de respuesta (llamada «fire and forget», timeout) y el 404, clasificado como enlace roto del lado del cliente.
Estas reglas alimentan las métricas que usas en los SLO y las alertas. En Managed, por ejemplo: builtin:service.errors.server.rate, builtin:service.errors.client.rate, builtin:service.errors.fivexx.count y builtin:service.errors.fourxx.count. Cambiar la detección es, por tanto, cambiar el valor de tus SLI: hazlo con conocimiento de causa.
En la práctica: ajustar la detección de fallos
Paso 1: elegir el nivel
La configuración se hace de forma global (Settings > Server-side service monitoring > Failure detection rules y Failure detection parameters) o por servicio. Los ajustes de un servicio tienen prioridad sobre los globales. Las reglas globales se evalúan de arriba abajo, se aplica la primera que coincide y la coincidencia se recalcula cada 10 minutos. No se aplican a los servicios de tipo span ni a los unified services.
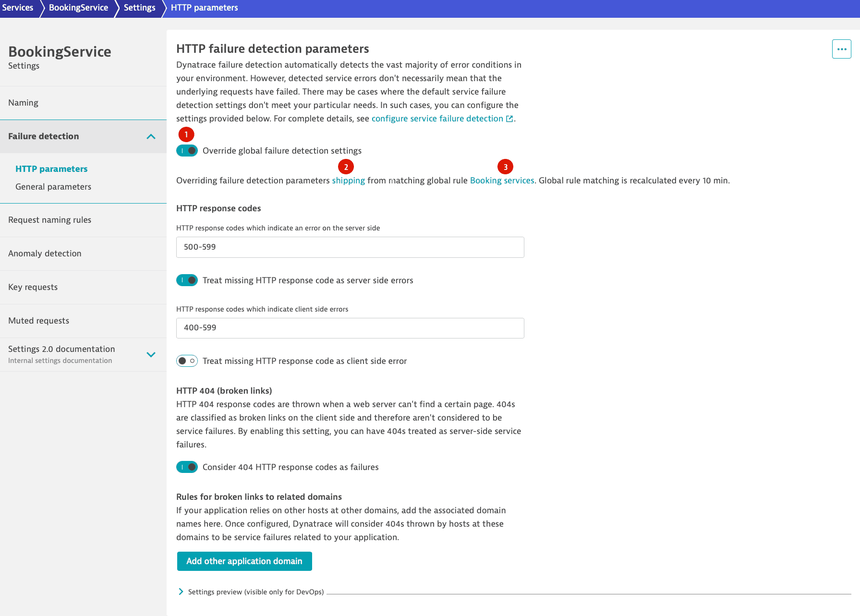
Paso 2: ajustar un servicio
- Abre Services, selecciona el servicio y después More (…) > Settings.
- Ve a Failure detection > HTTP parameters (o General parameters para las excepciones).
- Activa Override global failure detection settings y ajusta los rangos de códigos (varios rangos separados por comas, por ejemplo
400-402, 405-417), el tratamiento de los códigos ausentes y la opción Consider 404 HTTP response codes as failures.
Paso 3: tratar las excepciones de negocio
En General parameters: las Success forcing exceptions hacen que la petición sea exitosa pase lo que pase (cliente que abandona), las Ignored exceptions no marcan el fallo pero dejan que decida el código HTTP, y las Custom handled exceptions fuerzan el fallo de una excepción que el código gestiona en silencio. Para un error de negocio sin excepción ni código HTTP, una custom error rule se apoya en un request attribute.
Paso 4: versionar con la API Settings
Dos esquemas: builtin:failure-detection.environment.parameters (conjuntos de parámetros) y builtin:failure-detection.environment.rules (reglas que los asignan a los servicios), con los scopes settings.read y settings.write. Extracto de un conjunto de parámetros:
[{
  "schemaId": "builtin:failure-detection.environment.parameters",
  "scope": "environment",
  "value": {
    "name": "API publique",
    "httpResponseCodes": {
      "serverSideErrors": "500-599",
      "failOnMissingResponseCodeServerSide": false,
      "clientSideErrors": "401-402,405-499",
      "failOnMissingResponseCodeClientSide": false
    },
    "brokenLinks": { "http404NotFoundFailures": false },
    ...
  }
}]
El cuerpo completo incluye también un bloque exceptionRules; parte del ejemplo de la documentación y de la tabla del esquema en lugar de escribir el objeto a mano.
Del lado del navegador: errores de petición y códigos 970–979 en RUM Classic
En RUM Classic (Managed, y SaaS para las aplicaciones clásicas) existen tres tipos de errores: errores de petición, errores custom enviados por la API JavaScript de RUM y errores de JavaScript. Por defecto, todos los códigos 4xx y 5xx son errores de petición, igual que las violaciones de CSP y los fallos de carga de imágenes. Es una de las razones de las diferencias con las métricas de servicios, que solo cuentan los 5xx del lado del servidor.
Para las aplicaciones creadas a partir de la versión 1.238, el JavaScript de RUM señala además códigos que no son códigos HTTP cuando el código real es inaccesible:
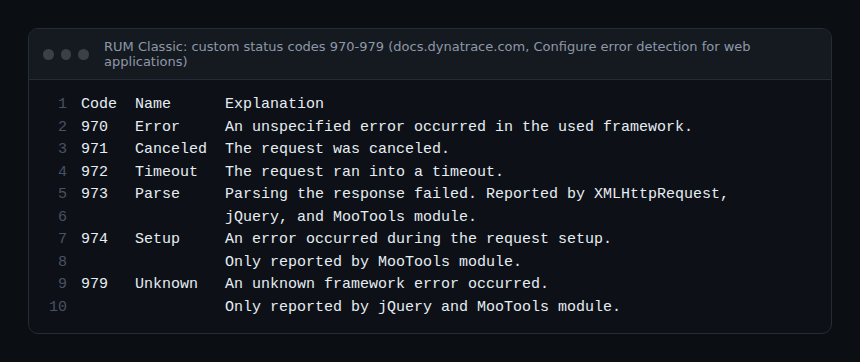
Estos códigos cuentan en el Apdex, pero no en el análisis de Davis. Un 971 en una llamada de seguimiento publicitario cancelada no tiene impacto; un 972 en el pago, sí. Para ignorarlos, desactiva o elimina la regla HTTP 970-979. Para el resto, una request error rule (Web > aplicación > More (…) > Edit > Errors > Request errors) decide para un código o un rango, opcionalmente limitado a ciertas URL, si hay que capturar el error, incluirlo en el Apdex y someterlo a Davis. Las reglas se aplican en el orden de la lista.
Buenas prácticas
- Basa el SLI de disponibilidad de un servicio en los errores del lado del servidor; reserva el lado del cliente y el RUM para la experiencia de usuario.
- No pases los 404 a fallo de forma global: resérvalo para los servicios en los que un 404 señala de verdad un defecto.
- Documenta cada excepción ignorada con el motivo y la fecha; es ruido de menos, pero también un punto ciego de más.
- Envía los source maps en cada despliegue de front-end; si no, Error Inspector muestra pilas ilegibles.
Cómo comprobar que funciona
- Tras un cambio de detección, la tasa
builtin:service.errors.server.ratedel servicio evoluciona en el Data Explorer a partir de la hora del cambio (lo global se recalcula cada 10 minutos). - Con una custom error rule, la petición afectada se marca como fallida y Dynatrace indica que la regla es el motivo.
- En SaaS, la página Overview de Error Inspector muestra el reparto por
error.type; abre el gráfico con Edit in Notebook para obtener la consulta DQL exacta en lugar de reescribirla.
Para relacionar estos errores con los recorridos, consulta las métricas RUM y Core Web Vitals; para remontar de un fallo de servicio a su causa, las Distributed traces en Managed; para convertirlo en un objetivo, elegir tus SLI. Referencias oficiales: Error Inspector y Configure service failure detection.
Preguntas frecuentes
¿Está Error Inspector disponible en Dynatrace Managed?
No. Es una app de la plataforma Dynatrace SaaS de última generación. En Managed, se recurre a la detección de fallos de los servicios y a la configuración de errores de RUM Classic.
¿Por qué cuenta el RUM más errores que las métricas de servicio?
RUM Classic cuenta por defecto todos los 4xx y 5xx, las violaciones de CSP, las imágenes fallidas y los códigos 970–979, mientras que el error del lado del servidor de un servicio solo retiene los 5xx y las excepciones.
¿Significa un código 971 una caída?
No necesariamente. Es un código propio del JavaScript de RUM (petición cancelada), no un código HTTP. Su impacto depende de la petición: mira la URL afectada antes de alertar.
Conclusión
Error Inspector responde a una pregunta precisa: qué errores de front-end afectan a más usuarios y por qué. Los códigos de error de los servicios y de RUM Classic, en cambio, se ajustan en la detección de fallos y en las request error rules. Alinea estas tres capas, documenta cada excepción y tus SLI de disponibilidad dirán por fin lo mismo que tus usuarios.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.