Cardinalidad de métricas de Kubernetes: el coste viene de las etiquetas (labels) mucho antes que del tráfico de las aplicaciones. Cada combinación única de labels crea una serie temporal distinta, y buena parte de esas series nunca se muestra, ni en un panel ni en una regla de alerta. Aun así se recopilan, se almacenan y se facturan o se dimensionan igual que las demás.
Esta guía propone un método en cuatro tiempos: medir, detectar las métricas que nadie lee, recortar en el origen y poner barreras de seguridad. Los ejemplos se basan en Prometheus y kube-state-metrics, la configuración más extendida. El enfoque sigue siendo válido para un Collector de OpenTelemetry que envía a Dynatrace SaaS o Managed. Complementa el módulo sobre las métricas de Kubernetes en Grail.
En resumen
- Una serie = un nombre de métrica + un conjunto de labels. Un label más puede multiplicar el número de series.
- La API
/api/v1/status/tsdbde Prometheus clasifica las métricas y los labels más costosos. - Se recorta en tres niveles: el exportador, el scrape (
metric_relabel_configs) y el Collector. - Un tope
sample_limitprotege la plataforma, pero hace fallar todo el scrape cuando se supera.
Por qué se dispara la cardinalidad de métricas de Kubernetes
Según la documentación de Prometheus sobre nomenclatura, cada combinación única de pares clave-valor de labels representa una nueva serie temporal, lo que puede aumentar mucho el volumen almacenado. La página desaconseja usar labels para dimensiones de alta cardinalidad, como identificadores de usuario o direcciones de correo electrónico.
Kubernetes fabrica este problema de forma natural. Un pod tiene un nombre y un identificador únicos, y cada despliegue crea otros nuevos. Las métricas de kube-state-metrics llevan, por ejemplo, los labels pod, namespace y uid, según la documentación de las métricas de pods. La métrica kube_pod_container_info añade image, image_id y container_id. En cada redespliegue esos valores cambian y aparecen series nuevas.
Por tanto, el coste no depende solo del número de pods. Depende también de la tasa de renovación: unas series antiguas desaparecen, otras nacen, y la base de datos tiene que indexarlo todo. El tema es distinto de la alerta sobre nodos y cuotas: aquí se reduce lo que se recopila, en lugar de decidir qué vigilar.
Paso 1: medir con la API TSDB de Prometheus
Antes de recortar hay que saber adónde va el volumen. La API de estado de la TSDB responde a esa pregunta. Según la documentación de la API HTTP, el endpoint es GET /api/v1/status/tsdb, añadido en la versión 3.6.0 según esa misma página. El parámetro opcional limit acota el número de elementos por estadística (10 por defecto, 10 000 como máximo).
curl -s 'http://localhost:9090/api/v1/status/tsdb?limit=20'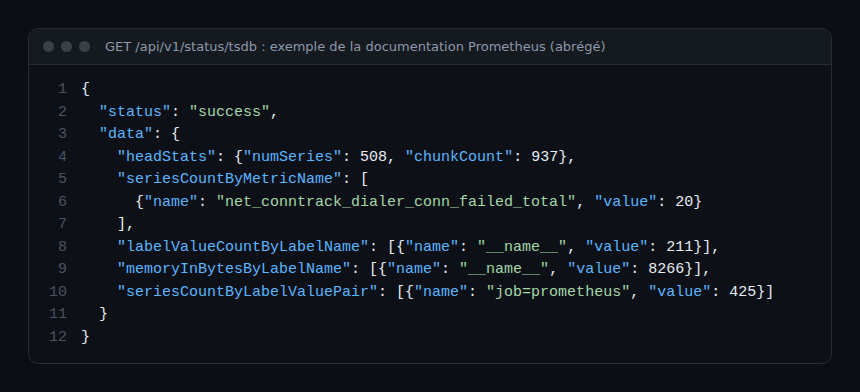
La respuesta ofrece cinco bloques útiles:
headStats: número total de series (numSeries) y de chunks en el bloque de cabecera;seriesCountByMetricName: las métricas con más series;labelValueCountByLabelName: los labels con más valores distintos;memoryInBytesByLabelName: la memoria consumida por label, calculada sumando la longitud de todos los valores;seriesCountByLabelValuePair: los pares label=valor que concentran más series.
La página nombra el último campo de dos maneras: la lista habla de seriesCountByLabelPair y el ejemplo de seriesCountByLabelValuePair. Comprueba el nombre exacto en tu servidor.
Paso 2: detectar las métricas que nadie lee
Una métrica «nunca leída» no aparece en ninguna regla de alerta, ningún panel ni ninguna consulta de guardia. Ninguna API la señala automáticamente: el inventario se hace a mano, cruzando dos listas.
- Exporta los diez a veinte nombres más voluminosos desde
seriesCountByMetricName. - Busca cada uno en tus reglas de alerta, tus reglas de grabación y tus paneles (basta un simple
grepsobre el repositorio de configuración). - Por cada métrica que no encuentres, pregunta al equipo propietario: ¿quién la usó por última vez y para qué incidente?
- Clasifica: conservar, conservar sin ciertos labels, eliminar.
Se conservan las señales que sirven a un SLI o a un diagnóstico y se retira el resto para reducir el toil. El texto sobre observabilidad y monitorización recuerda por qué recopilar más no sustituye a recopilar bien.
Paso 3: recortar en el origen en kube-state-metrics
Lo más económico es no producir la métrica. Según la documentación de los argumentos de kube-state-metrics, importan tres opciones:
--resources: lista de recursos habilitados, separados por comas;--metric-denylist: métricas que no se habilitan, por nombre exacto o por expresión regular;--metric-labels-allowlist: labels de Kubernetes que se añaden a la métrica de labels del recurso.
Las opciones --metric-allowlist y --metric-denylist son mutuamente excluyentes. Elige una u otra.
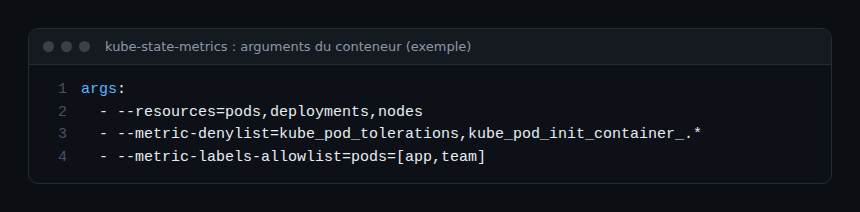
En el ejemplo anterior solo se exportan tres tipos de recursos, se descartan dos familias de métricas experimentales y solo se copian los labels app y team de los pods. Según la documentación de las métricas de pods, kube_pod_tolerations está marcada como EXPERIMENTAL, igual que las métricas kube_pod_init_container_* de estado detallado. Relee la página de la versión desplegada antes de copiar esta lista.
Paso 4: recortar en el scrape con metric_relabel_configs
Cuando el exportador no se puede modificar, Prometheus puede descartar series antes de la ingesta. La referencia de configuración precisa que el relabeling de métricas se aplica a las muestras como último paso antes de la ingesta, con el mismo formato y las mismas acciones que el relabeling de targets. Cita la exclusión de series demasiado costosas entre sus usos. No se aplica a las series generadas automáticamente, como up.
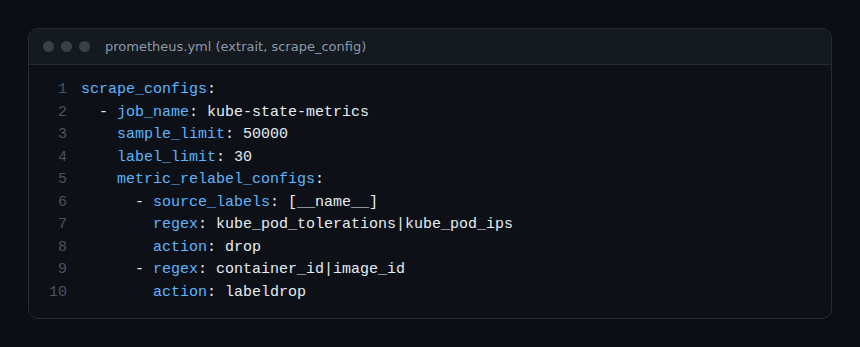
Aquí sirven dos acciones:
drop: elimina las series cuyoregexcoincide con lossource_labelsconcatenados (aquí el nombre de la métrica,__name__);labeldrop: retira los labels cuyo nombre coincide con elregex.
Cuidado con labeldrop. La documentación pide asegurarse de que las métricas sigan identificándose de forma única una vez retirados los labels. Si dos series pasan a ser idénticas, entran en colisión. Retira primero labels que no identifiquen nada útil, como un identificador de contenedor, y comprueba el efecto sobre numSeries tras el cambio.
Paso 5: poner barreras de seguridad
Los límites de scrape convierten un riesgo silencioso en una alerta visible. Según la misma referencia, sample_limit fija un límite por scrape sobre el número de muestras aceptadas. El recuento se hace después del relabeling de métricas y, si se supera, el scrape entero se considera fallido. El valor 0 significa «sin límite». label_limit limita el número de labels por muestra, con el mismo comportamiento si se supera.
Este comportamiento tiene un coste: un exceso hace perder todas las métricas del target, no solo las series sobrantes. Ajusta por tanto el límite con margen, por ejemplo por encima del máximo observado, y alerta sobre el fallo del scrape (la serie up pasa a 0). Un tope sirve para detectar una deriva, no para sustituir el inventario de los pasos 1 y 2.
Del lado de OpenTelemetry: filtrar en el Collector
Si las métricas pasan por un Collector, el procesador filter descarta datos antes de la exportación. El README del procesador filter da la clave actual, metric_conditions, e indica que la antigua clave metrics.metric está obsoleta y se eliminará. Su ejemplo elimina los puntos de una métrica según una condición OTTL:
processors:
  filter:
    error_mode: ignore
    metric_conditions:
      - metric.name == "k8s.pod.phase" and datapoint.value_int == 4
Este ejemplo es el de la documentación. Sustituye la condición por la tuya tras probarla en un entorno no crítico. Para el despliegue completo del Collector, consulta la guía del Collector en Kubernetes; para comparar ambos mundos, OpenTelemetry y Prometheus. El camino de Prometheus a Dynatrace se detalla en este artículo.
Cómo comprobar que funciona
- Vuelve a lanzar
curl 'http://localhost:9090/api/v1/status/tsdb?limit=20'y comparanumSeriesantes y después, durante un periodo comparable. - Comprueba que las métricas eliminadas ya no aparecen en
seriesCountByMetricName. - Verifica que las alertas y los paneles críticos siguen devolviendo datos.
- Vigila el estado de los targets: un
sample_limitdemasiado bajo se nota por un scrape fallido.
Buenas prácticas
- Mide antes de recortar y anota el
numSeriesinicial. - Prefiere una lista blanca de recursos a una lista negra cuando el alcance es conocido.
- No uses nunca un label de valores ilimitados en tus propias métricas.
Preguntas frecuentes
¿Qué es la cardinalidad de una métrica?
Es el número de series temporales distintas que produce, es decir, el número de combinaciones de valores de labels observadas. Cuantos más valores posibles tiene un label, más sube la cardinalidad.
¿Cómo saber qué métricas cuestan más?
Consulta la API /api/v1/status/tsdb de Prometheus: clasifica las métricas por número de series y los labels por número de valores distintos. Según la documentación, esta API está disponible a partir de la versión 3.6.0.
¿Se puede perder información útil al eliminar labels?
Sí. Retirar un label con labeldrop puede fusionar series u ocultar una dimensión de análisis. Comprueba primero que ninguna alerta ni ningún panel lo usa, y prueba con un solo job de scrape.
Conclusión
Reducir la cardinalidad de métricas de Kubernetes no es un ejercicio de compresión: es una clasificación por uso. Medir con la API TSDB, encontrar las métricas sin lector, recortar en el origen y poner un tope al scrape basta para recuperar el control de la factura, sin tocar las señales que sirven a los SLO.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC; los nombres de productos citados (Prometheus, kube-state-metrics, OpenTelemetry, Kubernetes) pertenecen a sus respectivos propietarios. Las configuraciones son ejemplos que hay que adaptar y probar antes de cualquier uso en producción. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.