Caveman reducir tokens: esa es la promesa del repositorio JuliusBrussee/caveman, una skill y un proxy para agentes de código (Claude Code, Codex, Gemini CLI y otros) que piden al agente respuestas breves y menos lectura. El repositorio tiene unas 115 000 estrellas a finales de octubre de 2026, según su página de GitHub. El README cuenta que nació como una broma en abril de 2026.
Para un equipo de operaciones, la cuestión no es el tono del agente, sino el coste: tokens consumidos por sesión, por herramienta y por día, que nadie mide hasta que llega la factura. Este artículo presenta el proyecto según su README y después muestra qué métricas vigilar en la observabilidad de LLM, incluidas las que el propio proyecto ofrece.
Aviso de honestidad: span.observer es un blog independiente y no ha instalado Caveman. Los comandos y las cifras proceden del README, leído el 26 de octubre de 2026; son afirmaciones del proyecto, no mediciones del blog.
Caveman reducir tokens: qué hace el proyecto
- Autor y licencia: el repositorio es de Julius Brussee. El README indica Apache-2.0 para todo el repositorio, y el archivo LICENSE es efectivamente el texto de la licencia Apache 2.0. Un archivo LICENSING.md trata las versiones antiguas. El nombre «Caveman» y el logotipo son marcas del autor.
- Cifras leídas el 26 de octubre de 2026: unas 115 000 estrellas, unos 6600 forks, 1886 commits. La página no muestra ninguna release en su lateral, pero el README enlaza las notas de la versión 4.0.0 y fija la v4.0.1 en sus scripts de instalación.
- Seis piezas («rocks» en el README): Say less (respuestas cortas), Read less (compresión de logs, JSON, CSV y salidas de tests antes de que el modelo los lea), Auto (elección del modelo y del nivel de esfuerzo), Blocks (scripts reutilizables), Waste fixes (detección del desperdicio) y Browse (páginas web comprimidas).
El principio de la voz: primero la respuesta, una idea por frase, pero el código, los comandos, las rutas y los mensajes de error quedan intactos. El README insiste en un punto: el proyecto nunca reescribe tus prompts, porque cita un estudio (Adobe Research) según el cual hacerlo empeora las respuestas.
Visita al informe Caveman Learn
Según el README, el comando caveman learn clasifica dónde se van tus tokens a partir del historial de agentes que ya está en el disco. El repositorio publica una captura del informe generado.
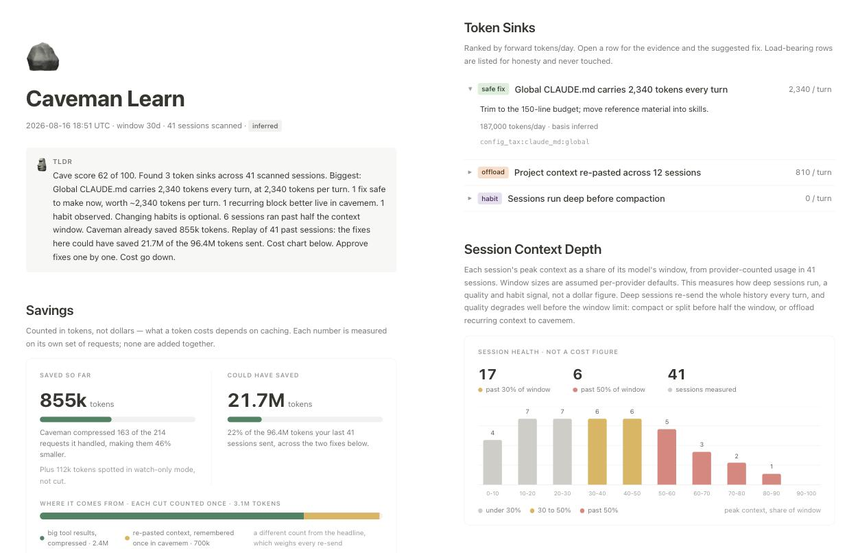
La captura procede del README del repositorio (licencia Apache-2.0). Muestra un resumen, tarjetas «Saved so far» y «Could have saved», una lista de puntos de desperdicio (por ejemplo, un CLAUDE.md global que añade tokens en cada turno) y un histograma de la parte de la ventana de contexto que usa cada sesión. El informe precisa que las cifras se cuentan en tokens, no en dólares, porque el precio de un token depende de la caché. Estos valores son de una sesión de demostración: los tuyos serán distintos.
Instalación paso a paso, según el README
- Requisito: Node.js 22.13 o posterior. El README anuncia Mac, Linux y Windows.
- Instalar con un solo comando, que detecta tus agentes y muestra lo que cambia antes de aplicarlo:
npx @caveman-ai/cli@latest - Comprobar el estado con
caveman statusycaveman doctor. Si tenías Caveman antes de la versión 4.0, el README pide escribir@latest; si no, gana la copia local antigua. - Variante «solo skill», sin el proxy:
npx skills add JuliusBrussee/caveman -gy después
/cavemanen el agente ($cavemanen Codex);stop cavemanvuelve al modo normal. - Variante plugin de Claude Code:
claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman
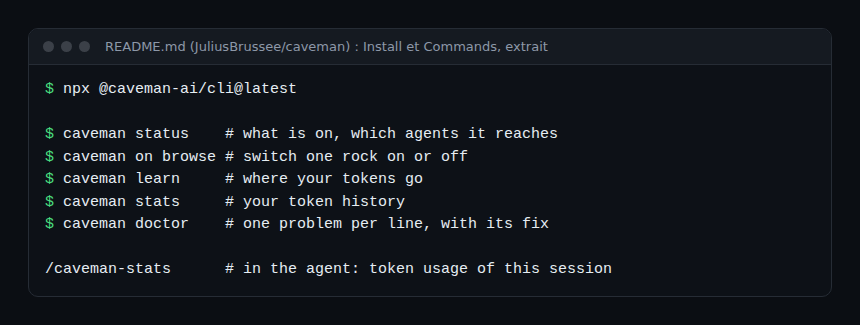
Para desinstalar, el README da npx -y github:JuliusBrussee/caveman -- --uninstall (con --allow-git=root además en npm 12 o posterior). Para Windows ofrece un script de PowerShell 5.1 o posterior. Lee estos scripts antes de ejecutarlos: un curl ... | bash ejecuta código remoto.
Qué métricas vigilar para supervisar los tokens
Caveman ofrece caveman stats (historial de tokens) y /caveman-stats (uso real de una sesión de Claude Code). Son vistas locales. Un equipo necesita además una medición independiente, del lado de la observabilidad de LLM. Las convenciones semánticas de OpenTelemetry para IA generativa definen para ello los atributos gen_ai.usage.input_tokens y gen_ai.usage.output_tokens en los spans, y la métrica gen_ai.client.token.usage. Estas convenciones tienen estado Development y ahora viven en un repositorio propio: consulta nuestro artículo sobre el coste de un agente de IA en tokens con OpenTelemetry para el detalle y las reservas.
Cuatro indicadores bastan para empezar:
- Tokens de entrada por sesión: crecen en cada turno porque el contexto se acumula. Es la parte que «Read less» dice reducir.
- Tokens de salida por petición: la parte a la que apunta la voz concisa.
- Llamadas a herramientas por tarea: un agente que da vueltas se nota aquí antes que en la factura.
- Tareas resueltas: un ahorro de tokens que hace fallar más tareas no vale nada. Mide ambas cosas juntas.
Método SRE: registra estos indicadores una semana antes de instalar y otra semana después, con tareas comparables. Sin línea base, ningún ahorro es demostrable. Si ya pones un proxy de compresión delante de tus modelos, compáralo con Headroom, compresión de contexto para LLM, que expone sus propias métricas. Para controlar lo que hace el agente, consulta también T3 Code y el control de agentes de código.
Lo que afirma el proyecto (y sus reservas)
El README publica muchas cifras. Estas son algunas, con las reservas que figuran en el propio README:
- En diez preguntas de desarrollo, el README cuenta 6983 tokens de salida sin instrucción, 4334 con «Answer concisely.», 4119 con
/cavemany 2693 con/ultracave. Señala que «sé conciso» es la verdadera base de comparación y que estas mediciones son de las reglas de la versión 3.1.0, sin repetir. - Para «Read less», el README anuncia un 33,2 % menos de tokens de entrada en sesiones completas (54 ejecuciones de Claude Code). Precisa que la medición es de agosto de 2026 con un motor antiguo y que el HTML empeora un 9,9 % por falta de compresor.
- Para «Auto», anuncia un 54 % menos de coste en 85 tareas, precisando que la prueba está a medias y que la diferencia de puntuación es demasiado pequeña para concluir.
- Las reglas de la voz cuestan unos 1160 tokens de entrada, y si pagas por petición (GitHub Copilot), las respuestas más cortas no ahorran nada.
Estas cifras son del autor, sobre sus propios conjuntos de tareas. No las tomes como promesa para tu equipo: mide las tuyas.
Límites y puntos abiertos
- Telemetría activada por defecto: según la sección «Privacy» del README, la CLI envía estadísticas de uso (comandos ejecutados, número de tokens, un identificador de instalación aleatorio, sistema, dirección IP), pero no tus prompts, tu código ni tus rutas. Para desactivarla:
caveman telemetry offoDO_NOT_TRACK=1. Decídelo antes de un despliegue en la empresa. - Auto envía datos: una vez iniciada la sesión, Auto envía a Caveman Cloud tu última petición y lo que el agente adjunte (CLAUDE.md, archivos citados). No lo actives sin una revisión de seguridad.
caveman off routinglo detiene. - Cifras internas: el eslogan de GitHub del repositorio habla de «65 % menos de tokens», mientras que el README detalla resultados muy variables (8,5 % menos de tokens de salida en la prueba de JetBrains citada, 3 % más que «sé conciso» para
/caveman). Quédate con el detalle, no con el eslogan. span.observer no ha leído los estudios citados (Adobe, JetBrains, Elastic): son afirmaciones del README. - Madurez: el proyecto es de abril de 2026 y lo mantiene, según el README, una sola persona. Blocks es una versión preliminar (v0.1.0-rc.5), y el README señala que el uso en la aplicación de Claude aún no está probado de extremo a extremo.
- Licencias: la página de GitHub detecta Apache-2.0 y MIT; el README dice Apache-2.0 para todo el repositorio. Lee LICENSING.md para las versiones antiguas y los avisos de terceros.
Buenas prácticas
- Instala primero en un equipo de pruebas y lee la lista de cambios que muestra el instalador.
- Desactiva la telemetría y deja Auto apagado hasta validar la política de datos.
- Mide tokens y tasa de éxito antes y después, con las mismas tareas.
- Conserva las alertas de coste de tu proveedor, independientes de la herramienta.
- Deja el código, los comandos y los errores en texto completo: revisa siempre un diff antes de aceptarlo.
Preguntas frecuentes
¿Caveman ahorra tokens de verdad?
El README publica mediciones, pero proceden del autor, sobre sus propios conjuntos de tareas y con reservas escritas. Cuenta tus propios tokens antes y después.
¿Caveman es gratuito y libre?
El README indica Apache-2.0 para todo el repositorio. El modo Auto requiere una cuenta gratuita y existe un plan Free; sus condiciones dependen de Caveman Cloud, no de la licencia del repositorio.
¿Qué hay que supervisar en producción?
Los tokens de entrada y de salida por sesión, el número de llamadas a herramientas, la tasa de éxito de las tareas y las conexiones salientes de la herramienta. Las convenciones GenAI de OpenTelemetry dan los nombres de las métricas.
Conclusión
Caveman es un proyecto popular y muy documentado, pero sus cifras siguen siendo las de su autor. Para un equipo SRE, el enfoque es el de cualquier dependencia nueva: leer, instalar a pequeña escala, desactivar la telemetría y medir los tokens antes de creer en los ahorros. Fuentes: repositorio JuliusBrussee/caveman y convenciones semánticas GenAI de OpenTelemetry.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni al autor de Caveman ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba siempre los comandos y las opciones en su documentación oficial.