claude-mem memoria persistente agentes: el repositorio thedotmack/claude-mem se presenta como un «sistema de compresión de memoria persistente» creado para Claude Code. Observa lo que hace el agente durante una sesión, lo resume y reinyecta lo esencial al arrancar la sesión siguiente. A finales de octubre de 2026 el repositorio mostraba unas 103 000 estrellas y 9 100 forks, con licencia Apache 2.0 y la versión 15.2.1 indicada en el README.
Para un equipo de operaciones es un pequeño servicio que funciona junto al agente. Escucha cada llamada a una herramienta, llama a un modelo de lenguaje para resumirla, guarda el resultado y modifica el contexto de cada sesión nueva. La latencia, el coste en tokens, la calidad de lo que se recupera y la privacidad pasan a ser asuntos de operación. Este artículo sigue el README y la documentación del repositorio, leídos el 26 de octubre de 2026.
Aviso de honestidad: span.observer no ha instalado claude-mem. Los comandos vienen del README, los ajustes de la documentación oficial y la captura de la interfaz del propio repositorio del proyecto. Para otro enfoque de la memoria de agentes, véase Hindsight, memoria de agentes de IA: el enfoque es distinto, como se explica más abajo.
claude-mem memoria persistente agentes: lo que dice el repositorio
- Autor y licencia: el README cita a Alex Newman (
@thedotmack) como autor. El archivo LICENSE es el texto estándar de la Apache License 2.0 y el README lo confirma. Los archivosdocs/license.mdydocs/ip-boundary.mddescriben una estructura «open-core»: el motor de memoria, el servidor, la CLI, los adaptadores y las herramientas MCP son Apache 2.0, mientras que una nube alojada, la sincronización de equipo, la administración y el SSO quedan reservados fuera del repositorio público. - Tecnología: TypeScript, Node.js 20 o superior, Bun como gestor de procesos, SQLite con búsqueda de texto completo FTS5 y, opcionalmente, la base vectorial Chroma (instalada mediante
uv). - Principio: los hooks del ciclo de vida de Claude Code (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) pasan los eventos a un worker local. El worker pide a un modelo que los comprima en «observaciones» estructuradas.
- Cifras leídas el 26 de octubre de 2026: unas 103 000 estrellas y 9 100 forks según la página del repositorio; versión 15.2.1 según la insignia del README y el paquete npm. Las estrellas las leyó una herramienta de resumen de páginas: vuelve a comprobarlas antes de citarlas en otro sitio.
El README también lista instaladores para otros entornos además de Claude Code (OpenCode, T3 Code, Antigravity, OMP, Pi, OpenClaw). Este artículo se limita a Claude Code, el caso original.
Recorrido por la interfaz: el viewer web
El worker sirve una interfaz web, el «viewer», que muestra en directo las observaciones guardadas. La captura siguiente es un fotograma de la animación cm-preview.gif publicada en el repositorio del proyecto: a la izquierda una sesión de Claude Code y a la derecha el viewer.
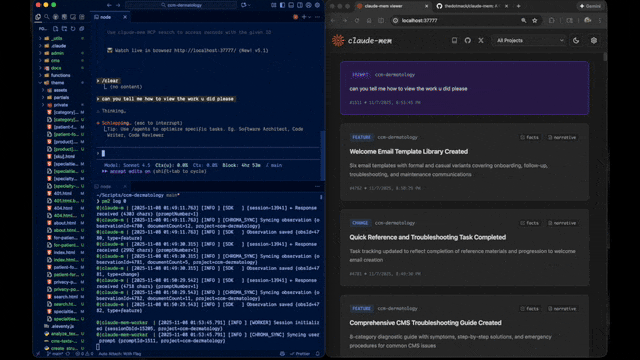
Cada tarjeta lleva un tipo (por ejemplo change o feature), un título, una breve narración y un identificador. Según la documentación, el viewer se actualiza mediante Server-Sent Events y se filtra por proyecto. Allí también se editan los ajustes de contexto, con vista previa en directo.
Cómo se comprime y se reinyecta la memoria
El flujo descrito en la documentación de arquitectura cabe en una línea: un hook escribe en la base de datos, el worker lee y procesa las entradas con el SDK del agente y el hook de la sesión siguiente vuelve a leer los resúmenes. En la práctica:
- Captura: tras cada llamada a una herramienta (PostToolUse), el hook envía el evento al worker. La documentación habla de «más de 100 veces» por sesión.
- Compresión: el worker entrega cada evento a un modelo. Por defecto,
CLAUDE_MEM_MODELvaleclaude-haiku-4-5-20251001con el proveedorclaude; se listan otros proveedores:codex,gemini,openrouter,openai-compatible. - Resumen: cuando el agente se detiene (Stop), un resumen final registra la petición, lo que se hizo y lo que se aprendió.
- Reinyección: en el siguiente arranque, el hook de contexto añade las últimas observaciones. El valor por defecto es 50 (
CLAUDE_MEM_CONTEXT_OBSERVATIONS).
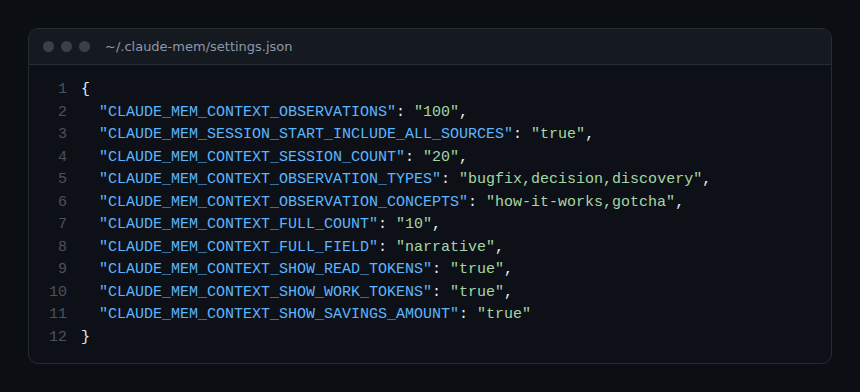
La captura muestra el ejemplo de configuración manual de la documentación: cien observaciones, veinte sesiones, filtrado por tipo (bugfix, decision, discovery) y visualización del coste en tokens de lectura. No son los valores por defecto.
Búsqueda en tres capas
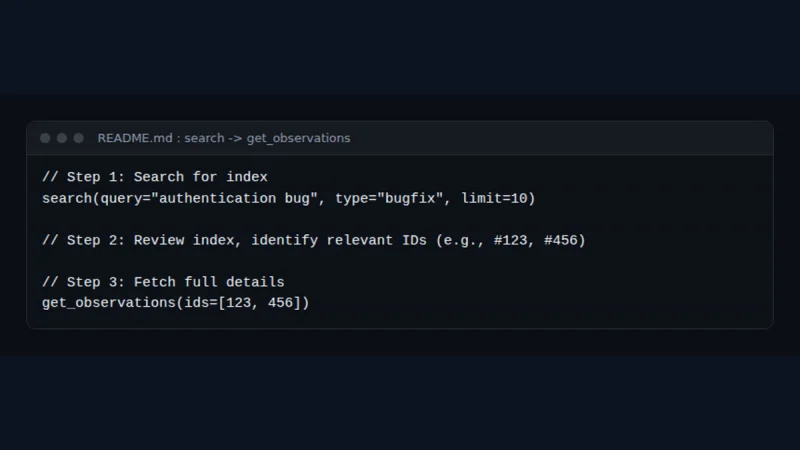
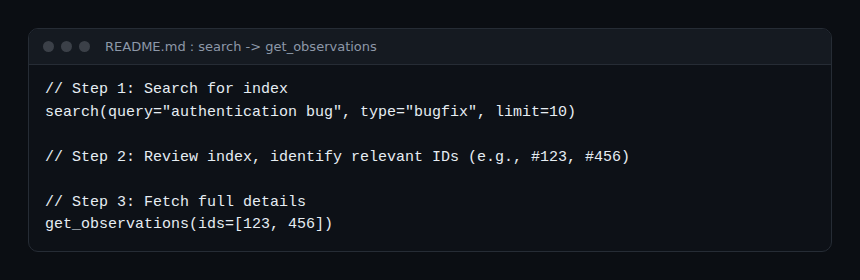
El proyecto defiende la «divulgación progresiva»: mostrar primero un índice barato y buscar el detalle solo cuando hace falta. El README describe tres herramientas MCP: search (índice compacto), timeline (contexto cronológico) y get_observations (detalle de los identificadores filtrados). El proyecto afirma un ahorro de unas diez veces en tokens; es una afirmación del README, no una medición reproducida aquí.
Instalación paso a paso
Requisitos
El README pide Node.js 20 o superior, una versión reciente de Claude Code con soporte de plugins, Bun y uv (se instalan automáticamente si faltan) y SQLite 3 (incluido).
Paso 1 — Ejecutar el instalador
npx claude-mem installEl README precisa que npm install -g claude-mem instala solo el SDK, sin registrar los hooks ni el worker. Tras la instalación, la herramienta propone iniciar sesión por correo en una cuenta de claude-mem con una prueba gratuita de 30 días del «observador» alojado. Para evitarlo, el README propone pasar un indicador --provider explícito, definir CLAUDE_MEM_ONLINE_OPTIN=false o trabajar en un shell no interactivo.
Paso 2 — O usar el marketplace de plugins
/plugin marketplace add thedotmack/claude-mem

/plugin install claude-mem
Reinicia Claude Code: según el README, el contexto de las sesiones anteriores aparece después automáticamente en las nuevas.
Paso 3 — Windows
Los hooks no necesitan Git Bash. El instalador coloca un lanzador claude-mem.exe en %LOCALAPPDATA%\claude-mem\bin y lo añade al Path del usuario; reinicia el terminal después. Ante un error «Executable not found in $PATH: “claude-mem”», el README remite a npx claude-mem doctor.
Cómo comprobar que funciona
- Ejecuta
npx claude-mem doctor: según la documentación, muestra una fila sobre el lanzador de hooks. - Inicia una sesión de Claude Code, haz algunas acciones y abre el viewer en la dirección que el worker muestra al arrancar. Deberían aparecer tarjetas de observaciones.
- Consulta el worker:
curl -s http://127.0.0.1:$CLAUDE_MEM_WORKER_PORT/api/health, comando que da la documentación de configuración para leer el puerto activo.
Observar claude-mem en producción
La documentación no describe exportación OpenTelemetry ni métricas Prometheus. Lo que sí permite seguir:
- Salud del worker: un servicio HTTP local, puerto por defecto
37700 + (uid % 100), modificable conCLAUDE_MEM_WORKER_PORT. La página «Worker Service» citaGET /healthy la de configuraciónGET /api/health: comprueba cuál responde en tu versión. - Cola:
GET /api/pending-queuemuestra los mensajes pendientes, en proceso, procesados o fallidos (tres intentos por defecto) y el número de mensajes «atascados» (más de cinco minutos en proceso).POST /api/pending-queue/processreinicia el procesamiento. Es el indicador adecuado tras una caída. - Registros: carpeta
logs/del directorio de datos (~/.claude-mempor defecto,CLAUDE_MEM_DATA_DIR), con el nivel fijado porCLAUDE_MEM_LOG_LEVEL(DEBUG, INFO, WARN, ERROR, SILENT). Las páginas de la documentación nombran los archivos de forma distinta (worker-out.logen una,worker-YYYY-MM-DD.logen otra). - Volumen almacenado:
GET /api/stats(recuentos por proyecto) y el archivoclaude-mem.dbpermiten seguir el crecimiento. - Coste: cada observación pasa por un modelo. El seguimiento de tokens se hace en el proveedor; el método de el coste de un agente de IA en tokens con OpenTelemetry es aplicable, y el de observar agentes MCP con OpenTelemetry para las llamadas a las herramientas de búsqueda.
El worker escucha en 127.0.0.1 por defecto (CLAUDE_MEM_WORKER_HOST). La documentación recomienda mantenerlo así para quien no use el acceso remoto. Para el marco general de supervisión de un agente de código, véase supervisar un agente de código en la empresa.
En qué se distingue claude-mem de Hindsight
El artículo sobre Hindsight describe un servidor de memoria que se despliega con PostgreSQL y al que cualquier agente llama mediante una API y las operaciones retain, recall y reflect. claude-mem parte de otro lugar: se engancha a los hooks de Claude Code, no exige código en el agente, guarda todo en local en SQLite y reinyecta un índice al inicio de cada sesión. El primero es una pieza de memoria para construir un agente; el segundo, un complemento para un agente de código ya existente.
Límites y puntos abiertos
- Datos sensibles: cualquier llamada a una herramienta puede capturarse, incluidas rutas, comandos y fragmentos de archivos. El README describe etiquetas
<private>para excluir contenido, y la documentación detalla filtros (CLAUDE_MEM_SKIP_TOOLS,CLAUDE_MEM_SKIP_BASH_PATTERNS, proyectos excluidos). Solo protegen lo que se te ocurrió excluir. - Oferta comercial en primer plano: el README destaca el inicio de sesión en una cuenta, una prueba gratuita de 30 días y una memoria alojada por defecto en uno de los instaladores. El proyecto afirma hasta un 100 % más de uso en tu plan: es un argumento comercial, no verificado aquí. La instalación local sigue siendo posible.
- Token comunitario: el final del README habla de CMEM, un token creado por un tercero pero «oficialmente acogido» por el autor. span.observer ni lo recomienda ni lo comenta; es una señal de prudencia para quien evalúe el proyecto.
- Marco open-core: algunas funciones anunciadas (equipo, SSO, nube) quedan reservadas fuera del repositorio Apache 2.0, según
docs/ip-boundary.md. - Documentación desigual: la misma información (salud del worker, nombres de los registros) difiere de una página a otra, y el README describe primero la instalación para Grok Bot y después Claude Code. La cifra de «10 veces menos tokens» y el «100 % de eficacia» del skill son afirmaciones del proyecto.
- Proyecto muy activo: versión 15.2.1, más de 3 600 commits según la página del repositorio; las opciones cambian rápido.
Buenas prácticas
- Pruébalo primero en un proyecto sin secretos, con
CLAUDE_MEM_CONTEXT_OBSERVATIONSbajo. - Añade tus patrones sensibles a
CLAUDE_MEM_SKIP_BASH_PATTERNSantes del uso real y mantén el worker en127.0.0.1. - Elige explícitamente el proveedor de compresión, con el modelo más barato que sirva, y sigue el consumo en su lado.
- Haz una copia de la carpeta de datos antes de una actualización y vigila la cola tras un reinicio.
- Revisa lo que se memoriza: una observación errónea se reinyecta en cada sesión.
Preguntas frecuentes
¿claude-mem es gratuito y de código abierto?
El código del repositorio es Apache 2.0 según el archivo LICENSE. El README ofrece además un servicio alojado con prueba gratuita de 30 días; según sus indicaciones, es opcional.
¿Salen mis datos de mi máquina?
Las observaciones se guardan en una base SQLite local. Pero el resumen pasa por un modelo: Claude por defecto, o Gemini, OpenRouter u otro proveedor según CLAUDE_MEM_PROVIDER. El contenido de las llamadas a herramientas se envía, por tanto, a ese proveedor. La sincronización en la nube es un servicio aparte descrito por el proyecto.
¿En qué se diferencia de un archivo CLAUDE.md?
Un archivo de instrucciones se escribe a mano y se lee entero en cada sesión. claude-mem genera las entradas automáticamente e inyecta solo un índice acotado, que se detalla después bajo demanda. Ambos se complementan.
Conclusión
claude-mem automatiza una tarea que los equipos hacen a mano: contarle al agente lo que pasó ayer. Se instala con un solo comando y se ajusta mediante un archivo JSON. Hay que tratarlo como un servicio: vigilar su cola, contar sus tokens y limitar lo que memoriza. Fuentes: repositorio thedotmack/claude-mem y documentación oficial.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial.