Caveman réduire tokens : c’est la promesse du dépôt JuliusBrussee/caveman, une « skill » et un proxy pour agents de code (Claude Code, Codex, Gemini CLI et d’autres) qui demandent à l’agent de répondre court et de lire moins. Le dépôt compte environ 115 000 étoiles à la fin d’octobre 2026, d’après sa page GitHub. Le README raconte qu’il est né comme une blague en avril 2026.
Pour une équipe d’exploitation, la question n’est pas le ton de l’agent. C’est le coût : des tokens consommés par session, par outil et par jour, que personne ne mesure tant que la facture n’arrive pas. Cet article présente le projet d’après son README, puis montre quelles mesures suivre côté observabilité LLM, y compris celles que le projet fournit lui-même.
Précision d’honnêteté : span.observer est un blog indépendant et n’a pas installé Caveman. Les commandes et les chiffres viennent du README, relu le 26 octobre 2026 ; ce sont les affirmations du projet, pas des mesures du blog.
Caveman réduire tokens : ce que fait le projet
- Auteur et licence : le dépôt est celui de Julius Brussee. Le README indique Apache-2.0 pour tout le dépôt, et le fichier LICENSE est bien le texte de la licence Apache 2.0. Un fichier LICENSING.md traite des anciennes versions. Le nom « Caveman » et le logo sont des marques de l’auteur.
- Chiffres relus le 26 octobre 2026 : environ 115 000 étoiles, environ 6 600 forks, 1 886 commits. La page n’affiche pas de release dans son encadré, mais le README renvoie aux notes de la version 4.0.0 et épingle la v4.0.1 dans ses scripts d’installation.
- Six briques (« rocks » dans le README) : Say less (réponses courtes), Read less (compression des journaux, JSON, CSV et sorties de test avant lecture par le modèle), Auto (choix du modèle et du niveau d’effort), Blocks (scripts réutilisables), Waste fixes (repérage du gaspillage) et Browse (pages web compressées).
Le principe de la voix : réponse d’abord, une idée par phrase, mais le code, les commandes, les chemins et les messages d’erreur restent intacts. Le README insiste sur un point : le projet ne réécrit jamais vos prompts, car il cite une étude (Adobe Research) selon laquelle le faire dégrade les réponses.
Visite du rapport Caveman Learn
La commande caveman learn classe, selon le README, les endroits où partent vos tokens à partir de l’historique des agents déjà présent sur le disque. Le dépôt publie une capture du rapport généré.
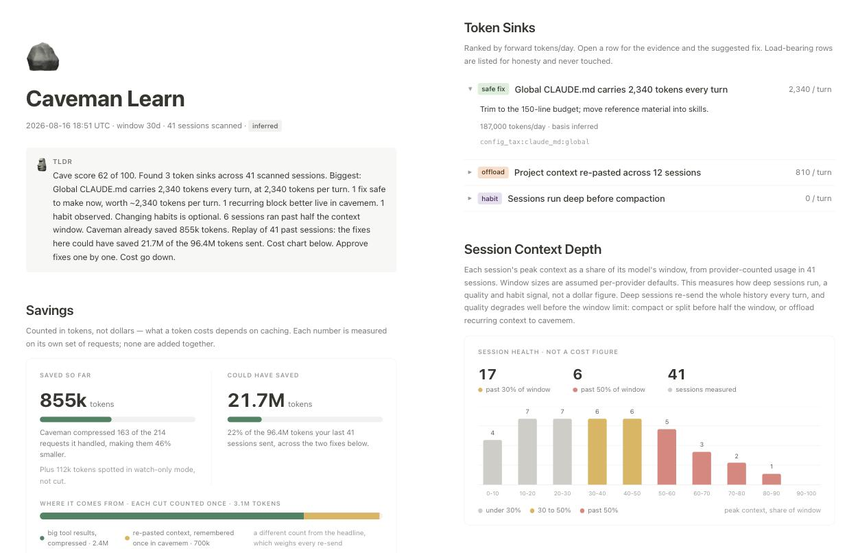
La capture vient du README du dépôt (licence Apache-2.0). Elle montre un résumé, des cartes « Saved so far » et « Could have saved », une liste de postes de gaspillage (par exemple un fichier CLAUDE.md global qui ajoute des tokens à chaque tour) et un histogramme de la part de la fenêtre de contexte utilisée par session. Le rapport précise que les chiffres sont comptés en tokens, pas en dollars, car le prix d’un token dépend du cache. Ces valeurs sont celles d’une session de démonstration : les vôtres seront différentes.
Installation pas à pas, d’après le README
- Prérequis : Node.js 22.13 ou plus récent. Le README annonce Mac, Linux et Windows.
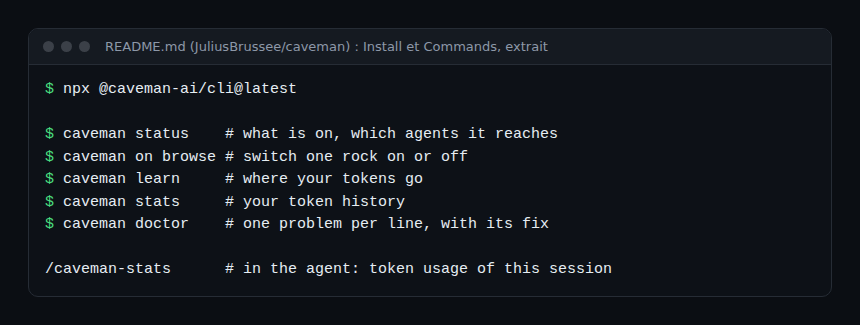
- Installer avec une seule commande, qui détecte vos agents et montre ce qu’elle change avant d’appliquer :
npx @caveman-ai/cli@latest - Vérifier l’état avec
caveman statusetcaveman doctor. Si vous aviez Caveman avant la version 4.0, le README demande d’écrire@latest, sinon l’ancienne copie locale gagne. - Variante « skill seule », sans le proxy :
npx skills add JuliusBrussee/caveman -gpuis
/cavemandans l’agent ($cavemandans Codex) ;stop cavemanrevient au mode normal. - Variante plugin Claude Code :
claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman
Pour désinstaller, le README donne npx -y github:JuliusBrussee/caveman -- --uninstall (avec --allow-git=root en plus sur npm 12 ou plus récent). Pour Windows, il fournit un script PowerShell 5.1 ou plus. Relisez ces scripts avant de les exécuter : un curl ... | bash exécute du code distant.
Quelles mesures suivre pour superviser les tokens
Caveman fournit caveman stats (historique des tokens) et /caveman-stats (usage réel d’une session Claude Code). Ce sont des vues locales. Pour une équipe, il faut aussi une mesure indépendante, côté observabilité LLM. Les conventions sémantiques OpenTelemetry pour l’IA générative définissent pour cela les attributs gen_ai.usage.input_tokens et gen_ai.usage.output_tokens sur les spans, et la métrique gen_ai.client.token.usage. Ces conventions ont le statut Development et vivent désormais dans un dépôt dédié : voir notre article sur le coût d’un agent IA en tokens avec OpenTelemetry pour le détail et les réserves.
Quatre indicateurs suffisent pour commencer :
- Tokens d’entrée par session : ils grossissent à chaque tour, car le contexte s’accumule. C’est la part que « Read less » prétend réduire.
- Tokens de sortie par requête : la part que la voix concise cible.
- Nombre d’appels d’outils par tâche : un agent qui tourne en rond le montre avant la facture.
- Tâches réussies : une économie de tokens qui fait échouer plus de tâches ne vaut rien. Mesurez les deux ensemble.
Méthode SRE : relevez ces indicateurs une semaine avant l’installation, puis une semaine après, sur des tâches comparables. Sans ligne de base, aucune économie n’est démontrable. Si vous placez déjà un proxy de compression devant vos modèles, comparez avec Headroom, la compression de contexte LLM, qui expose ses propres métriques. Pour garder la main sur ce que fait l’agent, voir aussi T3 Code et le pilotage d’agents de code.
Ce que le projet affirme (et ses réserves)
Le README publie beaucoup de chiffres. Voici quelques-uns, à lire avec leurs réserves, qui figurent dans le README lui-même :
- Sur dix questions de développement, le README compte 6 983 tokens de sortie sans consigne, 4 334 avec « Answer concisely. », 4 119 avec
/cavemanet 2 693 avec/ultracave. Il note que « sois concis » est la vraie base de comparaison et que ces mesures datent des règles de la version 3.1.0, non relancées. - Pour « Read less », le README annonce 33,2 % de tokens d’entrée en moins sur des sessions entières (54 exécutions de Claude Code). Il précise que la mesure date d’août 2026 sur un ancien moteur, et que le HTML se dégrade de 9,9 % faute de compresseur.
- Pour « Auto », il annonce 54 % de coût en moins sur 85 tâches, en précisant que l’essai est à moitié terminé et que l’écart de score est trop petit pour conclure.
- Les règles de la voix coûtent environ 1 160 tokens d’entrée, et si vous payez à la requête (GitHub Copilot), des réponses plus courtes n’économisent rien.
Ces chiffres sont ceux de l’auteur, sur ses jeux de tâches. Ne les reprenez pas comme une promesse pour votre équipe : mesurez les vôtres.
Limites et points ouverts
- Télémétrie activée par défaut : d’après la section « Privacy » du README, la CLI envoie des statistiques d’usage (commandes lancées, nombre de tokens, identifiant d’installation aléatoire, système, adresse IP), mais pas vos prompts, votre code ni vos chemins. Pour la couper :
caveman telemetry offouDO_NOT_TRACK=1. Décidez-le avant un déploiement en entreprise. - Auto envoie des données : une fois connecté, le mode Auto transmet à Caveman Cloud votre dernière demande et ce que l’agent y joint (CLAUDE.md, fichiers cités). Ne l’activez pas sans validation de sécurité.
caveman off routingl’arrête. - Chiffres internes : l’accroche GitHub du dépôt parle de « 65 % de tokens en moins », alors que le README détaille des résultats très variables (8,5 % de tokens de sortie en moins dans l’essai JetBrains cité, 3 % de plus que « sois concis » pour
/caveman). Prenez le détail, pas l’accroche. span.observer n’a pas relu les études citées (Adobe, JetBrains, Elastic) : ce sont des affirmations du README. - Maturité : le projet date d’avril 2026 et est maintenu, d’après le README, par une seule personne. Blocks est une pré-version (v0.1.0-rc.5), et le README signale que l’usage dans l’application Claude n’est pas encore testé de bout en bout.
- Licences : la page GitHub détecte Apache-2.0 et MIT ; le README dit Apache-2.0 pour tout le dépôt. Lisez LICENSING.md pour les anciennes versions et les notices tierces.
Bonnes pratiques
- Installez d’abord sur un poste de test, lisez la liste de changements affichée par l’installeur.
- Désactivez la télémétrie et laissez Auto éteint tant que la politique de données n’est pas validée.
- Mesurez tokens et taux de réussite avant et après, avec les mêmes tâches.
- Gardez les alertes de coût de votre fournisseur, indépendantes de l’outil.
- Laissez le code, les commandes et les erreurs en texte complet : relisez toujours un diff avant de l’accepter.
Questions fréquentes
Caveman fait-il vraiment économiser des tokens ?
Le README publie des mesures, mais elles viennent de l’auteur, sur ses jeux de tâches, avec des réserves écrites. Comptez vos propres tokens avant et après.
Caveman est-il gratuit et libre ?
Le README indique Apache-2.0 pour tout le dépôt. Le mode Auto demande un compte gratuit et un plan Free existe ; ses conditions dépendent de Caveman Cloud, pas de la licence du dépôt.
Que faut-il superviser en production ?
Les tokens d’entrée et de sortie par session, le nombre d’appels d’outils, le taux de réussite des tâches et les connexions sortantes de l’outil. Les conventions OpenTelemetry GenAI donnent les noms de métriques.
Conclusion
Caveman est un projet populaire et très documenté, mais ses chiffres restent ceux de son auteur. Pour une équipe SRE, la bonne démarche est la même que pour toute nouvelle dépendance : lire, installer à petite échelle, couper la télémétrie, et mesurer les tokens avant de croire aux économies. Sources : dépôt JuliusBrussee/caveman et conventions sémantiques OpenTelemetry GenAI.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à l’auteur de Caveman ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.