Para la monitorización Elasticsearch Dynatrace, la vía documentada es la extensión Elasticsearch: consulta la API REST del clúster y envía métricas a Dynatrace, sin instalar ningún agente en el propio clúster. Este tutorial detalla los requisitos, la activación, las trampas y el coste, tal como los describe la documentación de Dynatrace (página actualizada el 15 de junio de 2026, consultada el 30 de octubre de 2026).
El problema es clásico para un equipo SRE: un clúster Elasticsearch pasa de «green» a «yellow» o satura su heap, y la alerta llega demasiado tarde, o no llega. El objetivo aquí: obtener en Dynatrace la salud del clúster, de los nodos, de los índices y de los discos, con alertas básicas, reduciendo el riesgo de duplicados y de sorpresas en la facturación.
El contenido se apoya en la documentación de la extensión, publicada en la sección SaaS de docs.dynatrace.com. No hemos verificado su disponibilidad para Dynatrace Managed: compruébala en tu clúster antes de planificar.
Qué hace la extensión para la monitorización Elasticsearch Dynatrace
Según la documentación de Dynatrace, las extensiones son paquetes modulares que describen cómo recopilar y estructurar métricas, eventos y logs desde fuentes externas. Se ejecutan mediante el Extension Execution Controller (EEC), en un ActiveGate (recopilación remota) o en un host con OneAgent (recopilación local).
Para Elasticsearch, la página de la extensión enumera cinco endpoints consultados: /_cluster/health, /_all/_stats?level=shards, /_nodes/stats, /_alias y /_cat/shards. Las métricas se agrupan en feature sets que se activan a la carta: salud del clúster, CPU, memoria y sistema de archivos de los nodos, JVM y descriptores de archivo, red, cachés, circuit breakers y thread pools, operaciones, índices, rendimiento de disco. Cada feature set existe en variante básica y avanzada, salvo algunas excepciones.
Requisitos: versiones, red y roles
Según la documentación, la extensión requiere Elasticsearch 8.0 o superior. Se menciona OpenSearch 2.12.0, con la reserva de que la compatibilidad completa no está garantizada: trátalo como una prueba, no como un soporte. El clúster debe ser accesible desde el ActiveGate que ejecuta la extensión; un host instrumentado con OneAgent también puede ejecutarla usando la dirección localhost.
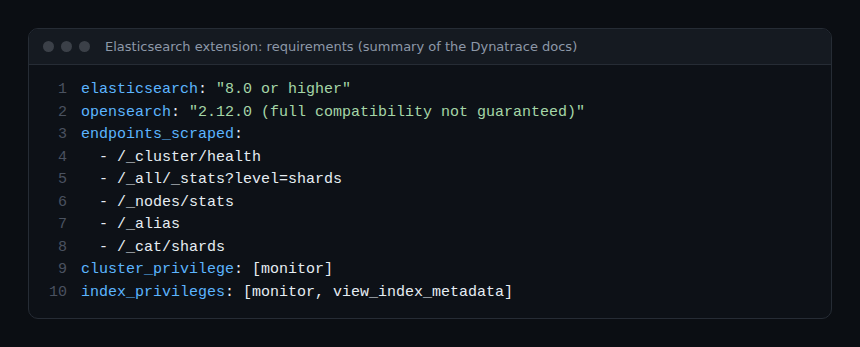
En cuanto a permisos, el usuario de monitorización necesita el privilegio de clúster monitor y los privilegios de índice monitor y view_index_metadata. La documentación de privilegios de Elastic precisa su alcance: monitor a nivel de clúster cubre las operaciones de solo lectura como la salud y el estado del clúster, las estadísticas de nodos y de clúster y las tareas pendientes. A nivel de índice, monitor cubre las acciones de monitorización (recovery, segments, estadísticas de índice), y view_index_metadata da acceso de solo lectura a los metadatos de índice, incluidos los alias. Ninguno de estos privilegios permite modificar datos: es el principio de mínimo privilegio aplicado a la monitorización.
Crea, por tanto, un rol dedicado y un usuario de servicio, en lugar de reutilizar una cuenta de administrador. La sintaxis exacta para crear el rol depende de tu despliegue (autoalojado, Elastic Cloud, ECK): sigue la página de Elastic correspondiente, no la reproducimos aquí porque no la hemos verificado para todos los casos.
Activar la extensión paso a paso
El recorrido documentado por Dynatrace consta de tres pasos.
- En Dynatrace, descarga la extensión Elasticsearch y elige Add monitoring configuration junto a una versión de la extensión, en Versions.
- Selecciona el host que ejecutará la recopilación e introduce la URL de la instancia de Elasticsearch y las credenciales del usuario de monitorización.
- Elige los feature sets cuyas métricas quieres importar.
La página no detalla los campos de configuración de la extensión 2.0 ni los ajustes propios del ActiveGate o del EEC más allá del requisito de accesibilidad. No los inventamos: lee los campos que muestra el asistente de tu entorno.
Un solo host por clúster
Es la trampa principal. Si activas la extensión en varios hosts del mismo clúster, recibes datos de clúster duplicados. La documentación pide activarla en un solo host por clúster, en particular cuando se ejecuta en local mediante OneAgent. En concreto, elige un único ActiveGate por clúster y documenta esa decisión en tu runbook, para que un compañero no añada una segunda configuración «por si acaso».
Cómo comprobar que funciona
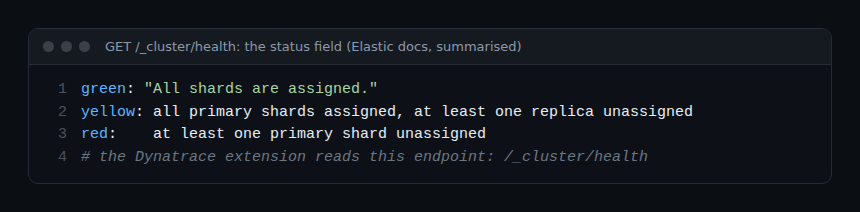
Empieza por verificar la fuente de verdad: consulta tú mismo /_cluster/health con la cuenta de monitorización. Según la documentación de Elastic, el campo status vale green cuando todos los shards están asignados, yellow cuando todos los primarios están asignados pero no todas las réplicas, y red cuando al menos un primario no lo está.
Después, abre en Dynatrace el dashboard de vista general que se entrega con la extensión y las páginas de análisis unificadas. La documentación indica páginas para cada tipo de entidad (clústeres, nodos, índices, discos, thread pools), así como la topología y las relaciones entre estas entidades. Si el clúster no aparece, comprueba por orden: la URL, las credenciales, la accesibilidad desde el ActiveGate y, por último, los privilegios del usuario.
Para contrastar un valor, compara el número de nodos o el estado de salud que muestra Dynatrace con la respuesta de la API: los campos number_of_nodes, unassigned_shards y number_of_pending_tasks de la respuesta corresponden a las métricas de salud del clúster descritas por la extensión (salud, número de nodos, shards sin asignar, tareas pendientes).
Alertas integradas y SLO
La página enumera cinco alertas integradas: CPU total por encima del 85 %, uso del sistema de archivos por encima del 80 %, descriptores de archivo abiertos por encima del 80 % del máximo, heap usado por encima del 85 % y threads rechazados por encima de 300. Son umbrales por defecto, no SLO. Para un SLO, parte de lo que perciben tus usuarios: latencia de búsqueda, tasa de errores de la aplicación que consulta Elasticsearch. Las métricas del clúster sirven después para explicar un presupuesto de error consumido y, por tanto, para reducir el MTTR. Nuestro artículo sobre la diferencia entre observabilidad y monitorización explica por qué ambas capas se complementan.
Coste: puntos de datos y licencia
La extensión es gratuita; solo se pagan los puntos de datos de métricas ingeridos. Con todos los feature sets activados, la documentación da la siguiente fórmula, en puntos por minuto: 12 × clústeres + 53 × nodos + 47 × índices + 5 × discos + 5 × thread pools. Los logs y eventos personalizados que genera la extensión se facturan aparte.
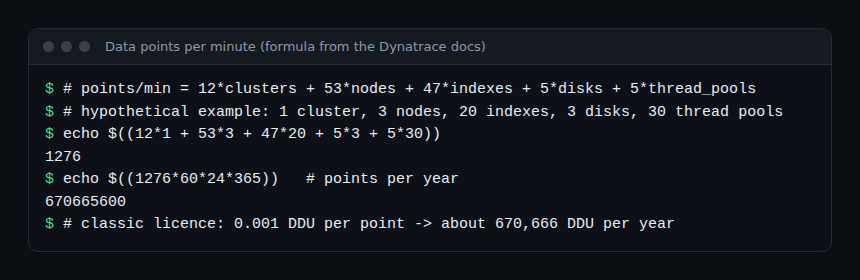
Nuestro ejemplo ficticio (1 clúster, 3 nodos, 20 índices, 3 discos, 30 thread pools) da 1276 puntos por minuto, es decir, 670 665 600 al año. Con una licencia clásica, la documentación indica 0,001 DDU por punto, es decir, unos 670 666 DDU al año; con una Dynatrace Platform Subscription, el consumo corresponde a Metrics powered by Grail. Estas cifras son un cálculo a partir de la fórmula del fabricante, no una medición. El mayor gasto es el número de índices (47 puntos cada uno): si tienes muchos índices, activa solo los feature sets útiles, ya que la documentación precisa que se pueden seleccionar.
Buenas prácticas
- Un rol dedicado de solo lectura, nunca una cuenta de administrador.
- Una sola configuración por clúster, anotada en el runbook.
- Empezar por los feature sets básicos y añadir los avanzados si un incidente lo justifica.
- Estimar el coste con la fórmula antes de generalizar a todos los clústeres.
- Tratar OpenSearch como una prueba: la compatibilidad completa no está garantizada.
¿Y OpenTelemetry?
La extensión cubre las métricas de infraestructura de Elasticsearch. No sustituye la traza de las aplicaciones que lo llaman. Para estas, la instrumentación con OpenTelemetry sigue siendo la vía estándar, enviada a Dynatrace mediante un Collector (consulta nuestra guía del Collector de OpenTelemetry en Kubernetes). Si comparas con otras herramientas, nuestra comparativa entre Dynatrace y Datadog da el marco. No afirmamos ninguna integración de OpenTelemetry propia de esta extensión: la documentación leída no la menciona.
Preguntas frecuentes
¿Qué versiones de Elasticsearch son compatibles?
La documentación indica Elasticsearch 8.0 o superior. Se cita OpenSearch 2.12.0, sin garantía de compatibilidad completa.
¿Por qué mis métricas de clúster aparecen duplicadas?
Probablemente has activado la extensión en varios hosts del mismo clúster. La documentación recomienda un solo host por clúster.
¿La extensión es gratuita?
Es gratuita, pero los puntos de datos de métricas ingeridos se facturan (0,001 DDU por punto en licencia clásica, según la documentación de Dynatrace consultada el 30 de octubre de 2026). Comprueba tu contrato antes de desplegar.
Conclusión
Monitorizar Elasticsearch con Dynatrace depende de tres decisiones: un usuario de solo lectura, un solo host por clúster y feature sets elegidos según el presupuesto de puntos. El resto se comprueba con la API de salud y las páginas de análisis.
Fuentes
- Elasticsearch extension, documentación de Dynatrace
- Extensions, documentación de Dynatrace
- Cluster health API, documentación de Elastic
- Security privileges, documentación de Elastic
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Los nombres de producto citados pertenecen a sus respectivos propietarios; los ejemplos con cifras son ficticios. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.