El tail-based sampling de APM Server decide si conserva o no una traza después de haberla visto entera, lo que permite guardar todos los errores y reducir el resto. Según la documentación de Elastic, la decisión se toma al final de la traza, y no al principio como en el head-based sampling.
Esta guía se centra en los ajustes que duelen cuando se ignoran: interval, ttl, storage_limit y el comportamiento cuando el disco se satura. Complementa nuestro artículo sobre el tail sampling de OpenTelemetry antes de Dynatrace, que trata el enfoque con Collector. Aquí todo ocurre dentro de APM Server, en el lado de Elastic.
Todos los valores siguientes proceden de las páginas de configuración y de presentación del tail-based sampling de la documentación de Elastic (versión «current» consultada el 30 de octubre de 2026), salvo indicación contraria.
En resumen
- El tail-based sampling de APM Server solo funciona con una salida Elasticsearch y exige privilegios reforzados.
- Los eventos esperan su decisión en el disco local, no en memoria: el almacenamiento y el TTL son los dos ajustes críticos.
- Por defecto,
ttlvale30m,interval1mystorage_limit0GB(hasta el 80 % del disco). - Saturación: por defecto, los eventos se indexan sin muestreo, lo que puede sobrecargar Elasticsearch.
Tail-based sampling de APM Server: principio y requisitos
Con el head-based sampling, cada transacción se sortea desde su inicio, sin saber si fallará. Con el tail-based sampling, APM Server conserva los eventos de una traza mientras espera el final de la transacción raíz y después aplica políticas. La documentación precisa que el muestreo es aleatorio ponderado: las trazas cuya transacción raíz dura más tienen más probabilidades de conservarse. Las métricas se calculan sobre todos los eventos, muestreados o no, y los errores se conservan sea cual sea la decisión.
Requisitos citados por la documentación: una salida Elasticsearch (las demás salidas no son compatibles), privilegios reforzados concedidos mediante un rol dedicado, y disponibilidad en la Elastic Stack (no en Elastic Cloud Serverless). Afecta a los agentes de Elastic APM y a los SDK de OpenTelemetry; para OpenTelemetry, la documentación recomienda este mecanismo en lugar del tailsamplingprocessor por las limitaciones de este último.
Escribir las políticas de muestreo
Una política debe tener un sample_rate entre 0 y 1. Las condiciones opcionales son trace.name (nombre de la transacción raíz), trace.outcome (success, failure o unknown), service.name y service.environment. Las políticas se evalúan en orden, todas las condiciones de una política deben cumplirse, y la lista debe terminar con una política que solo defina sample_rate. Sin ella, una transacción que no coincide con ninguna se rechaza con el error «no matching policy».
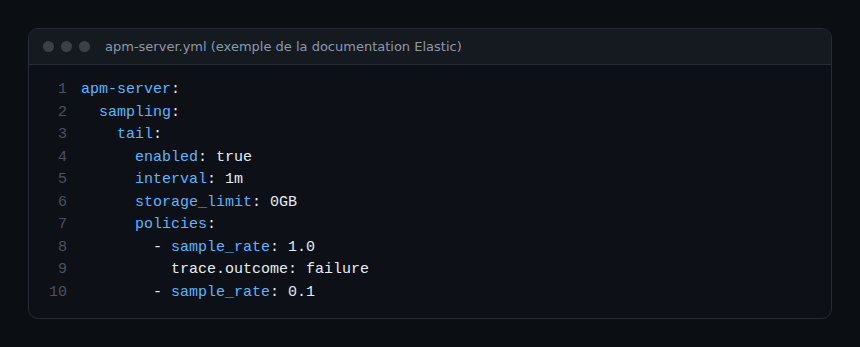
Este ejemplo de la documentación conserva todas las trazas fallidas y el 10 % de las demás. Las reglas se aplican por traza, según el servicio que la inició, y no según un servicio o un span individual.
Ajustar interval, TTL y storage_limit
Paso 1: interval
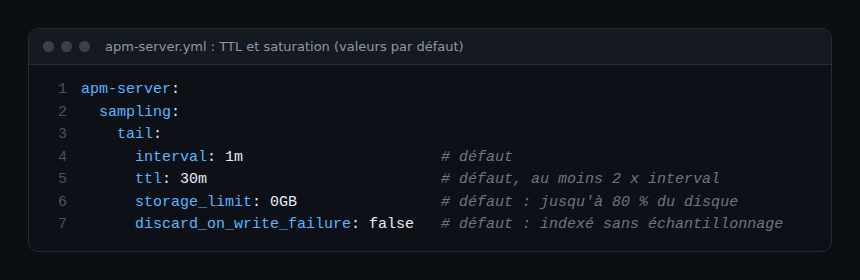
apm-server.sampling.tail.interval (por defecto 1m) es el intervalo de sincronización entre varios APM Server. La documentación recomienda entre unas decenas de segundos y unos minutos. Envía todos los servicios de una traza al mismo clúster de APM Server: si la transacción raíz no llega nunca, los eventos se pierden en silencio.
Paso 2: TTL
apm-server.sampling.tail.ttl (por defecto 30m) fija cuánto tiempo esperan los eventos una decisión en el almacenamiento local. Debe valer al menos el doble del interval. Si el TTL expira antes de la decisión, el evento se elimina sin indexarse. Un TTL más largo exige más disco. En Fleet, el campo TTL aparece a partir de la versión 9.1.
Paso 3: storage_limit
apm-server.sampling.tail.storage_limit (por defecto 0GB): en cero, APM Server puede usar hasta el 80 % del disco que aloja la base de muestreo. Un valor en GB limita el uso. Desde la versión 9.0.0, el límite de almacenamiento es ilimitado por defecto, pero la escritura se detiene al 80 % de ocupación, y el uso real puede superar ligeramente el límite.
Comportamiento en saturación del almacenamiento
Cuando el disco está lleno, APM Server registra «configured limit reached». Después, todo depende de discard_on_write_failure:
false(por defecto): los eventos se saltan el muestreo y se indexan de inmediato entraces-apm-*. La tasa efectiva pasa a ser del 100 %, lo que puede sobrecargar Elasticsearch.true: los eventos se eliminan. La carga de indexación sigue acotada, pero se pierden trazas y pueden aparecer incompletas.
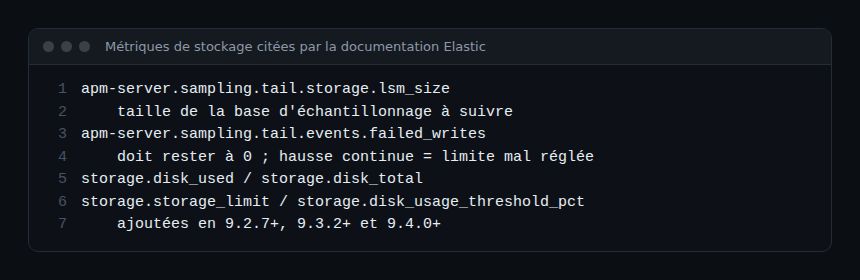
La elección es una decisión de compromiso del equipo de plataforma: proteger Elasticsearch o proteger la integridad de las trazas. Las versiones 9.2.7+, 9.3.2+ y 9.4.0+ añaden un umbral de uso de disco: por encima de él, las nuevas escrituras se rechazan y se aplica este comportamiento. Según la documentación, el disco debe ser rápido (SSD con IOPS altos), porque las escrituras crecen con el caudal de ingesta.
Supervisar y dimensionar
Activa la supervisión de APM Server y sigue lsm_size para la ocupación. El contador failed_writes debe permanecer en 0; un aumento continuo indica un límite mal ajustado. Ten en cuenta también el error «too many open files»: comprueba LimitNOFILE en systemd o ulimit -n. Para entender por qué conservar las trazas raras pese al volumen, consulta observabilidad y monitorización.
Qué cambia para un equipo SRE
El tail-based sampling traslada el coste de la red al disco: dimensionar el almacenamiento pasa a ser una tarea de operación. Los enfoques difieren según la herramienta: en el Collector de OpenTelemetry, el tailsamplingprocessor mantiene los spans en memoria (decision_wait de 30 s y num_traces de 50 000 por defecto según su README) y exige que todos los spans de una traza lleguen a la misma instancia; consulta nuestra guía del Collector en Kubernetes. Para una visión general de los proveedores, lee la comparativa de Dynatrace y Datadog. No afirmamos ninguna integración entre APM Server y Dynatrace.
Buenas prácticas
- Termina siempre la lista con una política que solo tenga
sample_rate. - Mantén el TTL en al menos el doble del intervalo y calcula el disco necesario antes de alargarlo.
- Decide de antemano el valor de
discard_on_write_failurey después crea una alerta sobrefailed_writes. - Prueba en un entorno no crítico antes de pasar a producción.
Preguntas frecuentes
¿Cuál es el valor por defecto del TTL en el tail-based sampling?
Según la documentación de Elastic, apm-server.sampling.tail.ttl vale 30m, con un mínimo del doble del intervalo.
¿Qué ocurre cuando el almacenamiento está lleno?
Por defecto, los eventos se indexan sin muestreo, lo que puede sobrecargar Elasticsearch. Con discard_on_write_failure: true, se eliminan.
¿Funciona el tail-based sampling con otra salida distinta de Elasticsearch?
No, la documentación indica que solo es compatible con la salida Elasticsearch.
Fuentes
- Transaction sampling, documentación de Elastic
- Tail-based sampling configuration, documentación de Elastic
- Tail sampling processor, OpenTelemetry
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Los nombres de productos citados pertenecen a sus respectivos propietarios; los valores proceden de la documentación de Elastic: compruébalos siempre en la documentación oficial correspondiente a tu versión.