El Sensitive Data Scanner de Datadog detecta datos personales en tus logs y los enmascara antes de que sean legibles. Para un equipo SRE o de plataforma es una protección concreta: un correo electrónico, un número de tarjeta o un token que se cuela en un mensaje de error no tiene nada que hacer en una herramienta que consulta todo el equipo.
Este tutorial sigue la documentación oficial de Datadog, consultada el 30 de octubre de 2026. Cubre la creación de un grupo de escaneo y de una regla, la elección de la acción (enmascarar, hashear) y los límites de la sintaxis regex. No se recoge ningún precio: consulta la página oficial de Datadog para las condiciones comerciales.
Sensitive Data Scanner de Datadog: qué hace
Según la documentación, el Sensitive Data Scanner (SDS) descubre, clasifica y, si lo eliges, enmascara datos sensibles: PII, credenciales, números de tarjeta. Para la telemetría cubre los logs, los spans de APM, los eventos de RUM y los eventos de Datadog. Los logs pueden escanearse en la nube de Datadog, o en tu propio entorno con Observability Pipelines.
Dos nociones estructuran la herramienta:
- un scanning group define qué datos escanear (una consulta de filtro, los productos, una tasa de muestreo);
- unas scanning rules definen qué buscar en ellos: reglas de la biblioteca (correos, tarjetas bancarias, claves de API, tokens de autorización…) o reglas personalizadas con regex.
Requisitos de permisos, según la página de configuración: el rol Datadog Admin basta por defecto. Si no, un rol personalizado recibe data_scanner_read (lectura) o data_scanner_write (configuración) en la sección Compliance. El permiso Data Scanner Unmask sirve para leer los valores ocultados por la acción Mask.
Paso 1: crear un grupo de escaneo
- Abre la página de ajustes del Sensitive Data Scanner y haz clic en Add scanning group.
- Escribe una consulta de filtro. La vista previa «Logs» o «APM Spans» muestra los datos afectados.
- Pon un nombre y una descripción.
- Activa los productos que quieres escanear: Logs, APM spans, RUM events, Datadog events.
- Opcional: fija una tasa de muestreo del 10 % al 99 % por producto.
- Haz clic en Create y activa el interruptor del grupo: un grupo nuevo empieza desactivado.
Punto de atención: la documentación indica que un grupo con muestreo no puede usar las acciones de enmascaramiento. Para datos sensibles, no actives el muestreo: un escaneo parcial dejaría pasar valores en claro. El enmascaramiento con OpenPipeline en Dynatrace sigue la misma lógica: actuar antes del almacenamiento, sobre todo el flujo.
Paso 2: añadir una regla y elegir la acción
Abre el grupo, haz clic en Add Scanning Rule y elige una regla de la biblioteca o una regla personalizada. En una regla de la biblioteca ajustas la Priority, seleccionas las reglas en «Add Library Rules» y después la Action on Match. En una regla personalizada escribes además una regex en «Match conditions» y la pruebas con una muestra antes de validar.
La opción «Action on Match» también pide el alcance: Entire Event (con posible exclusión de atributos) o Specific Attributes (lista de atributos que escanear). En las rutas de atributos, la documentación pide no escribir el prefijo @.
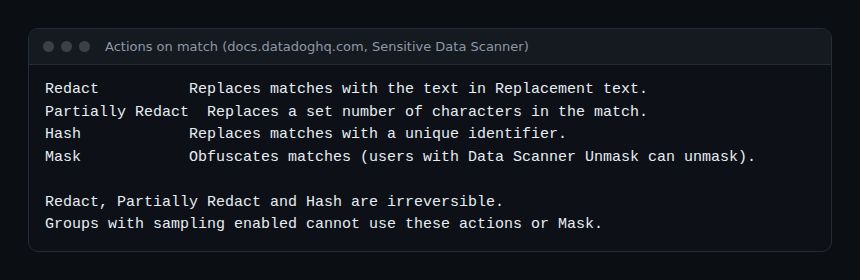
¿Redact, Partially Redact, Hash o Mask?
- Redact sustituye el valor por el texto que elijas. Simple y legible:
[EMAIL]en un log se entiende al instante. - Partially Redact sustituye el número de caracteres que elijas, en la parte del valor que indiques. Útil para dejar visible solo un fragmento.
- Hash sustituye el valor por un identificador único. La sustitución es irreversible: el dato original deja de ser legible.
- Mask oculta el valor, pero los usuarios que tienen
Data Scanner Unmaskpueden revelarlo. La página de presentación indica Mask disponible para logs, APM y RUM, pero no para eventos.
Redact, Partially Redact y Hash son irreversibles, precisa la documentación. Es lo que se quiere para un dato que ya no debe existir en claro. Mask conviene cuando unas pocas personas autorizadas deben poder volver a leer el valor.
Por último, añade tags a los eventos con coincidencia. Datadog recomienda sensitive_data y sensitive_data_category; permiten después buscar y contar las fugas evitadas.
Paso 3: escribir una regla regex con los límites de PCRE
La página de sintaxis indica que la regex del SDS es «un subconjunto de PCRE2». Las familias admitidas son la alternancia, las aserciones, las clases de caracteres, los grupos, los cuantificadores, las banderas y las propiedades Unicode.
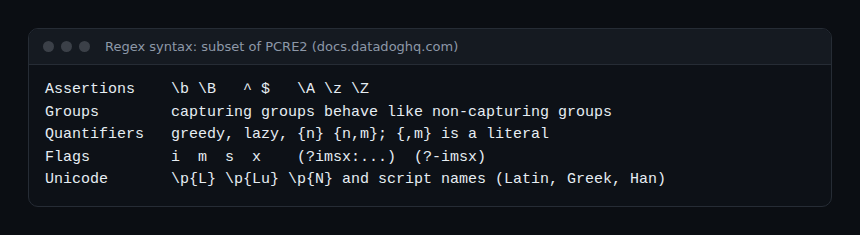
Esto es lo que dice la documentación, y lo que no dice:
- En las aserciones, solo se listan los límites de palabra (
\b,\B) y los anclajes de línea y de texto. El lookaround ((?=,(?<=) no se describe, por tanto, como admitido. - Los grupos de captura se comportan como grupos sin captura y sus nombres se ignoran. Una referencia hacia atrás (backreference) no tiene sentido aquí.
- La forma
{,m}se lee como texto literal, y los espacios dentro de las llaves también convierten el cuantificador en literal.
Lo del lookaround y las referencias hacia atrás no está escrito negro sobre blanco como «no admitido»: la página simplemente no los lista. Considéralos no disponibles y prueba tu regex en el campo de muestra de la interfaz antes de desplegarla. Este punto queda por confirmar con el producto.
Ejemplo de regla personalizada, escrito por span.observer para ilustrar la sintaxis (no tomado de la documentación). Para detectar un identificador de cliente con la forma CLI- seguido de ocho dígitos, sin lookaround:
\bCLI-[0-9]{8}\bAñade después palabras clave cercanas para reducir los falsos positivos. Según la página de configuración, una regla acepta hasta 20 palabras clave, que deben aparecer por defecto en los 30 caracteres anteriores a la coincidencia.
Límites que conviene conocer
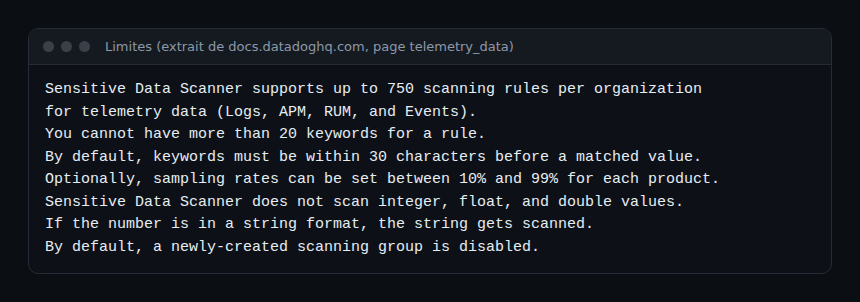
Dos límites suelen sorprender. Primero, los valores enteros, de coma flotante y dobles no se escanean; los números escritos como cadena sí. Un número de tarjeta guardado como entero en un atributo JSON escapa, por tanto, al escaneo, mientras que se detecta si es una cadena. Segundo, en los logs, las notificaciones de alerta contienen el contexto de la detección y un enlace, sin extracto del log.
Cómo comprobar que funciona
- Envía un log de prueba con un valor falso (nunca un dato real) que coincida con tu regla.
- Abre el log en el Log Explorer: el valor debe aparecer sustituido.
- Filtra por el tag
sensitive_datapara contar los eventos afectados.
Relación con OpenTelemetry y Dynatrace
El enmascaramiento en el backend es una última red de seguridad. Si tus logs pasan por un Collector de OpenTelemetry, un procesamiento previo elimina el dato antes del envío: consulta nuestra guía del Collector de OpenTelemetry en Kubernetes y la del Collector de Datadog (DDOT). Para comparar enfoques, la comparativa entre Dynatrace y Datadog sitúa ambas herramientas en un contexto SRE. Aquí no se documenta ninguna integración entre el SDS y Dynatrace.
Buenas prácticas
- Enmascara lo antes posible: primero en el Collector, y el SDS como red de seguridad.
- Sin muestreo en un grupo que protege datos sensibles.
- Prueba cada regex con una muestra y evita lo que la sintaxis no lista.
- Reserva Mask para necesidades de investigación y usa Redact o Hash para el resto.
- Sigue el tag
sensitive_dataen un dashboard: una subida señala un defecto de código que corregir.
Preguntas frecuentes
¿El Sensitive Data Scanner de Datadog admite lookaround?
La documentación describe la sintaxis como un subconjunto de PCRE2 y solo lista los límites de palabra y los anclajes como aserciones. El lookaround no figura: no verificado como admitido, prueba antes de usarlo.
¿Qué diferencia hay entre Redact y Hash?
Redact sustituye el valor por el texto que elijas. Hash lo sustituye por un identificador único. Ambos son irreversibles, según la documentación.
¿Se puede escanear algo más que logs?
Sí: spans de APM, eventos de RUM y eventos de Datadog. La documentación menciona también trazas de observabilidad de agentes de IA, buckets de S3 (solo detección, sin enmascaramiento) y repositorios de código.
Conclusión
Un grupo de escaneo sin muestreo, una regla de la biblioteca, una acción irreversible y un tag de seguimiento: esta base ya cubre la mayoría de las fugas habituales en los logs. Añade después regex personalizadas, manteniéndote en el subconjunto de PCRE2 descrito por Datadog.
Blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Datadog Inc. La información procede de la documentación oficial de Datadog consultada el 30 de octubre de 2026; no se recoge ningún precio. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión. Fuentes: Sensitive Data Scanner, configuración para la telemetría, reglas personalizadas.