Lunes, 9:00: el proceso nocturno terminó a las 7 en lugar de a las 3 y el equipo de finanzas quiere saber por qué sube la factura de Databricks. Si alguna vez has buscado la respuesta a ambas preguntas dentro de la interfaz del workspace, sabes lo lento que resulta. Conectar Databricks Dynatrace resuelve buena parte del problema, siempre que elijas bien la extensión: hay dos y cada una contesta una pregunta distinta.
El recorrido sigue ese escenario de operaciones: decidir qué extensión desplegar, reunir lo necesario con cada equipo y saber qué esperar de los datos. Los hechos salen de las páginas oficiales de Dynatrace y de Databricks, consultadas el 8 de noviembre de 2026. No hemos desplegado la extensión nosotros mismos: lo que sigue es una lectura crítica de la documentación, no la experiencia de un entorno en producción.
Dynatrace también publicó un artículo de presentación, turn Databricks telemetry into actionable decisions. Aquí no hay escaparate: solo el punto de vista de quien trabaja con esto, sobre qué preparar y dónde están las trampas.
Databricks Dynatrace: qué extensión responde a tu pregunta
En vez de comparar funciones, parte de la pregunta que te hacen.
- «¿Se satura el nodo? ¿Qué hace Spark?» Necesitas medidas tomadas en las máquinas. Eso lo da la extensión basada en OneAgent, que se instala en cada clúster mediante un script de inicio global y requiere el Extension Execution Controller activo en el host. Lee las API de Spark y de Databricks, además de Ganglia, que ya no existe desde Databricks Runtime 13.
- «¿Qué job falló, cuánto costó y aguanta ese endpoint de model serving?» Necesitas una vista por recurso. Esa es la extensión Databricks Workspace, que consulta el workspace desde fuera, con sus API y sus tablas del sistema.
- «Trabajamos en serverless.» Ahí no entra ningún agente. La página de la extensión Workspace la presenta precisamente como el complemento para los entornos donde no se puede instalar OneAgent.
Nada impide combinar ambas: la documentación las describe como complementarias. En lo que sigue nos centramos en Workspace, más ligera de instalar y más cercana a las preguntas de finanzas.
¿SaaS o Managed? Las dos páginas consultadas pertenecen a la documentación de SaaS. No mencionan Dynatrace Managed y no hemos comprobado estas extensiones en Managed, así que no des nada por hecho y lee la documentación de tu versión. Sobre el papel del ActiveGate, consulta ActiveGate de entorno o de clúster.
Qué pedir a cada equipo
El despliegue rara vez se atasca en Dynatrace: lo difícil es conseguir los permisos. Esta es la lista de la compra, ordenada por interlocutor.
Al equipo de redes: un Environment ActiveGate que llegue a la URL del workspace. Hay un detalle que sorprende: también lee los resultados de las consultas SQL a través de URL prefirmadas del almacenamiento en la nube, de modo que la salida hacia esos dominios debe estar abierta. La página pone como ejemplo *.s3.*amazonaws.com y *.blob.core.windows.net. Sin eso, la conexión al workspace funciona pero las tablas del sistema no devuelven nada. No se describe ninguna vía sin ActiveGate.
Al administrador de Databricks:
- Unity Catalog activado; sin él no hay tablas del sistema.
- Un SQL warehouse en marcha para la facturación y el model serving; basta el identificador de uno existente.
- Una identidad propia, mejor un service principal que un token personal. La página exige que sea administrador del workspace o que tenga Can view sobre los jobs y endpoints que se vayan a seguir; para las métricas de Spark, añade Can attach to en cada clúster.
- Los permisos sobre las tablas del sistema.
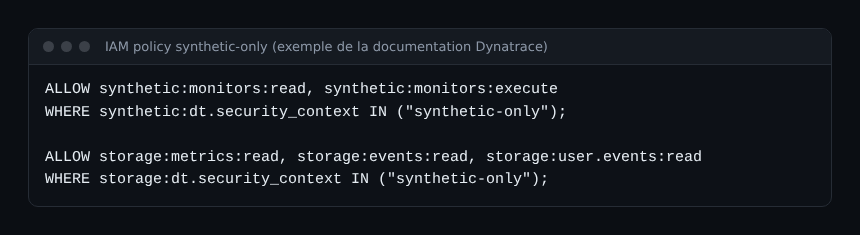
Sobre este último punto, la documentación de Databricks aclara que esas tablas son de solo lectura y no cuesta consultarlas: solo se factura el cómputo de la consulta. El acceso pasa por USE CATALOG, después USE SCHEMA y SELECT. La página de Dynatrace da sus propios GRANT, esquema por esquema. Nuestro ejemplo, con un principal ficticio, cubre solo facturación y auditoría: copia la lista completa desde la fuente.
A ti, en el lado de Dynatrace: un token de acceso con el único scope openTelemetryTrace.ingest, guardado en un gestor de secretos y nunca en un repositorio.
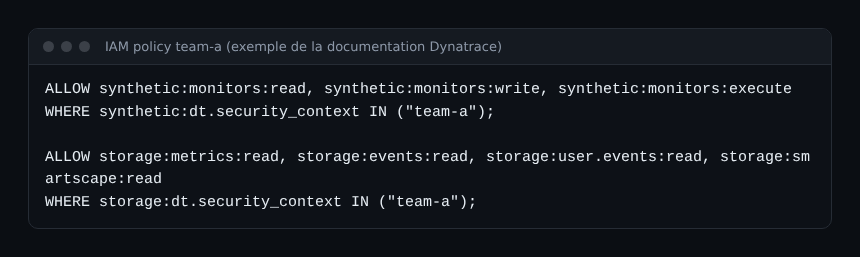
Para saber con exactitud qué API y qué tablas debe poder leer el service principal, la siguiente captura recoge los scopes de API (jobs, clusters, model-serving, sql, instance-pools, pipelines) y las nueve tablas del sistema que enumera la documentación.
Activar la monitorización, en este orden
Con los permisos en la mano, la configuración son pocos pasos. En Dynatrace creas una configuración de monitorización con la URL del workspace, el token de Dynatrace y, o bien el token de Databricks, o bien el client ID y el secreto del service principal. No citamos nombres de campos porque la página no los enumera, tampoco el del identificador del warehouse.
Queda elegir los feature sets: Job Metrics, Resource Utilization, Model Serving Endpoint, Job Cost, Spark Executor, entre otros. Mi consejo: no marques todo el primer día. Empieza por Job Metrics, que responde a la pregunta del lunes a las 9:00, y añade los costes cuando los primeros datos sean fiables. Cada feature set aumenta el volumen ingerido y la carga sobre el warehouse. Hay que recoger al menos una métrica tras la activación; si no, la configuración no te dirá nada útil.
Comprobar que llegan los datos
La documentación no incluye ninguna consulta DQL. Las dos líneas siguientes son nuestras, construidas con la sintaxis timeseries y las claves de métricas de la página. No las hemos ejecutado y no usamos ninguna dimensión, como el nombre del job, porque no hay ninguna documentada.
timeseries avg(databricks.job.duration.run), from:-24h

timeseries avg(databricks.job.success_rate), from:-24h
La primera dibuja la duración media de ejecución; la segunda, la tasa de éxito. La página no indica la unidad: compruébala antes de fijar un umbral. Si quieres ir más allá del copiar y pegar, los comandos DQL filter, summarize y timeseries explican cómo trocear estas series.
En la interfaz, la documentación señala tres puntos de referencia: el dashboard Job Runs (con enlace a las trazas), el dashboard Databricks Cost Management y unos servicios llamados Databricks - <nombre del workspace>, donde cada job es un endpoint y cada ejecución una traza distribuida.
Retrasos y costes: por qué hay huecos en los gráficos
Antes de dar la voz de alarma, repasa estos comportamientos.
- Un job envía sus métricas y trazas solo cuando termina, así que uno en curso es invisible.
- La facturación llega con unas 8 horas de retraso; el uso del model serving, la utilización de clústeres y los logs de auditoría, con cerca de 1 hora. Amplía la ventana antes de concluir que se han perdido datos.
databricks.job.costsolo funciona en Azure Databricks.- Cada lectura de una tabla del sistema consume cómputo del warehouse, que cobra Databricks, no Dynatrace.
- Del lado de Dynatrace, la página da fórmulas de volumen, por ejemplo
8 * número de jobspuntos de datos para las métricas de jobs ynúmero de jobs * (1 + tareas por job)spans para las trazas. Haz la cuenta para tu parque antes de activar demasiado.
Buenas prácticas
- Un service principal exclusivo, con permisos estrictamente enumerados.
- Un warehouse dimensionado para consultas regulares y modestas, no para analítica pesada.
- Un primer feature set y, después, ampliaciones de una en una vigilando la factura en ambos lados.
- Una tasa de éxito de los jobs ligada a un objetivo, como en las métricas DQL y las alertas.
Preguntas frecuentes
¿Hace falta OneAgent para monitorizar Databricks con Dynatrace?
No para la extensión Workspace, que no instala nada en los clústeres. La extensión de clúster, en cambio, despliega OneAgent mediante un script de inicio global.
¿Funciona la extensión Workspace sin ActiveGate?
La documentación exige un Environment ActiveGate y no describe ningún otro camino.
¿Qué datos llegan a Dynatrace?
Métricas y trazas de jobs, costes, model serving, facturación, métricas de Spark y recomendaciones de dimensionamiento de clústeres, además de logs de auditoría y de actividad de los clústeres.
Conclusión
Para contestar a la pregunta del lunes a las 9:00 sin instalar agentes, la extensión Workspace basta: jobs, costes y endpoints, a cambio de un ActiveGate, un warehouse y permisos bien acotados. Reserva la extensión de clúster para las preguntas a nivel de nodo. Empieza con un solo feature set, observa los retrasos y amplía después.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC (ni a Databricks). Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian rápido: comprueba siempre las opciones en la documentación oficial correspondiente a tu versión, en particular la página de la extensión Databricks Workspace.