El Elasticsearch frozen tier es la capa de almacenamiento que mantiene consultables los datos antiguos a menor coste, dejándolos en un repositorio de snapshots en lugar de en discos locales. La promesa atrae a cualquier equipo SRE que conserva logs durante meses. Sin embargo, la pregunta útil es precisa: ¿qué se paga realmente y qué latencia hay que aceptar?
Este artículo se apoya en la documentación oficial de Elastic (páginas consultadas el 30 de octubre de 2026) y en un benchmark publicado por Elastic en enero de 2025. Las cifras del proveedor se atribuyen como tales: span.observer no ha medido nada. La función vale para Elasticsearch, no para Dynatrace Managed ni Dynatrace SaaS, que tienen su propio almacenamiento.
En resumen
- El frozen tier solo contiene índices montados parcialmente (prefijo
partial-), respaldados por un snapshot. - Los snapshots buscables exigen una licencia Enterprise, según la documentación.
- El ahorro está en los discos y los nodos. Se paga con latencia en las consultas que no encuentran el dato en la caché.
- El repositorio de snapshots pasa a ser la única copia de los datos: hay que protegerlo.
Elasticsearch frozen tier: qué es
Según la página de data tiers, los nodos frozen alojan datos temporales que se leen poco y nunca se modifican. Suelen llegar del tier cold y permanecen allí hasta su eliminación. Elastic recomienda nodos dedicados, con el rol data_frozen.
La página sobre snapshots buscables distingue dos modos:
- Montado completo (
restored-): los shards se guardan en caché dentro del clúster. La documentación habla de un rendimiento normalmente comparable al de un índice clásico. ILM lo usa en la fase hot o cold. - Montado parcial (
partial-): una caché local de tamaño fijo conserva solo los datos buscados recientemente. Si falla la caché, el nodo lee el repositorio, por lo que la búsqueda es más lenta. ILM lo usa en la fase frozen.
Lo que realmente se paga
El coste se reparte en cuatro partidas. Las dos primeras bajan; las otras dos es fácil olvidarlas.
Lo que disminuye
- Los discos y los nodos. Según Elastic, un tier cold totalmente montado, sin réplica, requiere la mitad de los nodos y del disco de un tier con índices clásicos. El frozen exige aún menos. La página de data tiers llega a hablar de hasta 20 veces la capacidad del tier warm, según Elastic.
- Las copias entre nodos. Los montajes y los movimientos de shards copian desde el repositorio, algo que la documentación considera por lo general mucho más barato que una copia de nodo a nodo.
Lo que permanece o aparece
- El almacenamiento de objetos. El repositorio (S3, Google Cloud Storage, Azure Blob Storage, HDFS, sistema de archivos compartido) guarda los datos. Su precio depende de tu proveedor: consulta su tarifa oficial, aquí no se recoge ningún precio.
- La salida de red. La documentación advierte de que los cargos de egress de la nube pueden ser importantes. Monta los snapshots en un clúster de la misma región que el repositorio; para una búsqueda entre regiones, aconseja la búsqueda entre clústeres o la replicación.
- La licencia. La función necesita una licencia Enterprise, según la misma página.
El benchmark de Elastic cuantifica la diferencia con un ejemplo. Compara un despliegue todo hot de 90 TB en Elastic Cloud con un despliegue con un día de hot y el resto en frozen. La relación de precio, de unas 16 veces, se obtiene dividiendo los dos importes del artículo (la moneda no se indica). Las tarifas datan de la redacción de Elastic y pueden haber cambiado: repite el cálculo con la tarifa actual. Frente a la opción todo hot densa, la diferencia baja a unas 8,6 veces según esos mismos importes.
La latencia que hay que esperar
El benchmark, publicado en enero de 2025 por Elastic, abarca 105 TB de logs repartidos en más de 90 días. El clúster tiene seis nodos en Google Cloud (tres hot, tres frozen), probados con Rally. Las consultas imitan búsquedas de Kibana Discover sobre logs; otras cargas pueden dar otros resultados. El artículo no indica la versión de Elasticsearch.
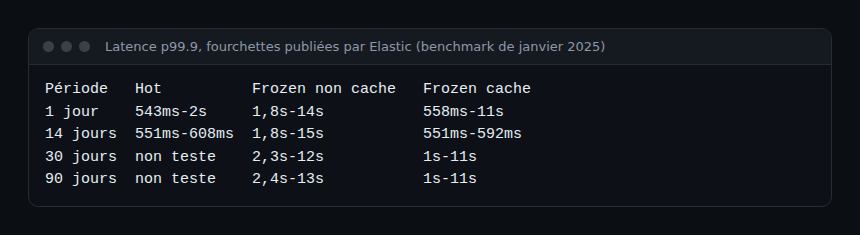
De estas cifras se extraen tres lecturas:
- Una consulta que toca el repositorio cuesta varios segundos, a veces mucho más. Para 90 días, Elastic publica un máximo de 5 minutos sin caché, frente a unos 1,6 minutos con caché.
- Una vez caliente la caché, el frozen se acerca al hot en algunas ventanas, como 14 días.
- La caché se vacía al reiniciar un nodo, según la documentación. Tras un mantenimiento, las primeras búsquedas serán lentas.
Para un SRE, la consecuencia es clara: el frozen sirve para la investigación de incidentes a posteriori o la auditoría, no para un dashboard que se refresca cada diez segundos. Si un SLO de tiempo de respuesta cubre estas búsquedas, mídelo con tus propias consultas.
Configurar una política ILM con una fase frozen
Este es el paso a paso mínimo. Requisitos previos: una licencia Enterprise, nodos data_frozen y un repositorio de snapshots registrado (aquí backing_repo, nombre tomado de la documentación).
- Registra el repositorio de snapshots, almacenamiento de objetos o sistema de archivos compartido.
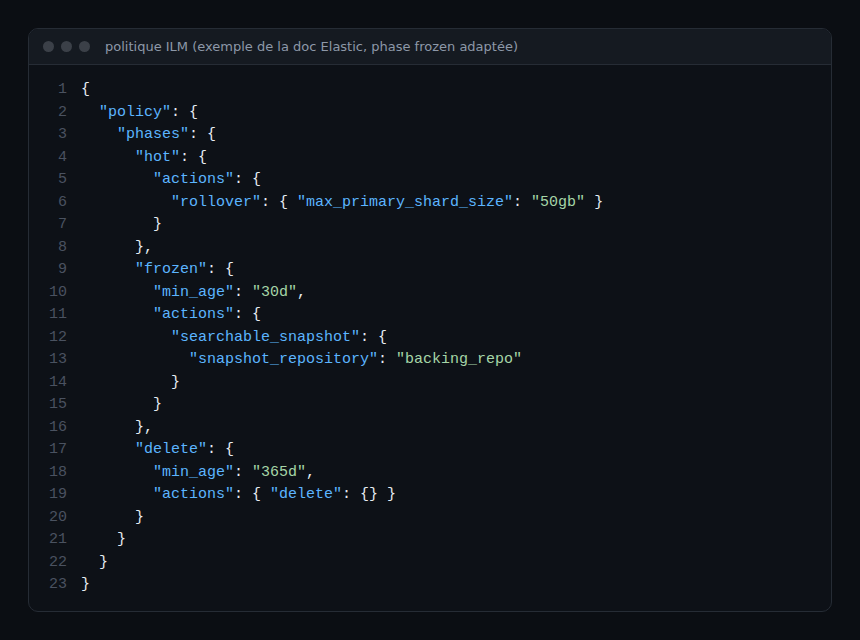
- Crea la política ILM. La acción
searchable_snapshotse permite en las fases hot, cold y frozen. En frozen, monta un índicepartial-. Elmin_agede 30 días y la eliminación a los 365 días de abajo son valores de ejemplo que debes adaptar.
PUT _ilm/policy/logs-frozen
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": { "max_primary_shard_size": "50gb" }
        }
      },
      "frozen": {
        "min_age": "30d",
        "actions": {
          "searchable_snapshot": {
            "snapshot_repository": "backing_repo"
          }
        }
      },
      "delete": {
        "min_age": "365d",
        "actions": { "delete": {} }
      }
    }
  }
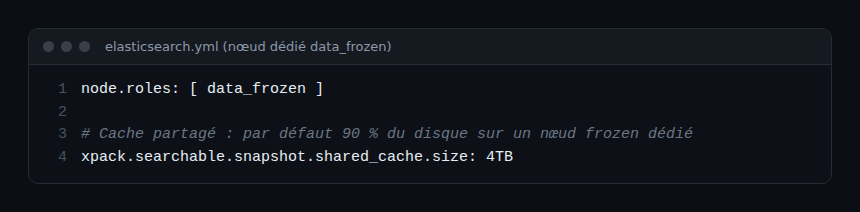
}- Dimensiona la caché. En un nodo frozen dedicado,
xpack.searchable.snapshot.shared_cache.sizevale por defecto el 90 % del disco; si no,0b. Según la doc, un disco de 4000 GB da una caché de 3900 GB y un disco de 400 GB una caché de 360 GB. El parámetromax_headroomvale 100 GB si no se fija el tamaño.
Puntos de atención de la doc
- Por defecto,
force_merge_indexvaletrue: el índice se fusiona en un segmento antes del snapshot, lo que reduce las lecturas en el repositorio. - La acción no se ejecuta sobre el índice de escritura de un data stream: prevé un
rollover. - La acción
deletetambién elimina el snapshot por defecto;delete_searchable_snapshot: falselo conserva.
Cómo comprobar que funciona
Tras el paso de un índice, lista los índices: el nombre debe empezar por partial- y el índice debe estar en un nodo frozen. Después lanza la misma consulta dos veces y compara las duraciones: la primera llena la caché, la segunda debe ser más rápida. Vigila también la salud del clúster: sin réplica, la pérdida de un nodo puede dar resultados parciales mientras dura la reasignación.
Buenas prácticas
- No elimines nunca el snapshot ni el repositorio mientras haya índices montados en él: es la única copia.
- Mantén el repositorio y el clúster en la misma región.
- Desactiva la asignación antes de un reinicio planificado para evitar una nueva descarga completa.
- Reserva el frozen para los datos que se buscan raramente.
Y en cuanto a OpenTelemetry y Dynatrace
El frozen tier resuelve un problema de retención, no de recopilación. Si tus logs llegan por un colector, consulta nuestra guía del Collector de OpenTelemetry en Kubernetes y la distinción entre OpenTelemetry y Prometheus. Para situar la elección de herramienta, lee la comparativa Dynatrace y Datadog. Aquí no se documenta ninguna integración entre el frozen tier y Dynatrace.
Preguntas frecuentes
¿Está disponible el frozen tier sin licencia Enterprise?
Según la documentación de Elastic consultada, los snapshots buscables requieren una licencia Enterprise. Comprueba tu suscripción antes de diseñar una arquitectura sobre ellos.
¿Qué diferencia hay entre cold y frozen?
El cold puede usar índices totalmente montados, con copia local y sin réplica. El frozen usa únicamente índices montados parcialmente, con una caché local limitada: menos disco, más latencia.
¿Está garantizada la cifra «16 veces más barato»?
No. Es un ejemplo cuantificado por Elastic, con tarifas de Elastic Cloud de la época y una carga concreta. Repite el cálculo con tu proveedor de almacenamiento y tu volumen.
Conclusión
El frozen tier reduce claramente el hardware necesario para conservar logs antiguos, a cambio de una latencia variable y de un repositorio de snapshots que pasa a ser crítico. Pruébalo con tus consultas reales antes de enviarle datos de los que depende un SLO.
Blog independiente, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Las cifras del proveedor citadas proceden de la documentación y de un benchmark de Elastic, no de mediciones de span.observer. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.