Un despliegue de Kubernetes termina bien, pero los hosts no aparecen en Dynatrace, o una parte de los pods de aplicación se queda sin OneAgent. Para diagnosticar DynaKube hace falta un orden de trabajo preciso: sin él, se leen logs al azar mientras la cobertura de monitorización sigue incompleta y el MTTR se alarga.
Esta guía práctica describe el procedimiento que propone la documentación de Dynatrace para Dynatrace Operator: el estado del DynaKube, el subcomando troubleshoot, los logs, la lectura de las anotaciones de inyección y, por último, el subcomando support-archive para preparar un ticket. El enfoque es deliberadamente distinto del artículo sobre la conexión del Operator a un clúster Managed: aquí partimos de un clúster ya instalado que se comporta mal.
Alcance: las páginas leídas son las de la documentación de Dynatrace SaaS (docs.dynatrace.com/docs). La página equivalente de la documentación Managed recoge la misma sección support-archive en el momento de la lectura, pero compruébala para tu versión.
Requisitos para diagnosticar DynaKube
- Acceso con
kubectl(oocen OpenShift) al namespacedynatrace, el namespace por defecto del Operator. - Dynatrace Operator 0.9.0 o superior para
troubleshoot, 0.11.0 o superior parasupport-archive, según la documentación. - Permiso para crear un pod en ese namespace, si quieres usar el método recomendado para el archivo.
Paso 1: leer el estado del DynaKube y de los pods
La documentación fija los primeros gestos: comprobar el DynaKube, lanzar el subcomando de diagnóstico, mirar los pods y, después, sus logs y su descripción.
kubectl get dynakubes -n dynatrace
kubectl -n dynatrace get pods
kubectl logs <nom-du-pod> -n dynatrace
kubectl describe pod <nom-du-pod> -n dynatrace
El número de pods varía según el modo de despliegue: Operator, OneAgent o controlador CSI. Un pod en CrashLoopBackOff o en Pending se lee primero con describe: los eventos suelen indicar la causa (imagen, recursos, volumen).
Paso 2: ejecutar el subcomando troubleshoot
Desde la versión 0.9.0, el Operator incluye un subcomando que comprueba la configuración básica. Según la documentación, verifica que el namespace existe, que la definición de recurso (CRD) y el DynaKube existen, que la URL de la API termina en /api, que el secret tiene el mismo nombre que el DynaKube (o el valor de .spec.tokens) con los tokens del Operator y de ingesta de datos, que el customPullSecret está definido, que el entorno es accesible desde el pod del Operator con los mismos parámetros (proxy, certificado) y que los registros de imágenes de OneAgent y ActiveGate son accesibles.
kubectl exec deploy/dynatrace-operator -n dynatrace -- dynatrace-operator troubleshootSi tu DynaKube tiene un nombre distinto del predeterminado, añade el argumento --dynakube <nom>. La captura siguiente reproduce el ejemplo de salida sin errores que da la documentación.
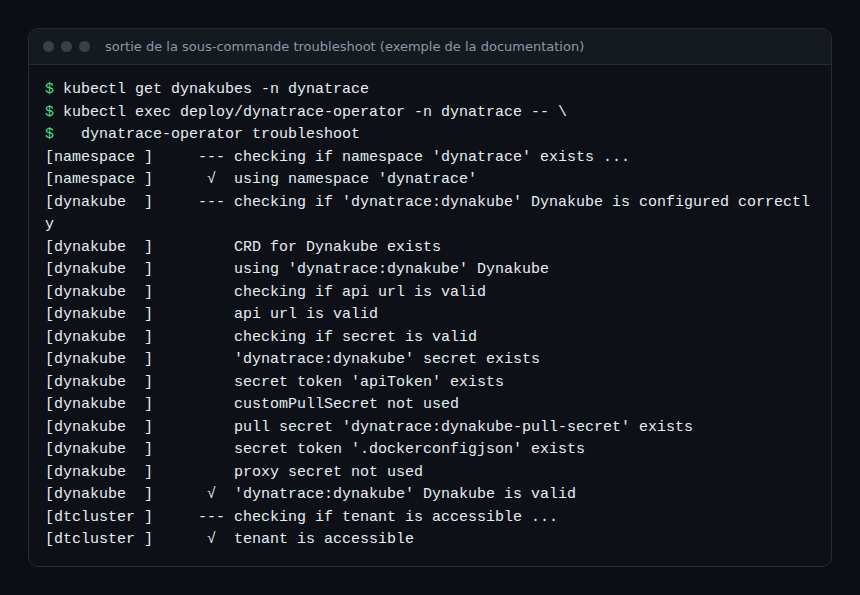
Lee la salida de arriba abajo: la primera línea marcada como fallo da la pista. Un token ausente, una URL de API mal formada o un tenant inaccesible se corrigen en el DynaKube o en sus secrets. Si el tenant es inaccesible aunque la red parezca correcta, revisa el proxy y el certificado: el comando los tiene en cuenta igual que el Operator.
Paso 3: leer los logs del Operator y de OneAgent
Para seguir el Operator en directo:
kubectl -n dynatrace logs -f deployment/dynatrace-operatorEn OpenShift, la documentación da el mismo comando con oc. Los pods de OneAgent desplegados por el Operator se leen con kubectl logs <pod-oneagent> -n dynatrace. En los hosts, los logs de OneAgent están por defecto en /var/log/dynatrace/oneagent.
Un consejo de método, sin relación con ningún requisito del fabricante: anota la hora del primer síntoma y filtra los logs a partir de ese momento. En un enfoque SRE sin búsqueda de culpables, esa cronología sirve también de base para el informe del incidente.
Paso 4: entender por qué se ignora una inyección
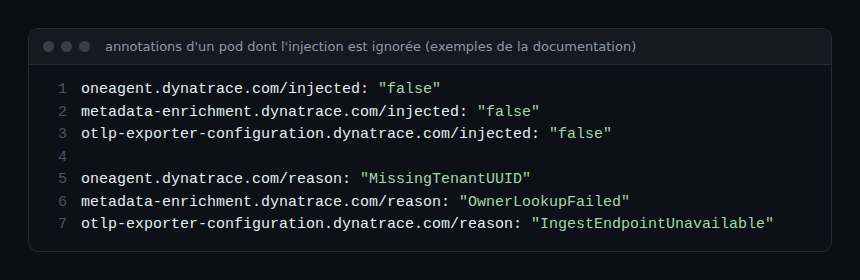
Cuando un pod de aplicación no está instrumentado, no busques primero en los logs del Operator: lee las anotaciones del pod. La documentación indica que existe una anotación injected: "false" para OneAgent, para el enriquecimiento de metadatos y para la configuración del exportador OTLP, cada una acompañada de una anotación reason.
Valor de reason |
Significado según la documentación |
|---|---|
NoBootstrapperConfig |
El webhook no encuentra o no crea el Secret de configuración del bootstrapper en el namespace del pod; a menudo, la reconciliación del DynaKube no ha terminado. |
NoMutationNeeded |
La inyección está desactivada, a menudo por anotaciones. |
OwnerLookupFailed |
No se pudo determinar el propietario del pod, a menudo porque la API de Kubernetes estaba lenta o inaccesible. |
MissingTenantUUID |
El identificador del entorno no está verificado, en general durante la instalación inicial o por un problema de reconciliación. |
DynaKubeStatusNotReady |
El estado de los CodeModules no está listo, el webhook no puede elegir uno. |
NoOTLPExporterConfigSecret, NoOTLPExporterActiveGateCertSecret |
Falta el secret de configuración del exportador OTLP, o falta el certificado de ActiveGate (útil solo si la exportación OTLP pasa por TLS hacia ActiveGate). |
IngestEndpointUnavailable |
No se pudo construir ninguna URL de ingesta válida. |
Estos valores relacionan directamente un síntoma con una causa: varios desaparecen por sí solos cuando termina la reconciliación, así que conviene releer el estado del DynaKube antes de reiniciar nada.
Caso particular: ImagePullBackOff con un registro privado
Los pods inyectados ejecutan un init container de Dynatrace que el nodo debe descargar. El customPullSecret del DynaKube solo cubre los componentes del Operator en el namespace dynatrace: no se transmite a los pods de aplicación. Según la documentación, este problema aparece a menudo tras pasar a Kubernetes 1.35, donde la funcionalidad KubeletEnsureSecretPulledImages está activada por defecto; la solución es distribuir un secret de pull a tus namespaces, nodos o pods de aplicación.
Paso 5: generar un support-archive para el soporte
Cuando el diagnóstico local no basta, support-archive (Operator 0.11.0 o superior) reúne en un archivo ZIP lo que necesita el soporte. Según la documentación, el archivo contiene:
kubernetes-version.txtyoperator-version.txt;- una carpeta
logscon los logs de todos los contenedores del Operator y de los componentes desplegados en su namespace, incluidos los contenedores anteriores si están disponibles (ActiveGate, OneAgent, webhook, controlador CSI, según lo que esté desplegado); - una carpeta
manifestscon los manifiestos de los componentes y de los DynaKube; troubleshoot.txt, la salida del comando del paso 2, lanzado automáticamente;supportarchive_console.logy, si las extensiones están activas, los archivos de diagnóstico del Extension Controller.
El método recomendado lanza un pod autónomo que reutiliza la imagen del Operator. El parámetro --delay=10 importa: sin él, kubectl run pierde las primeras líneas de salida y puede corromper el archivo. El serviceAccountName debe ser dynatrace-operator para acceder a los logs y a los manifiestos. El contenido del ZIP sale por la salida estándar y el resto por stderr.
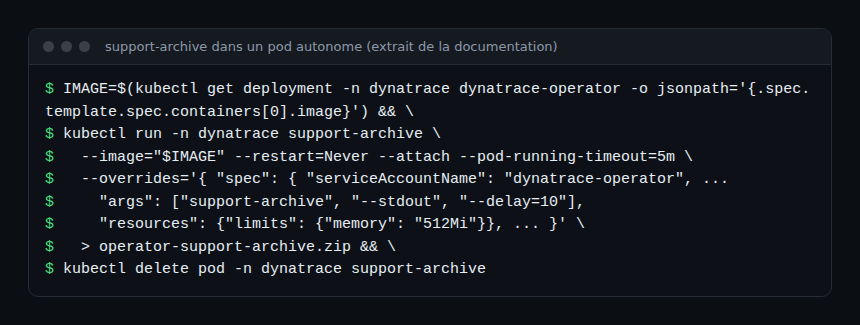
La captura es un extracto: el comando completo, con su bloque securityContext, figura en la documentación, y es el que debes copiar. Este método supone que los recursos del Operator siguen instalados en el clúster.
Si las políticas del clúster prohíben ese pod, la documentación admite, como último recurso, ejecutar el comando en el pod del Operator:
kubectl exec -n dynatrace deployment/dynatrace-operator -- dynatrace-operator support-archive --stdout > operator-support-archive.zipEn un clúster grande, el volumen de datos recopilados puede hacer que el Operator supere su límite de memoria y provocar una parada por falta de memoria (OOM kill), sobre todo si está infradimensionado. En Windows, usa el símbolo del sistema cmd.exe: PowerShell no es compatible.
Cómo comprobar que funciona
kubectl get dynakubes -n dynatracemuestra el DynaKube sin errores, ytroubleshootya no indica ningún fallo.- Los pods del namespace
dynatraceestán listos. - Tras reiniciar las cargas afectadas, los pods nuevos ya no tienen la anotación
injected: "false". - El archivo
operator-support-archive.zipse abre: un ZIP ilegible indica casi siempre una salida mezclada o truncada, de ahí el interés de--delay.
Buenas prácticas
- Sigue siempre el mismo orden: DynaKube,
troubleshoot, pods, logs, anotaciones y, por último, el archivo. Una checklist compartida reduce el MTTR y el toil. - Adjunta
troubleshooty el archivo a los tickets en lugar de extractos de logs aislados. - Antes de generar el archivo, revisa los manifiestos para no transmitir secretos: el archivo contiene manifiestos (comprueba qué contiene en tu caso, la documentación no detalla el enmascaramiento).
- Mantén el Operator al día: consulta la actualización de Dynatrace Operator.
- Para continuar, el enriquecimiento de metadatos de Kubernetes y el despliegue de OneAgent con el Operator explican los componentes cuyas anotaciones se leen aquí.
Preguntas frecuentes
¿Qué comando ejecutar primero para diagnosticar DynaKube?
kubectl get dynakubes -n dynatrace y, después, dynatrace-operator troubleshoot en el pod del Operator. Son los dos primeros gestos de la documentación.
¿Hay que ejecutar support-archive en el pod del Operator?
No, la documentación recomienda un pod autónomo. Ejecutarlo en el pod del Operator es un último recurso, con riesgo de parada por falta de memoria en un clúster grande.
Mi pod de aplicación no está instrumentado, ¿dónde miro?
En sus anotaciones: oneagent.dynatrace.com/injected y oneagent.dynatrace.com/reason. El valor de reason orienta hacia la causa, por ejemplo una reconciliación del DynaKube sin terminar.
Conclusión
Para diagnosticar DynaKube, quédate con una cadena corta: estado, troubleshoot, logs, anotaciones, support-archive. El diagnóstico se queda del lado de Kubernetes; no dice nada sobre la calidad de los datos una vez recopilados. Fuentes: documentación Kubernetes troubleshooting y General troubleshooting, consultadas en octubre de 2026.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Los comandos y las versiones evolucionan: compruébalos en la documentación oficial correspondiente a tu versión.