Lanzas una consulta DQL y devuelve solo unas pocas filas, o ninguna, aunque sabes que los datos existen. El culpable suele ser el DQL timeframe: la ventana de tiempo aplicada a la consulta no es la que crees. Este artículo explica de dónde viene esa ventana, cómo la modifican los parámetros from, to y timeframe, y qué otras causas producen un resultado escaso. Vale para Dynatrace SaaS (DQL y Grail); Dynatrace Managed no está afectado.
Para un equipo SRE, lo que está en juego es concreto: una consulta que cuenta de menos los errores falsea un diagnóstico, un SLI o un post-mortem. Mejor saber en unos segundos si el problema viene de la ventana, de un filtro o de un límite.
En resumen
- Sin parámetro de tiempo en la consulta, se aplica la ventana de la interfaz («global timeframe»).
- Según la documentación, la ventana por defecto es de 2 horas, salvo que se cambie en la aplicación o en la API.
fromytoenfetchprevalecen sobre el selector de la interfaz.- Un
limitcolocado antes de un agregado, un filtro demasiado estricto o un muestreo también explican un resultado reducido.
De dónde viene el DQL timeframe de una consulta
La documentación de DQL de Dynatrace, en la página «How to use DQL queries», recomienda elegir la ventana con los controles de la interfaz. Cuando la consulta no indica nada, se aplica el rango de tiempo elegido en la interfaz. La misma página indica que, salvo cambio en la aplicación o en la API, la ventana por defecto es de 2 horas.
Consecuencia directa: fetch logs a secas lee los logs de la ventana activa. Si el selector muestra las últimas 2 horas y el incidente es de ayer, la consulta devolverá pocas filas, o ninguna. No hay nada roto. La consulta responde a la pregunta formulada, pero sobre un periodo distinto del que buscabas.
Esta dependencia de la interfaz tiene otro efecto: dos compañeros que ejecutan la misma consulta con selectores distintos obtienen resultados distintos. En un notebook compartido, un dashboard o un workflow, escribir la ventana en la consulta evita esta trampa.
Fijar la ventana con from, to y timeframe
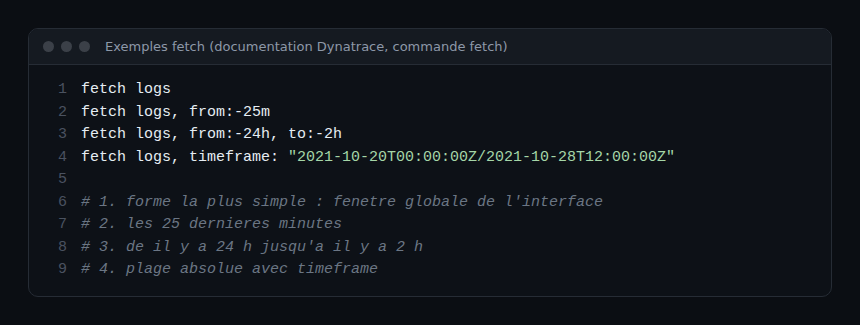
El comando fetch acepta, según la documentación «commands example», los parámetros opcionales from, to, timeframe, samplingRatio y scanLimitGBytes. Los ejemplos de abajo proceden de esa página. Los comentarios los hemos añadido nosotros.
Duraciones relativas con from y to
Las duraciones válidas para from y to son desfases respecto a now(): -25m significa 25 minutos antes de ahora, -2h dos horas antes. Así, la consulta fetch logs, from:-24h, to:-2h lee el periodo que va de 24 horas a 2 horas en el pasado. Es práctico para comparar con el periodo reciente o para excluir los últimos minutos, aún incompletos.
Según la página «How to use DQL queries», estos parámetros prevalecen sobre la selección hecha en la interfaz. Si una consulta contiene from:-10m, cambiar el selector a 7 días no cambia nada: la consulta sigue leyendo 10 minutos. Es la segunda gran fuente de sorpresas, la inversa de la primera.
Rango absoluto con timeframe
Para un rango fijo, por ejemplo la ventana de un incidente pasado, usa timeframe con dos marcas de tiempo ISO 8601 separadas por una barra, como en el ejemplo de la documentación: fetch logs, timeframe: "2021-10-20T00:00:00Z/2021-10-28T12:00:00Z". Según la documentación, from solo se usa cuando no se indica ningún timeframe explícito.
Por qué una consulta DQL devuelve pocas filas: la lista de comprobación
Avanza en este orden, de lo más frecuente a lo más raro. Cada punto se puede comprobar en unos segundos.
- ¿Qué ventana se aplica? Mira el selector de la interfaz y busca
from,tootimeframeen la consulta. Añade una ventana explícita, por ejemplofrom:-24h, y vuelve a ejecutar. - ¿Un
limitcorta demasiado pronto? El comandolimitlimita el número de registros devueltos. La página «DQL best practices» advierte: no pongaslimitantes de agregar, salvo intención explícita; si no, los agregados son erróneos. - ¿El filtro es demasiado estricto?
filterconserva solo los registros que cumplen la condición. Quita las condiciones una a una para ver cuál lo elimina todo. - ¿Hay un
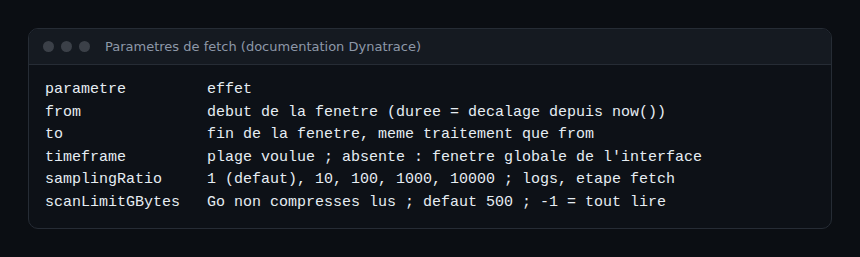
samplingRatio? Para los logs, un valor de 10, 100, 1000 o 10000 devuelve aproximadamente 1/N de los registros en bruto. El resultado no es determinista. - ¿Un
bucketrestringe el origen? La sintaxis defetchacepta un parámetrobucket; la página de buenas prácticas lo cita como medio de limitar los datos leídos. Un bucket mal elegido descarta los registros que buscas. - ¿Influye el tope de lectura?
scanLimitGBytescontrola la cantidad de datos sin comprimir que lee el pasofetch; el valor por defecto es de 500 GB, y-1analiza todos los datos de la ventana. En una ventana muy grande, comprueba este parámetro.
Un antes y después realista
Estas son dos consultas que cuentan los errores de logs. La primera acumula tres trampas: ventana implícita, limit antes del agregado y dependencia del selector. La segunda las corrige. Los nombres de campo son los que se usan habitualmente en los logs; adáptalos a tu entorno.
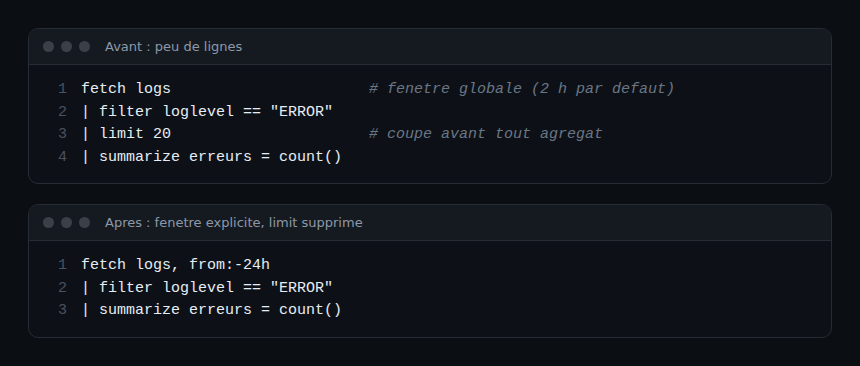
En la primera, el limit 20 reduce el flujo a veinte registros antes del summarize: el contador nunca pasará de 20, sea cual sea el volumen real. En la segunda, la ventana está escrita, y el contador abarca todos los errores de las últimas 24 horas. Si solo quieres mostrar unas filas de ejemplo, coloca el limit después de la agregación, o en una consulta aparte.
Comprobar que la consulta lee el periodo correcto
Tras la corrección, verifica en tres pasos:
- Ejecuta la consulta con una ventana amplia (
from:-7d) y luego con una estrecha: el número de filas debe variar de forma coherente. - Compara con una consulta mínima,
fetch logs, from:-24h | summarize count(), para conocer el volumen total antes del filtro. - Para un incidente pasado, usa
timeframecon marcas de tiempo absolutas, de modo que el resultado deje de moverse cuando cambie el selector.
Con grandes volúmenes, ten presente la buena práctica oficial: una ventana más corta da mejor rendimiento con datos idénticos, y hay que filtrar pronto, antes de seleccionar campos o agregar. Reducir la ventana no debe ser un reflejo ciego: elige la más corta que cubra tu pregunta.
Buenas prácticas
- Escribir la ventana en las consultas compartidas (notebooks, dashboards, workflows) en lugar de depender del selector.
- Filtrar pronto, ordenar al final y no poner nunca
limitantes de un agregado sin motivo. - Documentar el muestreo: si usas
samplingRatio:100, multiplica el recuento por 100 como en el ejemplo de la documentación, e indica que el resultado es aproximado. - Usar
timeframeen los post-mortems, para que el análisis sea reproducible, en el espíritu blameless de nuestros post-mortems basados en DQL.
Para ir más lejos
Si fetch, filter y las agregaciones aún te resultan poco familiares, empieza por el módulo sobre los fundamentos de DQL. Para consultas listas para usar sobre logs y trazas, mira nuestros ejemplos de consultas de operación, y para la lógica de filter y summarize, el artículo sobre los comandos DQL. El principio es el mismo que en la semántica de group by, detallada en nuestra guía sobre summarize: una consulta DQL hace exactamente lo que se le escribe, no lo que uno imagina.
En el lado de OpenTelemetry, este comportamiento afecta también a los logs y trazas que envías: si un exportador solo entrega desde hace unos minutos, una ventana demasiado antigua no mostrará nada. Comprueba el periodo antes de sospechar del Collector.
Preguntas frecuentes
¿Cuál es la ventana por defecto de una consulta DQL?
Sin parámetro de tiempo, la consulta usa la ventana elegida en la interfaz. Según la documentación de Dynatrace, el valor por defecto es de 2 horas, salvo cambio en la aplicación o en la API.
¿Qué diferencia hay entre from/to y timeframe?
from y to aceptan duraciones relativas a now(), como -24h, o marcas de tiempo. timeframe describe un rango completo, por ejemplo dos fechas ISO 8601 separadas por una barra. Si se indica un timeframe, from solo se usa cuando no hay timeframe explícito.
¿Por qué mi contador se queda en un número pequeño?
Busca un limit colocado antes del summarize. La documentación desaconseja este orden, salvo intención explícita, porque falsea los agregados.
Fuentes
- Comando fetch (commands example), documentación de Dynatrace
- How to use DQL queries, documentación de Dynatrace
- DQL best practices, documentación de Dynatrace
- DQL commands, documentación de Dynatrace
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios; los ejemplos de consultas son pedagógicos y deben adaptarse a tu entorno. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.