El DQL group by no existe con ese nombre: en Dynatrace Query Language, la agrupación se hace con el comando summarize y su parámetro by:{}. Si vienes de SQL, buscas el reflejo SELECT … GROUP BY …; en DQL escribes una agregación y después la lista de claves de agrupación, en un único comando colocado en el pipeline.
Esta guía muestra la traducción paso a paso: una clave, varias claves, los alias, el grupo null que aparece cuando falta un campo, la agrupación por tramos de tiempo o de valor con bin() y el equivalente de HAVING. Cada sintaxis procede de la documentación oficial de DQL, consultada en octubre de 2026.
El contenido vale para Dynatrace SaaS (plataforma Grail). Dynatrace Managed no tiene ni Grail ni DQL: allí se agrupa con las métricas y el Data Explorer. Para una visión de conjunto de los comandos, consulta los comandos DQL comentados; para consultas listas para copiar, consulta nuestras consultas DQL de operación.
DQL group by: la correspondencia con SQL
La sintaxis documentada del comando es la siguiente:
summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]Tres diferencias con SQL cuentan en el día a día:
- No hay un SELECT aparte: el resultado contiene únicamente las claves del
byy los agregados. Los demás campos desaparecen. - El orden es el del pipeline: el
filtercolocado antes desummarizehace deWHERE; el colocado después hace deHAVING. - Las llaves son opcionales para una sola clave: la página de comparación DQL/SQL de la documentación escribe
summarize count(), by:event.type.
La misma página da este ejemplo de agregación:
fetch events
| filter event.type == "travel.funnel.booking-payment"
| summarize sum = sum(amount), by:travelAgency
En SQL se escribiría SELECT sum(amount) AS sum FROM events WHERE … GROUP BY travelAgency.
Paso a paso: agrupar con summarize
Paso 1: una clave y un agregado
Contar los logs por nivel de severidad:
fetch logs
| summarize nb = count(), by:{loglevel}
Cada fila del resultado corresponde a un valor distinto de loglevel. Las funciones de agregación documentadas incluyen, entre otras, count, countIf, countDistinct, sum, avg, min, max, percentile y takeFirst.
Paso 2: nombrar las columnas con alias
Un alias se coloca delante del agregado y delante de la clave. Sin alias, la columna lleva el texto de la expresión, por ejemplo sum(value), poco práctico para el resto del pipeline.
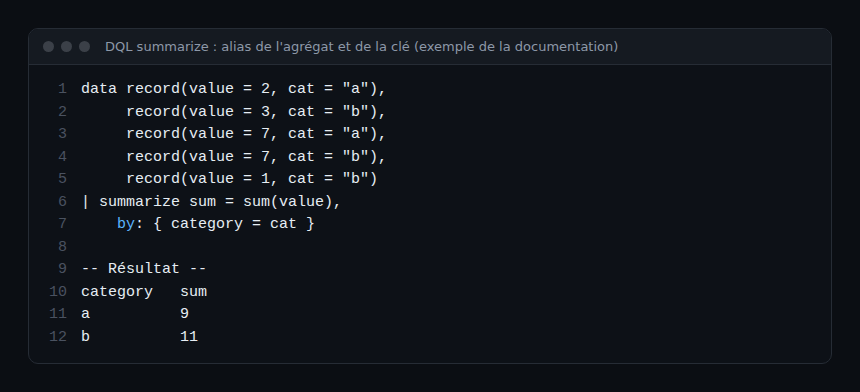
En este ejemplo sacado de la documentación, el agregado se convierte en sum y la clave cat se convierte en category. Los alias hacen legibles las ordenaciones y los filtros posteriores: | sort sum desc en lugar de repetir la expresión.
Paso 3: agrupar por varias claves
Enumera las claves entre llaves, separadas por comas. La documentación cuenta así los niveles de log por host y por grupo de procesos:
fetch logs
| summarize {
      errors = countIf(loglevel == "ERROR"),
      warnings = countIf(loglevel == "WARN")
    },
    by: {
      dt.entity.host,
      dt.entity.process_group
    }
Fíjate en las llaves alrededor de los agregados: agrupan varias agregaciones con nombre. countIf sustituye al clásico SUM(CASE WHEN … THEN 1 ELSE 0 END) de SQL y produce varios contadores en una sola pasada.
Paso 4: entender el grupo null
Si el campo de agrupación no existe en todos los registros, summarize añade un grupo null al resultado. Es la trampa más frecuente: un total que parece correcto, pero una fila null que concentra una parte de los datos.
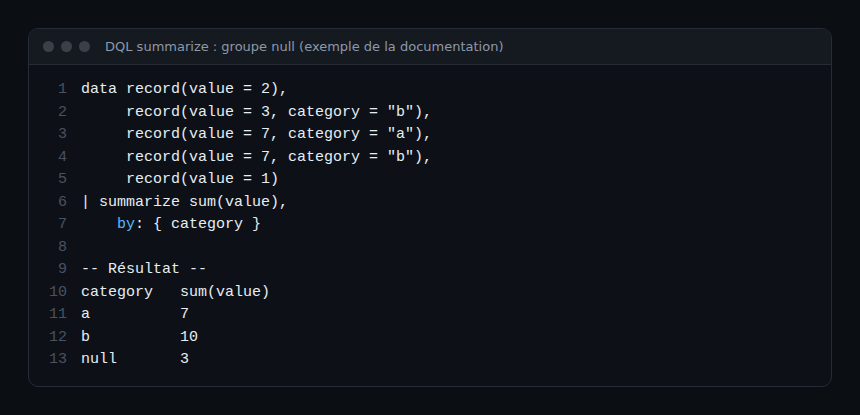
Dos respuestas posibles, según la necesidad:
// exclure les enregistrements sans clé
fetch logs
| filter isNotNull(k8s.namespace.name)
| summarize nb = count(), by:{k8s.namespace.name}

// ou garder la ligne null et l'investiguer
fetch logs
| summarize nb = count(), by:{k8s.namespace.name}
| sort nb desc
En operaciones, la fila null suele revelar un fallo de enriquecimiento: logs que llegan sin metadatos de Kubernetes, por ejemplo. Excluirla sin mirar oculta el problema.
Paso 5: agrupar por tramos con bin()
La función bin(expression, interval) redondea un valor hacia abajo al múltiplo del intervalo. La documentación precisa que se usa a menudo con summarize y by. Acepta un número, una duración o una marca de tiempo:
fetch logs
| summarize nb = count(), by:{minute = bin(timestamp, 1m), loglevel}
| sort minute asc
Para un valor numérico, bin(x, 10) coloca 27 en el tramo 20; el parámetro opcional at: desplaza los tramos (bin(x, 10, at:5) coloca 27 en el tramo 25). Es el equivalente en DQL de un histograma GROUP BY FLOOR(x / 10) * 10.
Para series temporales destinadas a un gráfico, el comando makeTimeseries, con su propio parámetro by, produce series homogéneas con intervalos regulares. summarize con bin() sigue siendo más sencillo para una tabla.
Paso 6: el equivalente de HAVING
Añade un filter después del summarize:
fetch logs
| filter loglevel == "ERROR"
| summarize erreurs = count(), by:{dt.entity.host}
| filter erreurs > 100
| sort erreurs desc
| limit 10
El primer filter reduce los datos leídos (el WHERE), el segundo conserva los grupos que superan el umbral (el HAVING). El comando sort acepta asc o desc para cada campo.
Cómo comprobar que la agrupación es correcta
- Controla el total: lanza la misma consulta sin
by. La suma de los grupos debe igualar el total, incluido el gruponull. - Busca la fila null:
| filter isNull(ma_cle)después delsummarizemuestra de inmediato si existe. - Comprueba el caso vacío: sin
byy sin registros de entrada,summarizedevuelve igualmente una fila (count()a 0, los demás agregados anull). Un dashboard debe mostrar correctamente este caso, así como la tabla vacía de una consulta conbycuando no sale ningún grupo.
Buenas prácticas
- Filtra antes de agrupar: menos datos leídos, consulta más rápida y menos costosa.
- Nombra siempre agregados y claves: la consulta sigue siendo legible seis meses después, durante una guardia (on-call).
- Evita agrupar por un campo de alta cardinalidad (identificador de petición, contenido completo de un log). La documentación limita el tamaño combinado de las claves de agrupación a 128 kB por registro y aconseja truncar, por ejemplo con
substring(content, 0, 100). - Mantén visible la fila
nullen las consultas de diagnóstico; fíltrala solo en las vistas destinadas a los usuarios. - Para un SLI, agrupa por servicio y por estado y calcula después el ratio en una etapa
fieldsAdd: consulta la ruta de aprendizaje de métricas de Dynatrace SaaS.
Preguntas frecuentes
¿Existe un comando group by en DQL?
No. La agrupación pasa por summarize … by:{}. Para obtener solo los valores distintos, como un SELECT DISTINCT, la documentación muestra summarize count(), by:event.type seguido de fields event.type; el comando dedup es otra opción.
¿Por qué contiene mi resultado una fila null?
Porque al menos un registro no lleva el campo de agrupación. summarize lo coloca en un grupo null en lugar de ignorarlo. Filtra con isNotNull() antes de la agrupación si esos registros no te interesan.
¿Qué diferencia hay con el artículo sobre consultas DQL de ejemplo?
Esta guía se centra en la agrupación y sus trampas. Las consultas DQL de ejemplo cubren casos completos de operación, y la función DQL in() sirve para filtrar por una lista antes de agrupar.
Conclusión
El DQL group by se resume en un hábito: escribir el agregado y después by:{}, dentro del mismo summarize. Nombrar las columnas, vigilar el grupo null, segmentar con bin() y filtrar después de la agrupación para el HAVING bastan para cubrir lo esencial de las consultas de operación. Para ir más lejos con la topología, consulta DQL y Smartscape.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.