Los fallos silenciosos de los agentes de IA son los casos en que todo parece haber salido bien: la petición devuelve un estado 200, no se lanza ninguna excepción, ningún span está en error y, sin embargo, la respuesta es falsa, incompleta o se basa en un mal resultado de una herramienta. Un dashboard clásico sigue en verde. Es la trampa principal de operar agentes.
Este artículo propone un método para detectar una respuesta falsa: trazar cada paso del agente, separar el error técnico del error de contenido y adjuntar un resultado de evaluación a la traza. Los nombres de atributos proceden de la especificación OpenTelemetry GenAI, leída en su fuente. Valen para cualquier backend OTLP, incluido Dynatrace SaaS; aquí no se da ningún porcentaje, porque ninguno se ha leído en una fuente primaria.
Fallos silenciosos: por qué las alertas no los ven
La especificación de OpenTelemetry pide poner el estado de un span en Error cuando la operación termina con un error, e indicar error.type. También precisa que no es una regla fija para las respuestas «válidas pero malas»: saber si un resultado es un error depende del contexto. Para un agente, esto significa que una respuesta bien formada pero falsa no desencadena, por defecto, ninguna señal de error.
Estas son formas habituales de fallo silencioso, que debes adaptar a tu agente:
- una herramienta devuelve un resultado vacío u obsoleto y el agente lo ignora;
- el modelo se detiene por un motivo distinto del previsto (límite de longitud, filtro) y la respuesta queda truncada;
- el agente elige la herramienta equivocada o repite la misma llamada;
- la respuesta es fluida, pero no se apoya en ningún dato recuperado.
Ninguna de estas situaciones lanza un error HTTP. Para el seguimiento de costes de un bucle de agente, consulta el coste de un agente de IA en tokens; las señales son los mismos spans.
Trazar el agente: un span por paso
Las convenciones GenAI definen, con estado Development (es decir, sujetas a cambios), spans para los agentes. El span de llamada se llama invoke_agent {gen_ai.agent.name}: de tipo CLIENT para un agente remoto e INTERNAL si se ejecuta en el mismo proceso. Cada llamada a una herramienta produce un span execute_tool {gen_ai.tool.name} de tipo INTERNAL, con gen_ai.tool.name obligatorio.
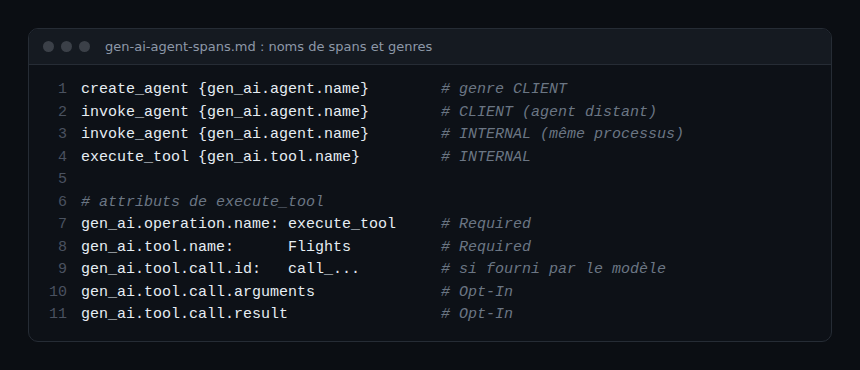
Esta estructura responde a la primera pregunta de diagnóstico: ¿qué paso salió mal? Un span execute_tool con duración nula o con resultado vacío señala la herramienta. Un span de inferencia con un valor inesperado en gen_ai.response.finish_reasons (atributo recomendado, matriz de los motivos de parada del modelo) señala el modelo. Para relacionar estos spans entre servicios, el Collector de OpenTelemetry sigue siendo la puerta de entrada habitual.
Capturar el contenido, con prudencia
Para juzgar una respuesta hay que verla. La especificación prevé la variable OTEL_INSTRUMENTATION_GENAI_CAPTURE_CONTENT, cuyos valores son NO_CONTENT (por defecto), SPAN_ONLY, EVENT_ONLY y SPAN_AND_EVENT. Un valor desconocido vuelve a NO_CONTENT.
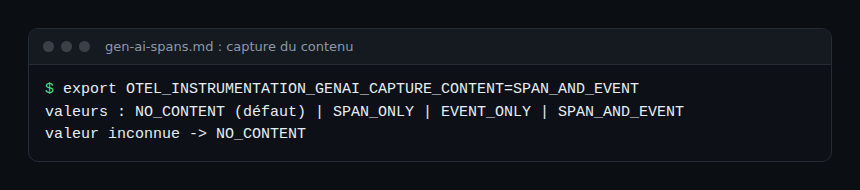
Los argumentos y resultados de las herramientas (gen_ai.tool.call.arguments, gen_ai.tool.call.result) son Opt-In: la documentación advierte de que algunos atributos pueden contener información sensible. Activa la captura sobre una muestra, con enmascaramiento de los datos personales, en lugar de hacerlo en todas partes. Las pistas para detectar abusos en las herramientas se describen en el artículo sobre el envenenamiento de herramientas MCP.
Detectar una respuesta falsa: el evento de evaluación
La especificación define el evento gen_ai.evaluation.result (estado Development, nivel Recommended). Lleva el resultado de una evaluación de la salida de un modelo: calidad, exactitud u otra característica. Debe asociarse al span evaluado cuando sea posible; si no, se indica gen_ai.response.id.
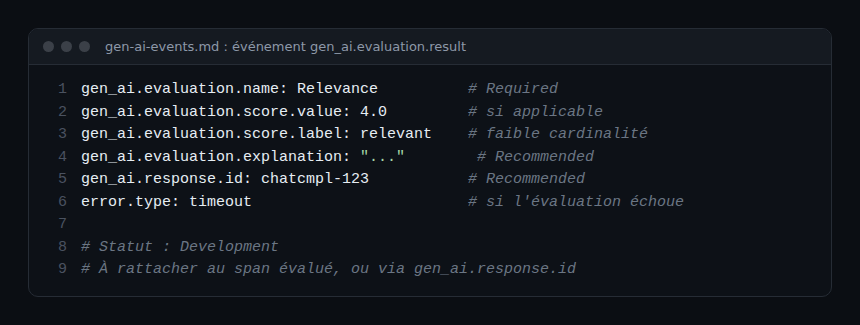
El nombre de la evaluación (gen_ai.evaluation.name, por ejemplo Relevance) es obligatorio. La puntuación numérica (gen_ai.evaluation.score.value) y la etiqueta (gen_ai.evaluation.score.label) se exigen «si procede»; la etiqueta debe tener baja cardinalidad. Si el propio evaluador falla, error.type lo indica: un evaluador caído no es una respuesta juzgada correcta.
¿Quién calcula la puntuación? La especificación no lo dice: solo describe cómo transportarla. Son posibles una comprobación determinista (¿la respuesta cita una fuente recuperada? ¿el JSON es válido?), un juicio humano sobre una muestra o un segundo modelo. Un modelo juez sigue siendo falible: hay que calibrarlo con casos anotados.
En el lado de Dynatrace SaaS, la página «Dynatrace for AI Observability» indica, según la documentación consultada, evaluaciones en línea de tipo LLM-as-a-judge sobre las trazas de producción, cuyas puntuaciones se escriben en business events vinculados a las trazas de origen, y una ingesta mediante OpenTelemetry con las convenciones GenAI. No se afirma ninguna equivalencia con los atributos anteriores: compruébalo en tu tenant.
Ponerlo en práctica: un plan en cuatro pasos
- Instrumenta el agente con una biblioteca que emita
invoke_agentyexecute_tool; comprueba los nombres realmente producidos, ya que la especificación está en desarrollo. - Define un criterio de éxito por tarea (respuesta basada en una fuente, herramienta llamada, formato válido) antes de buscar anomalías.
- Emite un resultado de evaluación sobre una muestra de peticiones, asociado al span o a
gen_ai.response.id. - Sigue la proporción de resultados «fail» por versión del agente, como un SLI de calidad, con un objetivo (SLO) definido por el equipo, no por una cifra prestada.
Para entender por qué una tasa de fallos bruta no basta, consulta la diferencia entre observabilidad y monitorización. Y si el volumen de trazas se vuelve pesado, el tail sampling permite conservar con prioridad las trazas cuya evaluación es mala.
Cómo comprobar que funciona
Repite una petición cuya respuesta esperada se conoce, forzando un fallo de herramienta (una herramienta que devuelve una lista vacía). La traza debe mostrar el span execute_tool y la evaluación debe salir como fallo. Si la evaluación sigue en «pass», el criterio es demasiado laxo. Si no llega ningún evento, revisa la asociación con el span o el gen_ai.response.id.
Buenas prácticas
- Separar la tasa de error técnico de la tasa de respuestas juzgadas falsas.
- Guardar la explicación del evaluador (
gen_ai.evaluation.explanation) para las revisiones humanas. - Limitar la captura de contenido y enmascarar los datos sensibles.
- Versionar el agente (
gen_ai.agent.version) para comparar antes y después de un cambio de prompt. - Mantener un conjunto de casos anotados para recalibrar el evaluador.
Preguntas frecuentes
¿Qué es un fallo silencioso de un agente de IA?
Es una ejecución que termina sin error técnico, pero cuyo resultado es falso o inutilizable. Los spans quedan sin estado de error, de ahí la necesidad de evaluar el contenido.
¿Son estables las convenciones OpenTelemetry GenAI?
No: las páginas leídas indican el estado Development para los spans de agente, el evento de evaluación y la mayoría de los atributos. Los nombres pueden cambiar; solo error.type figura allí como estable.
¿Hay que capturar todos los prompts y respuestas?
No. La captura está desactivada por defecto (NO_CONTENT) y el contenido puede ser sensible. Actívala sobre una muestra y protege el acceso.
Conclusión
Detectar una respuesta falsa exige una señal que las métricas de disponibilidad no ofrecen: una evaluación del contenido, asociada a la traza. Las convenciones de OpenTelemetry ofrecen un formato para transportarla; el criterio de calidad, en cambio, lo debe definir el equipo. Para continuar, consulta las barreras de seguridad de los agentes de IA en producción.
Fuentes: repositorio semantic-conventions-genai (Apache 2.0), OpenTelemetry: Recording errors, documentación de Dynatrace (SaaS).
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Las convenciones citadas están en desarrollo: comprueba la versión de la especificación antes de fiarte de ellas.