Lunes, 10:40. El checkout tarda ocho segundos en responder, el dashboard de la aplicación señala a «la base de datos» y nadie sabe todavía si es verdad. La observabilidad de bases de datos Dynatrace ofrece un camino corto para salir de la sospecha: una aplicación llamada Databases, alimentada por una extensión que consulta PostgreSQL desde un ActiveGate. Así lo plantearía yo, desde la traza sospechosa hasta el nodo del plan de ejecución que se lleva el coste.
Una aclaración antes de seguir: todo lo que sigue vale para Dynatrace SaaS. Las páginas que consulté hablan de Grail, del Hub y de la Platform Subscription, y ninguna dice que Managed se comporte igual, así que no lo afirmo. Si solo te interesa el detalle de la extensión, tiene su propio artículo: Extensión de Dynatrace para bases de datos. Aquí partimos del síntoma.
Observabilidad de bases de datos Dynatrace: del síntoma a la consulta
Una traza que muestra una llamada SQL de varios segundos solo demuestra que hay espera en la base, nada más. Para actuar hay que responder tres preguntas, en este orden: qué sentencia pesa más en el periodo, en qué se le va el tiempo (cálculo, disco, bloqueos) y qué nodo del plan es el responsable. La aplicación Databases contesta a las tres, siempre que la extensión esté en marcha. Sin ella, las pestañas se quedan vacías.
No hace falta instalar agentes en los servidores de bases de datos: la extensión lee métricas y estadísticas de consultas a distancia. Las pestañas útiles son Overview (estado general), Explorer (CPU, memoria y sesiones activas por instancia), Databases, Tables e Indexes (incluidos los índices poco usados), Recommendations (versión de la extensión, bases detectadas pero sin monitorizar, planes no disponibles) y Alert templates (alertas listas para usar según el fabricante). También cubre otros motores: Oracle, SQL Server, MySQL, Snowflake, SAP HANA, DB2 y MariaDB. Yo solo leí a fondo la página de PostgreSQL.
Antes de abrir la consola: la lista de comprobación
Lo que más tiempo me ha hecho perder en otros proyectos es descubrir un requisito a mitad del asistente. Por eso los reviso antes:
- la aplicación Databases está instalada desde el Hub;
- un ActiveGate de entorno de la versión 1.341.0 o posterior, con el Extension Execution Controller activo, llega al servidor PostgreSQL (consulta ActiveGate de entorno o de clúster);
- la extensión de PostgreSQL es la 3.2.4 o superior (3.1.2 para MySQL);
- tienes
settings:objects:writesobrebuiltin:licensing.new-database-monitoring-experience, o la política Settings Writer, y esta monitorización está incluida en tu Platform Subscription; - la conexión va directa al host monitorizado: sin balanceador, proxy ni pooler como pg-pool, porque un failover distorsiona las mediciones;
- la recolección de logs está activa, ya que ahí se guardan las consultas principales.
Preparar PostgreSQL sin sorpresas
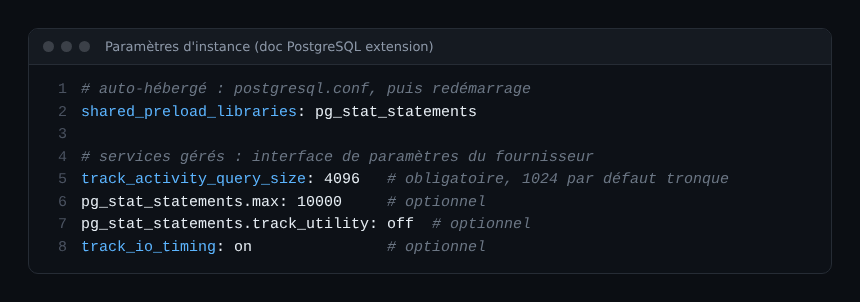
Dos ajustes determinan la calidad de los datos. El primero: pg_stat_statements debe estar en shared_preload_libraries; en una instalación propia se hace en postgresql.conf y con un reinicio, y además hay que instalar los binarios de hypopg. En RDS, Cloud SQL o Azure manda el grupo de parámetros del proveedor. El segundo: track_activity_query_size debe subir a 4096, porque con el valor por defecto de 1024 las consultas largas llegan cortadas y no se pueden leer.
Después hace falta un usuario dedicado, de solo lectura gracias al rol pg_monitor, y un esquema dynatrace que alojará la función con la que se obtienen los planes. La captura siguiente, sacada de la documentación, muestra las sentencias SQL que hay que ejecutar.
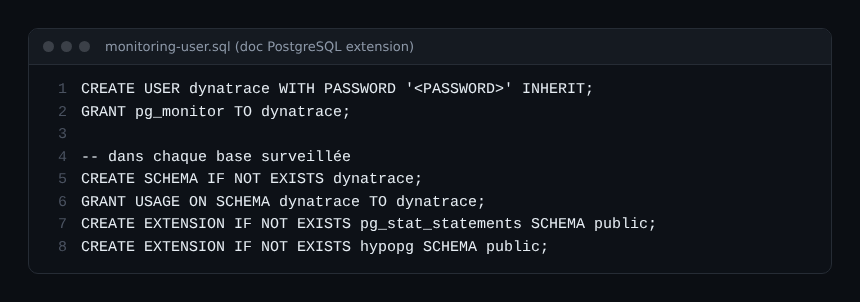
La contraseña que sustituye al marcador <PASSWORD> debe salir de tu gestor de secretos, no de un archivo compartido. En RDS o Aurora, la autenticación IAM elimina incluso ese secreto (requiere ActiveGate 1.325 o posterior).
Dar de alta la instancia en el asistente
«Add DB instance» recorre seis pantallas; las resumo por lo que realmente importa. Primero el fabricante (PostgreSQL) y el grupo de ActiveGate: será quien cargue con las consultas, así que elige uno que vea la red de la base. Después la configuración: frecuencia y feature sets, sobre todo Queries e Index Recommendations. Para la conexión, la documentación recomienda una sola base por instancia, normalmente postgres. Por último hay que descargar dos scripts, el de instalación y el de validación, y ejecutarlos desde una máquina Unix con Bash y psql. Cuando la validación pasa, «Start monitoring» arranca la recolección.
Primera comprobación: en Recommendations, «Monitor extension status» debe mostrar «Up to date» y el registro no debe tener errores, y la instancia debe aparecer en Explorer. Los datos llegan al bucket de Grail default_database_monitoring.
Seguir el rastro hasta la consulta culpable
El análisis se apoya en tres flujos, todos guardados como logs y reconocibles por su event.group:
top_queries: las 100 sentencias más costosas en tiempo acumulado, tomadas depg_stat_statementscada 5 minutos;longest_queries: las ejecuciones más largas observadas enpg_stat_activity, con el feature set Queries;execution_plans: el plan de una consulta del top, obtenido con la función auxiliar.
En la vista de análisis de sentencias filtro por un fragmento del texto SQL y alterno entre Time, CPU, Disk y Waits. Mi regla personal de lectura (no sale de la documentación): mucho Time y poca CPU, la consulta está esperando, por bloqueos o por E/S; mucho de ambos, es cálculo puro y lo más probable es que el plan tenga un problema.
Queda abrir el plan. El diagrama asigna un coste a cada nodo y resalta el más pesado. En el ejemplo de abajo, un único join absorbe el 95,7 % del coste total entre siete nodos: no tiene sentido pelearse con el resto.
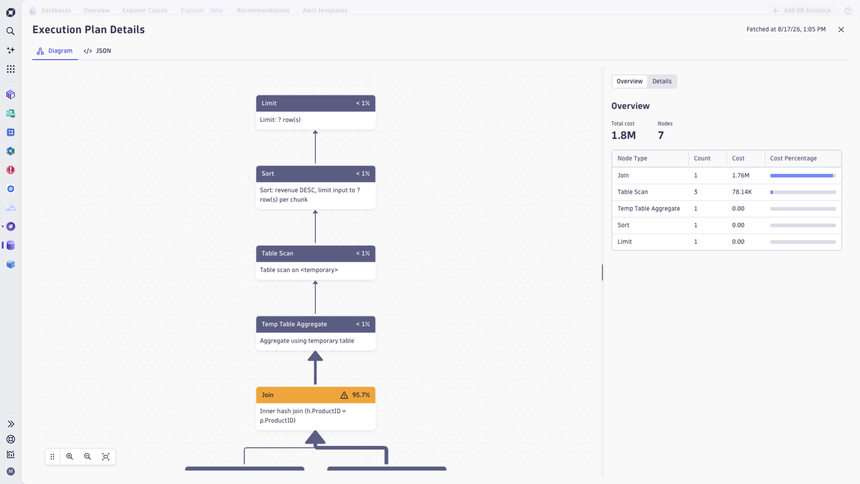
Si el nodo dominante es un recorrido completo de tabla en una consulta muy frecuente, sospecha de un índice que falta: hypopg permite probar índices hipotéticos sin crearlos. Para contrastarlo con lo que las aplicaciones escriben en sus registros, el método de análisis de patrones de logs es un buen complemento.
Dónde puedes tropezar
- Las sentencias
ALTERse excluyen de las top queries, por seguridad. - Obtener un plan exige
extensions:configuration.actions:write, y la consulta debe lanzarse desde la base donde vive la función auxiliar. - En servicios gestionados la monitorización tiene límites y requiere configuración manual, según la documentación.
- La extensión es gratuita, pero las métricas ingeridas se facturan y los logs van aparte. Estimación de la documentación: (68 × instancias) + (40 × bases) + (1 × tablespaces) puntos por minuto.
- Tras cada actualización de la extensión, vuelve a ejecutar los scripts de instalación y validación; si no, las métricas, las top queries o los planes pueden dejar de llegar.
- Sin verificar aquí: el detalle de MySQL, Dynatrace Managed y cualquier consulta DQL sobre estos logs (por eso no propongo ninguna).
Mi plan de adopción
Empieza con una base de pruebas y un solo feature set, mide la factura en puntos de datos y amplía después. Dedica un grupo de ActiveGate a las bases, con reglas de red ya validadas. Restringe la lectura del bucket default_database_monitoring con una política específica. Y por último, vincula un umbral de latencia SQL a un objetivo: el recorrido de formación sobre SLO y SLA explica cómo.
Preguntas frecuentes
¿Hay que instalar OneAgent en el servidor de la base de datos?
No para la extensión, que funciona sin agente en los hosts de las bases: un ActiveGate consulta la base a distancia. Eso sí, las métricas de host que aparecen en Overview proceden de hosts con OneAgent.
¿Sirve este método con MySQL?
La página de actualización menciona MySQL 3.1.2 o superior con el mismo asistente. Los permisos y parámetros de MySQL no están comprobados aquí; sigue la página de la extensión de MySQL.
¿Dónde veo las consultas lentas sin abrir la aplicación?
Las top queries, las longest queries y los planes son logs etiquetados con event.group: búscalos en la herramienta de logs, después de revisar el bucket y tus permisos de lectura.
En resumen
Para la observabilidad de bases de datos Dynatrace, quédate con la secuencia: instancia preparada, extensión desplegada por el asistente y, después, lectura de las top queries, los ejes Time/CPU/Disk/Waits y el plan de ejecución. Fuente: documentación de Dynatrace, Get started with database monitoring.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. La información procede de la documentación oficial, leída en noviembre de 2026; compruébala siempre en la documentación correspondiente a tu versión antes de llevarla a producción.