La correlación de logs y trazas con Elastic APM consiste en escribir en cada línea de log el identificador de la traza en curso, el campo trace.id. Durante un incidente, pasas entonces de una transacción lenta a sus logs, y de un error en un log a la traza completa, sin buscar por marca de tiempo. Este tutorial sigue tres pasos: activar la correlación en el agente, inyectar los identificadores e ingerir los logs.
La guía cubre dos casos, Node.js con Pino y .NET con Serilog. La información procede de la documentación de Elastic, consultada el 30 de octubre de 2026; los nombres de paquetes y de campos deben revisarse de nuevo para tu versión de la pila.
Para un equipo SRE, lo que está en juego es el tiempo de resolución (MTTR): cada salto manual entre dos herramientas alarga el incidente. Este artículo vale para Elastic, no para Dynatrace Managed ni Dynatrace SaaS; la última sección explica dónde se sitúa Dynatrace.
En resumen
- Un log está correlacionado cuando contiene
trace.idy tambiéntransaction.idospan.id. - El agente APM proporciona los identificadores; un formateador ECS (Elastic Common Schema) los escribe en el log.
- Los logs deben llegar al mismo Elasticsearch que los datos de APM.
Correlación de logs y trazas con Elastic APM: el principio
Según la documentación de Elastic sobre los logs de aplicación, la correlación permite ver el contexto de un log, todos los logs de una traza, y navegar entre logs y trazas. Un log ECS en JSON lleva campos como log.level, service.name, trace.id y transaction.id.
Distingue bien las señales. Una traza agrupa spans, es decir, operaciones cronometradas. Un log es un evento de texto. Nada los une, salvo el identificador que añades al log. De ahí los tres pasos que siguen.
La documentación indica también tres formas de enviar los logs. Filebeat o Elastic Agent recoge archivos de texto, sea cual sea el lenguaje. Un plugin ECS escribe JSON directamente aprovechable, a costa de cambiar la configuración del logger. El reformateo por el agente APM solo existe para Ruby, Python y Java, y el envío directo por el agente solo para Java: estas dos opciones no afectan a nuestros ejemplos.
Paso 1: activar la correlación en el agente
Para Node.js, el agente elastic-apm-node expone apm.currentTraceIds. Según la documentación de la API, esta propiedad devuelve un objeto con trace.id y con transaction.id o span.id, según el elemento activo; fuera de una transacción, el objeto está vacío. Está disponible desde la versión 2.17 del agente.
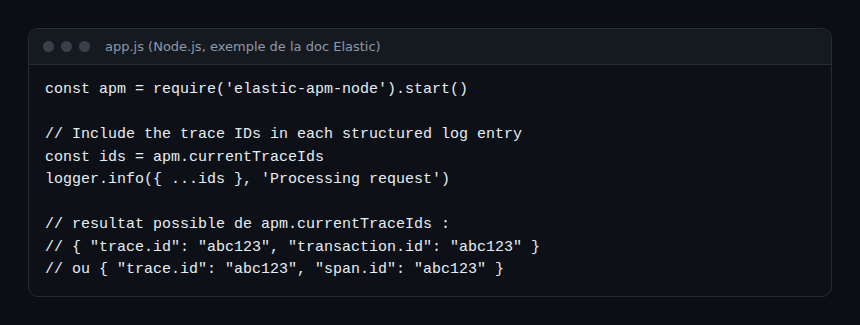
El agente debe arrancar antes que el resto de la aplicación. Sin transacción activa no hay identificador: un log escrito al arrancar o en una tarea fuera de una petición no estará correlacionado.
Para .NET, la documentación del agente enumera dos frameworks de logs compatibles: Serilog y NLog. Para otro logger, remite a una guía de inyección manual de los identificadores.
Paso 2: inyectar los identificadores en cada log
Node.js con Pino
Con un paquete de formato ECS para Pino, Winston o Morgan, la documentación precisa que el agente llama a la API por ti y que los identificadores se inyectan automáticamente. Para Pino, el paquete es @elastic/ecs-pino-format. Según su página, admite Pino 6, 7 y 8, y añade trace.id, transaction.id y span.id cuando el agente APM de Node.js está activo. La opción apmIntegration: false desactiva esta adición.
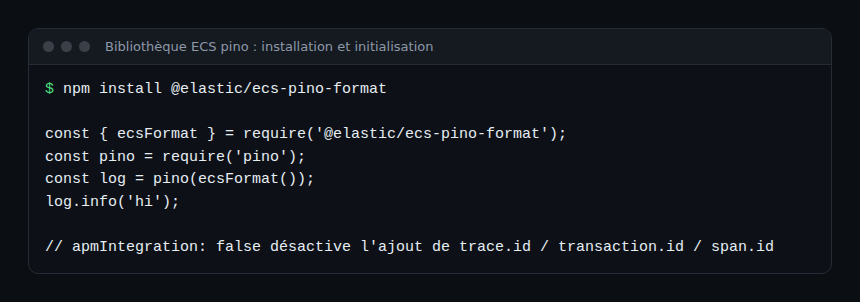
const apm = require('elastic-apm-node').start();   // en premier
const { ecsFormat } = require('@elastic/ecs-pino-format');
const pino = require('pino');

const log = pino(ecsFormat());
log.info('commande reçue');
Límite señalado por la misma página: los campos pasados a child() no se convierten, así que un objeto req colocado en un logger hijo no recibe los campos HTTP de ECS. Sin paquete ECS, añade tú mismo ...apm.currentTraceIds a cada entrada, como en la captura del paso 1.
.NET con Serilog
El repositorio elastic/ecs-dotnet describe dos paquetes. Elastic.Apm.SerilogEnricher añade los identificadores de traza y de transacción a los eventos de Serilog creados durante una transacción. Elastic.CommonSchema.Serilog proporciona EcsTextFormatter, que escribe los eventos en JSON ECS; combinados, los identificadores aparecen en la salida ECS.
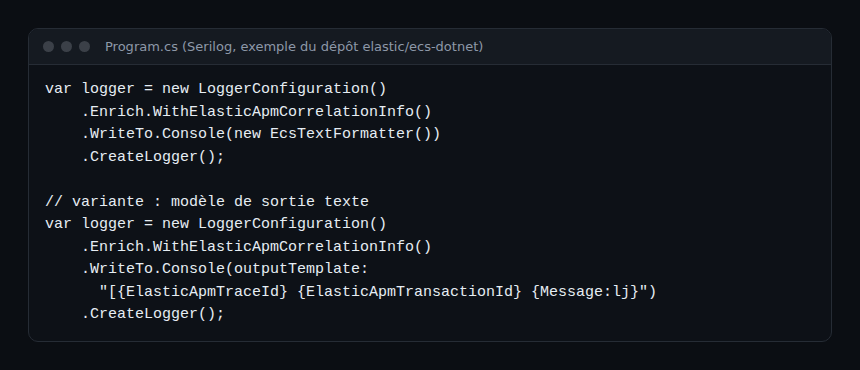
Para NLog, el paquete Elastic.Apm.NLog proporciona los marcadores ${ElasticApmTraceId} y ${ElasticApmTransactionId}, y EcsLayout los coloca en la salida ECS. Fuera de una transacción, estos marcadores quedan vacíos.
Paso 3: ingerir los logs en Elasticsearch
Los logs JSON ECS se escriben en la salida estándar o en un archivo, y después los recogen Filebeat o Elastic Agent. La página de Node.js pide enviar los logs a la misma instancia de Elasticsearch que los datos de APM. La página de .NET confirma que Filebeat permite enviar los logs, correlacionar trazas y logs, y pasar de APM a la exploración de logs.
El detalle de la instalación de Filebeat (archivos, Kubernetes, Docker) depende de tu entorno y figura en la documentación de la biblioteca ECS; la página de Pino precisa que Filebeat no está disponible en Elastic Cloud Serverless. Este artículo no lo detalla, por no haberlo verificado en cada caso.
Cómo comprobar que funciona
- Genera una petición al servicio instrumentado y lee la línea de log sin procesar: debe contener
trace.idytransaction.id. - En Kibana, abre el servicio en Observability y después su pestaña Logs. Según la documentación, puedes saltar de un log correlacionado a su traza, y se conservan el filtro de entorno, la consulta y el periodo.
- En Log Events, busca un
trace.idprocedente de una transacción fallida y elige Open logs in Discover para ampliar la consulta.
La pestaña Logs consulta los índices definidos en el ajuste avanzado observability:logSources; los índices personalizados requieren una configuración adicional.
Si la línea sin procesar no tiene identificador, revisa hacia atrás: agente iniciado demasiado tarde, ningún enriquecedor, o fuera de una transacción. Si lo tiene pero Kibana no muestra nada, comprueba la ingesta y los índices.
¿Y OpenTelemetry, y Dynatrace?
La documentación de Elastic enumera también guías de correlación para los SDK de OpenTelemetry de Elastic (Java, .NET, Node.js, PHP, Python); no las hemos abierto una por una. El principio es el mismo: un log lleva el identificador de traza y de span del contexto activo. Para entender el papel de cada señal, lee observabilidad y monitorización; para encaminar logs y trazas con un Collector, consulta el Collector en Kubernetes.
Para situar Elastic frente a otro proveedor, consulta la comparativa entre Dynatrace y Datadog, y para limitar el volumen de trazas conservadas, el muestreo por cola (tail sampling) con OpenTelemetry. No afirmamos ninguna integración entre Elastic APM y Dynatrace.
Buenas prácticas
- Inicia el agente antes que cualquier otro módulo; si no, algunas peticiones escapan a la instrumentación.
- Registra en JSON ECS en lugar de texto que haya que parsear: el formato queda fijado al escribir.
- No pongas nunca datos personales ni tokens en los mensajes de log.
- Prueba la correlación en tu pipeline de entrega: un log sin
trace.iden una ruta crítica es un defecto que corregir.
Preguntas frecuentes
¿Qué campos necesita un log para correlacionarse con una traza?
Según la documentación de Elastic para Node.js, un trace.id y también un transaction.id o un span.id.
¿Por qué algunos logs no tienen trace.id?
El identificador solo existe durante una transacción o un span activo; fuera de ese contexto, apm.currentTraceIds devuelve un objeto vacío. Un log escrito al arrancar o por una tarea en segundo plano no tiene, por tanto, identificador.
¿Hace falta Filebeat para correlacionar?
Hace falta un medio de ingerir los logs en el mismo Elasticsearch que el APM. La documentación cita Filebeat y Elastic Agent; el envío directo por el agente solo está documentado para Java.
Conclusión
Bastan tres gestos: un agente activo, un formateador que escriba trace.id en cada log y una ingesta hacia el clúster correcto. La ganancia se mide en la primera caída: una traza lenta lleva a sus logs en un clic.
Fuentes
- Log correlation, agente Node.js, documentación de Elastic
- Agent API Node.js, documentación de Elastic
- Stream application logs, documentación de Elastic
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios; los valores proceden de la documentación de Elastic: comprueba siempre los valores en la documentación oficial correspondiente a tu versión.