OpenObserve observabilidad open source: el repositorio openobserve/openobserve reúne en un solo binario escrito en Rust la ingesta, el almacenamiento y la consulta de logs, métricas, trazas, Real User Monitoring y, más recientemente, de la telemetría de aplicaciones LLM. El proyecto se presenta en su README como una alternativa a Datadog, Splunk y Elasticsearch, con almacenamiento en archivos Parquet sobre almacenamiento de objetos. Las insignias del repositorio muestran unas 23 000 estrellas, 1200 forks y la versión v1.1.2 el 30 de octubre de 2026.
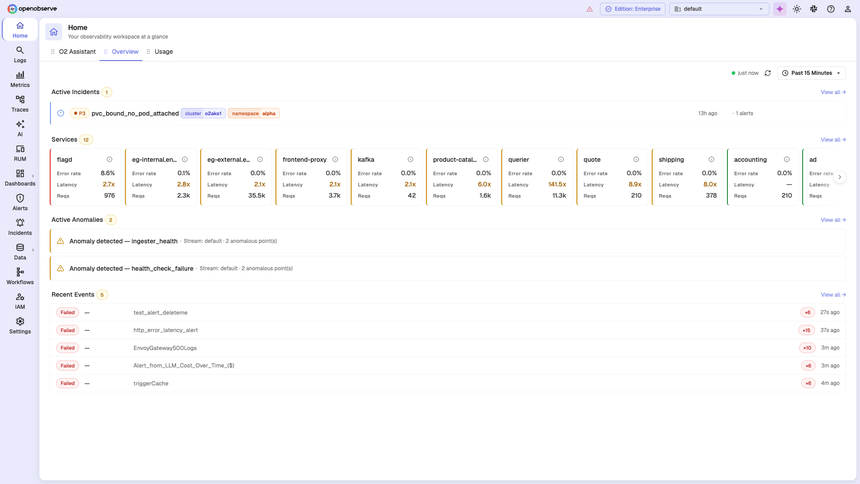
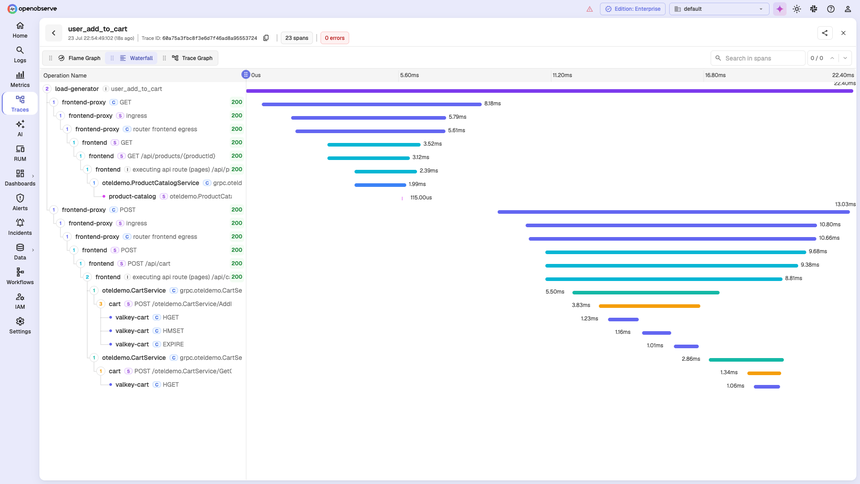
Para un SRE que conoce una plataforma comercial, la pregunta no es «¿esto sustituye a Dynatrace?» sino «¿qué obtengo, qué tengo que hacer yo mismo y para qué alcance?». Este artículo sigue el README y la documentación de openobserve.ai/docs, y después sitúa la herramienta frente a Dynatrace, sin menospreciarla ni sobrevenderla. span.observer no ha instalado ni medido OpenObserve: los comandos proceden del README y de la documentación, las dos primeras capturas de la carpeta screenshots/ del repositorio, y la tercera reproduce un extracto de la documentación de ingesta OTLP.
OpenObserve observabilidad open source: qué dice el repositorio
- Editor y licencia: el proyecto lo impulsa OpenObserve Inc. La edición de código abierto está bajo AGPL-3.0, verificada en el archivo LICENSE el 30 de octubre de 2026; el README remite a una entrada del proyecto que explica el paso de Apache 2.0 a AGPL. Una edición Enterprise con licencia comercial añade SSO (OIDC, SAML, LDAP), RBAC avanzado, registros de auditoría, búsqueda federada entre clústeres («Super Cluster»), redacción de datos sensibles y gestión de prioridades de consultas. El README anuncia un nivel gratuito de la edición Enterprise hasta 50 GB/día de ingesta, previo registro.
- Lenguaje y forma: Rust, un solo binario, interfaz web incluida. Imágenes de contenedor en
public.ecr.aws/zinclabs/openobserve, binarios para Linux, macOS y Windows en la página de releases. - Señales: logs, métricas, trazas, RUM con session replay, dashboards, alertas, incidentes, pipelines de transformación en la ingesta (funciones VRL), observabilidad de IA/LLM y un asistente que escribe SQL, VRL y PromQL. Consultas en SQL para logs y trazas, SQL o PromQL para métricas.
- Lo que lo ha hecho crecer: el README afirma un coste de almacenamiento «hasta 140 veces inferior» al de Elasticsearch gracias a Parquet y al almacenamiento de objetos. Es una afirmación del proyecto, ilustrada con su propio gráfico, no una medición independiente.
Recorrido por la interfaz
La página de inicio reúne los incidentes activos, una tabla de servicios con tasa de errores, latencia y peticiones, las anomalías detectadas y los últimos eventos de alerta. Conviene notar que las capturas publicadas por el proyecto llevan la mención «Edition: Enterprise».
La vista Traces ofrece tres lecturas de una misma traza: flame graph, waterfall y grafo de traza. El ejemplo del repositorio muestra una transacción de la demo de OpenTelemetry, 23 spans sin errores, desde el proxy frontal hasta las llamadas a Valkey del servicio de carrito.
Arquitectura: un binario, cinco roles
Según la página Architecture de la documentación, el mismo binario asume cinco roles de nodo: Router (proxy de las peticiones, sirve la interfaz), Ingester (recibe los datos, los convierte en Parquet, escribe en el almacenamiento), Compactor (fusiona los archivos pequeños, aplica la retención), Querier (ejecuta las búsquedas, sin estado) y Scheduler (alertas e informes). Existen dos modos:
- un solo nodo: metadatos en SQLite, datos en disco local o, con
ZO_LOCAL_MODE_STORAGE, en almacenamiento de objetos (S3, GCS, MinIO, RustFS, Azure Blob). La documentación lo reserva para usos ligeros y pruebas, aunque indica una ingesta de unos 31 MB/s medida por el proyecto en un chip Apple M2; - alta disponibilidad: Kubernetes y Helm, almacenamiento de objetos obligatorio, PostgreSQL para los metadatos, NATS para la coordinación, al menos un nodo de cada rol. El disco local no está soportado en este modo.
En cuanto a durabilidad, los ingesters conservan los datos en memoria y en un WAL local antes de enviarlos al almacenamiento de objetos: la documentación asume una copia única en tránsito, sin replicación a nivel de aplicación. La FAQ del README añade que los datos son inmutables: se eliminan periodos de retención completos, nunca un registro concreto.
Instalación paso a paso
Paso 1: arrancar un nodo de prueba
El comando del README inicia la edición de código abierto con una cuenta raíz definida por variables de entorno, que solo se pide en el primer arranque:
docker run -d \
  --name openobserve \
  -v $PWD/data:/data \
  -p 5080:5080 \
  -e ZO_ROOT_USER_EMAIL="[email protected]" \
  -e ZO_ROOT_USER_PASSWORD="Complexpass#123" \
  public.ecr.aws/zinclabs/openobserve:latest
La interfaz responde en http://localhost:5080 (ZO_HTTP_PORT; gRPC en ZO_GRPC_PORT, 5081). El quickstart también propone binarios, un manifest StatefulSet para Kubernetes y, para producción, el chart de Helm del repositorio openobserve-helm-chart con un bucket creado de antemano y el operador CloudNativePG.
Paso 2: enviar trazas OTLP desde un Collector
OpenObserve recibe OTLP por HTTP y por gRPC. En HTTP, el exportador del Collector apunta a /api/<org> sin barra final: el Collector añade por sí mismo /v1/traces, /v1/logs o /v1/metrics, y una barra de más produce un 404. La autenticación es una cabecera Authorization: Basic (usuario y contraseña codificados); stream-name elige el flujo de destino y, en gRPC, la cabecera organization sustituye al segmento de la URL.
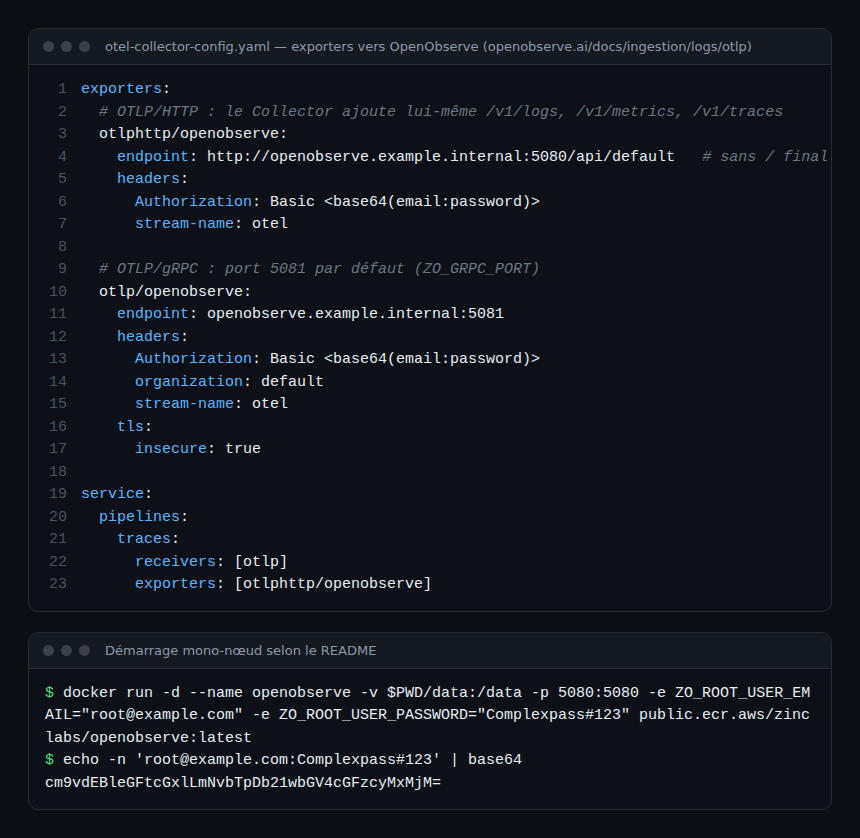
Para desplegar este Collector en un clúster, la división agente/gateway descrita en el Collector de OpenTelemetry en Kubernetes se aplica tal cual: solo cambia el exportador.
Paso 3: conectar Prometheus
Las métricas también llegan por remote write. La documentación ofrece una sección remote_write para pegar en la configuración de Prometheus:
remote_write:
  - url: http://openobserve.example.internal:5080/api/default/prometheus/api/v1/write
    queue_config:
      max_samples_per_send: 10000
    basic_auth:
      username: [email protected]
      password: Complexpass#123
Otras entradas documentadas: Vector, Fluent Bit, Fluentd, Filebeat, syslog, Splunk HEC, Kinesis Firehose, Telegraf y la instrumentación eBPF OBI de OpenTelemetry. Sobre Prometheus frente a OTLP para las métricas, consulta OpenTelemetry y Prometheus, complementarios.
Paso 4: comprobar
En la interfaz, menú Logs o Traces, selecciona el flujo indicado en stream-name: las entradas aparecen en pocos segundos. Si no, la documentación señala tres causas: barra final, cabecera Basic mal codificada, errores de exportación en los logs del Collector.
Frente a Dynatrace: alcance, coste, operación
- Recolección: OpenObserve es un backend. No proporciona un agente que descubra los hosts, inyecte la instrumentación y cartografíe las dependencias: tú aportas los SDK de OpenTelemetry, un Collector, Prometheus o Vector. Dynatrace, tanto en SaaS como en Managed, se apoya en OneAgent y ActiveGate para esa capa, y también acepta OTLP.
- Análisis: SQL, PromQL, grafo de servicios, alertas con detección de anomalías, incidentes que agrupan alertas, asistente que genera las consultas. El análisis causal sigue siendo manual. Dynatrace SaaS añade Grail y DQL, Davis y su causalidad topológica mediante Smartscape; Dynatrace Managed conserva Davis y Smartscape, sin Grail ni DQL. Es la diferencia de fondo que recuerda observabilidad y monitorización, la diferencia.
- Coste: la edición de código abierto es gratuita; pagas el cómputo, el almacenamiento de objetos, PostgreSQL, NATS y el tiempo de operación. Las tarifas por GB o por host se analizan en Dynatrace vs Datadog; la lógica de «stack abierto que hay que operar» en Dynatrace vs Grafana.
- Operación: actualizaciones, copias de seguridad de PostgreSQL, dimensionamiento de los ingesters, retención (
ZO_COMPACT_DATA_RETENTION_DAYS, 3650 días por defecto, mínimo 3) y seguridad de la cuenta raíz corren de tu cuenta.
Casos realistas para un SRE: un laboratorio que explora sus trazas OTel sin contrato; un alcance secundario (entornos de desarrollo, logs de herramientas internas) que no quieres facturar en la plataforma principal; un almacenamiento a largo plazo de logs de bajo valor. Un parque heterogéneo con exigencia de causalidad automática sigue siendo terreno de las plataformas comerciales.
Límites y puntos abiertos
- SSO, RBAC avanzado y auditoría están reservados a la edición Enterprise: en código abierto, la autenticación se basa en cuentas locales.
- La licencia AGPL-3.0 obliga a quien modifique el software y lo exponga en red a publicar sus modificaciones; haz que tu asesor jurídico valide este punto antes de un uso interno amplio.
- La telemetría anónima hacia el editor está activada por defecto (
ZO_TELEMETRY, a poner enfalse). - Durabilidad: una copia única en tránsito hasta el almacenamiento de objetos, por diseño; dimensiona y vigila el disco local del WAL.
- Las cifras de coste y rendimiento del README son las del proyecto: mide con tus propios datos.
Buenas prácticas
- Expón las métricas internas del servidor con
ZO_PROMETHEUS_ENABLED=true(endpoint/metrics) y recógelas: un backend de observabilidad sin supervisar es un punto ciego. - Mantén un Collector como gateway delante de OpenObserve: absorbe los picos y puede enviar una copia a otra plataforma durante una evaluación.
- Fija la retención por flujo desde el principio: como los datos son inmutables, no se corrige después.
- En producción, pasa al modo HA con almacenamiento de objetos; el nodo único en disco local queda para pruebas.
Preguntas frecuentes
¿OpenObserve es realmente open source?
Sí, la edición base está bajo AGPL-3.0 y el README la describe como completa. La edición Enterprise (SSO, RBAC avanzado, auditoría, búsqueda federada) tiene licencia comercial.
¿Qué formatos de ingesta admite?
OTLP por HTTP y gRPC para logs, métricas, trazas y perfiles, Prometheus remote write, además de Vector, Fluent Bit, Fluentd, Filebeat, syslog, Splunk HEC, Kinesis Firehose y Telegraf, según la documentación.
¿Se puede sustituir Dynatrace por OpenObserve?
Para un alcance pequeño instrumentado con OpenTelemetry, es un backend creíble. No proporciona ni agente de descubrimiento ni análisis causal automático, y la operación del clúster recae en ti.
Conclusión
OpenObserve merece su sitio entre los repositorios en tendencia: un binario, formatos abiertos, SQL y PromQL, un almacenamiento de objetos económico, una interfaz completa. Es un backend de observabilidad que hay que operar, no una plataforma llave en mano, y eso es precisamente lo que lo convierte en un buen terreno de aprendizaje y un buen complemento. Fuentes: repositorio openobserve/openobserve, documentación Architecture e ingesta OTLP.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a OpenObserve Inc. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.