OpenObserve observabilité open source : le dépôt openobserve/openobserve regroupe dans un seul binaire écrit en Rust l’ingestion, le stockage et la consultation des logs, des métriques, des traces, du Real User Monitoring et, plus récemment, de la télémétrie des applications LLM. Le projet se présente dans son README comme une alternative à Datadog, Splunk et Elasticsearch, avec un stockage en fichiers Parquet sur stockage objet. Les badges du dépôt affichent environ 23 000 étoiles, 1 200 forks et la version v1.1.2 le 30 octobre 2026.
Pour un SRE qui connaît une plateforme commerciale, la question n’est pas « est-ce que ça remplace Dynatrace ? » mais « qu’est-ce que j’obtiens, qu’est-ce que je dois faire moi-même, et pour quel périmètre ? ». Cet article suit le README et la documentation openobserve.ai/docs, puis situe l’outil face à Dynatrace, sans dénigrer ni survendre. span.observer n’a pas installé ni mesuré OpenObserve : les commandes viennent du README et de la documentation, les deux premières captures du dossier screenshots/ du dépôt, la troisième reproduit un extrait de la documentation d’ingestion OTLP.
OpenObserve observabilité open source : ce que dit le dépôt
- Éditeur et licence : le projet est porté par OpenObserve Inc. L’édition open source est sous AGPL-3.0, vérifiée dans le fichier LICENSE le 30 octobre 2026 ; le README renvoie vers un billet du projet expliquant le passage d’Apache 2.0 à l’AGPL. Une édition Enterprise sous licence commerciale ajoute le SSO (OIDC, SAML, LDAP), un RBAC avancé, les journaux d’audit, la recherche fédérée entre clusters (« Super Cluster »), la rédaction de données sensibles et la gestion de priorités des requêtes. Le README annonce un palier gratuit de l’édition Enterprise jusqu’à 50 Go/jour d’ingestion, avec inscription.
- Langage et forme : Rust, un seul binaire, interface web incluse. Images de conteneur sur
public.ecr.aws/zinclabs/openobserve, binaires Linux, macOS et Windows sur la page des releases. - Signaux : logs, métriques, traces, RUM avec session replay, dashboards, alertes, incidents, pipelines de transformation à l’ingestion (fonctions VRL), observabilité IA/LLM et un assistant qui écrit du SQL, du VRL et du PromQL. Requêtes en SQL pour les logs et les traces, SQL ou PromQL pour les métriques.
- Ce qui l’a fait monter : le README affirme un coût de stockage « jusqu’à 140 fois inférieur » à Elasticsearch grâce à Parquet et au stockage objet. C’est une affirmation du projet, illustrée par son propre graphique, pas une mesure indépendante.
Visite de l’interface
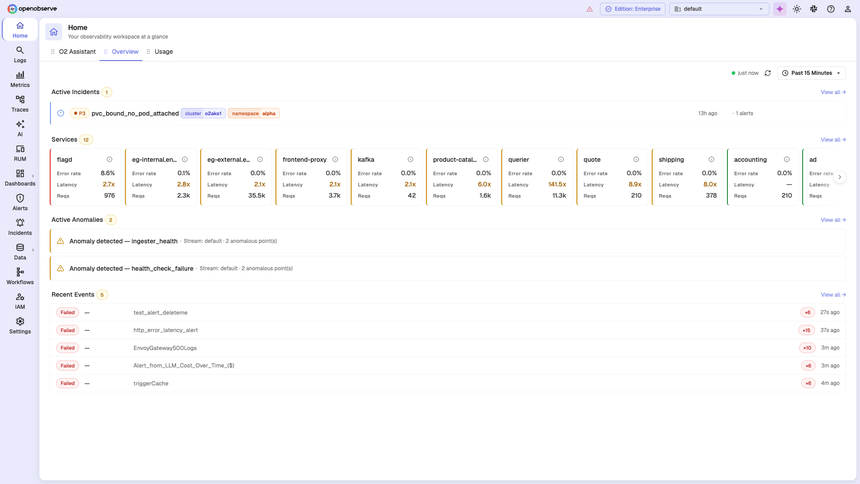
La page d’accueil réunit les incidents actifs, un tableau des services avec taux d’erreur, latence et requêtes, les anomalies détectées et les derniers événements d’alerte. On notera que les captures publiées par le projet portent la mention « Edition: Enterprise ».
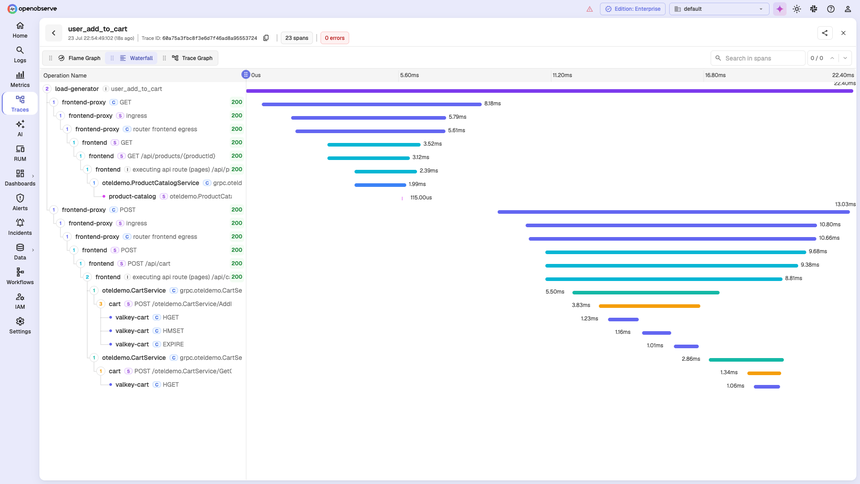
La vue Traces propose trois lectures d’une même trace : flame graph, waterfall et graphe de trace. L’exemple du dépôt montre une transaction de la démo OpenTelemetry, 23 spans sans erreur, du proxy frontal jusqu’aux appels Valkey du service panier.
Architecture : un binaire, cinq rôles
D’après la page Architecture de la documentation, le même binaire porte cinq rôles de nœud : Router (proxy des requêtes, sert l’interface), Ingester (reçoit les données, les convertit en Parquet, écrit vers le stockage), Compactor (fusionne les petits fichiers, applique la rétention), Querier (exécute les recherches, sans état) et Scheduler (alertes et rapports). Deux modes existent :
- mono-nœud : métadonnées en SQLite, données sur disque local ou, avec
ZO_LOCAL_MODE_STORAGE, sur stockage objet (S3, GCS, MinIO, RustFS, Azure Blob). La documentation le réserve aux usages légers et aux tests, tout en indiquant une ingestion d’environ 31 Mo/s mesurée par le projet sur une puce Apple M2 ; - haute disponibilité : Kubernetes et Helm, stockage objet obligatoire, PostgreSQL pour les métadonnées, NATS pour la coordination, au moins un nœud de chaque rôle. Le disque local n’est pas pris en charge dans ce mode.
Côté durabilité, les ingesters gardent les données en mémoire et dans un WAL local avant de les envoyer au stockage objet : la documentation assume une copie unique en transit, sans réplication applicative. La FAQ du README ajoute que les données sont immuables : on supprime des périodes de rétention entières, jamais un enregistrement.
Installation pas à pas
Étape 1 — Lancer un nœud de test
La commande du README démarre l’édition open source avec un compte racine défini par variables d’environnement, demandé seulement au premier démarrage :
docker run -d \
  --name openobserve \
  -v $PWD/data:/data \
  -p 5080:5080 \
  -e ZO_ROOT_USER_EMAIL="[email protected]" \
  -e ZO_ROOT_USER_PASSWORD="Complexpass#123" \
  public.ecr.aws/zinclabs/openobserve:latest
L’interface répond sur http://localhost:5080 (ZO_HTTP_PORT ; gRPC sur ZO_GRPC_PORT, 5081). Le quickstart propose aussi des binaires, un manifeste StatefulSet Kubernetes et, pour la production, le chart Helm du dépôt openobserve-helm-chart avec un bucket créé à l’avance et l’opérateur CloudNativePG.
Étape 2 — Envoyer des traces OTLP depuis un Collector
OpenObserve reçoit l’OTLP en HTTP et en gRPC. En HTTP, l’exportateur du Collector pointe sur /api/<org> sans barre oblique finale : le Collector ajoute lui-même /v1/traces, /v1/logs ou /v1/metrics, et une barre en trop produit un 404. L’authentification est un en-tête Authorization: Basic (identifiant et mot de passe encodés) ; stream-name choisit le flux de destination et, en gRPC, l’en-tête organization remplace le segment d’URL.
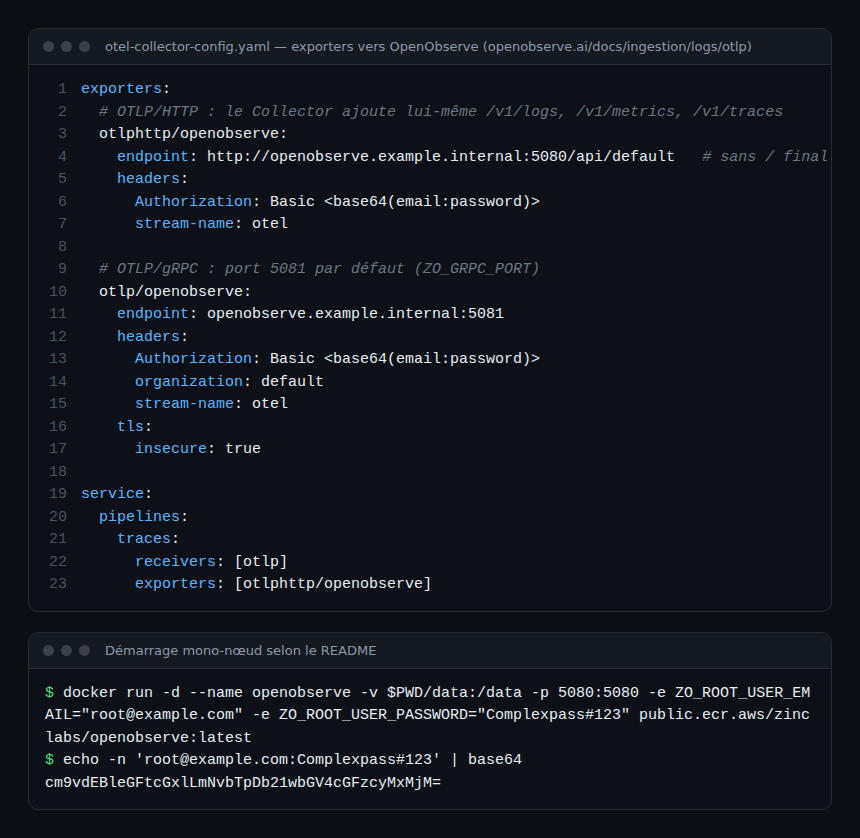
Pour déployer ce Collector sur un cluster, le découpage agent/gateway décrit dans le Collector OpenTelemetry sur Kubernetes s’applique tel quel : seul l’exportateur change.
Étape 3 — Brancher Prometheus
Les métriques arrivent aussi par remote write. La documentation donne une section remote_write à coller dans la configuration de Prometheus :
remote_write:
  - url: http://openobserve.example.internal:5080/api/default/prometheus/api/v1/write
    queue_config:
      max_samples_per_send: 10000
    basic_auth:
      username: [email protected]
      password: Complexpass#123
Autres entrées documentées : Vector, Fluent Bit, Fluentd, Filebeat, syslog, Splunk HEC, Kinesis Firehose, Telegraf et l’instrumentation eBPF OBI d’OpenTelemetry. Entre Prometheus et OTLP pour les métriques, voir OpenTelemetry et Prometheus, complémentaires.
Étape 4 — Vérifier
Dans l’interface, menu Logs ou Traces, sélectionnez le flux indiqué dans stream-name : les entrées apparaissent en quelques secondes. Sinon, la documentation pointe trois causes : barre oblique finale, en-tête Basic mal encodé, erreurs d’export dans les logs du Collector.
Face à Dynatrace : périmètre, coût, exploitation
- Collecte : OpenObserve est un backend. Il ne fournit pas d’agent qui découvre les hôtes, injecte l’instrumentation et cartographie les dépendances : vous apportez les SDK OpenTelemetry, un Collector, Prometheus ou Vector. Dynatrace, en SaaS comme en Managed, repose sur OneAgent et ActiveGate pour cette couche, et accepte aussi l’OTLP.
- Analyse : SQL, PromQL, graphe de services, alertes avec détection d’anomalies, incidents qui regroupent des alertes, assistant qui génère les requêtes. L’analyse causale reste manuelle. Dynatrace SaaS ajoute Grail et DQL, Davis et sa causalité topologique via Smartscape ; Dynatrace Managed garde Davis et Smartscape, sans Grail ni DQL. C’est la différence de fond rappelée dans observabilité et monitoring, la différence.
- Coût : l’édition open source est gratuite ; vous payez le calcul, le stockage objet, PostgreSQL, NATS et le temps d’exploitation. Les grilles au Go ou à l’hôte sont discutées dans Dynatrace vs Datadog ; la logique « stack ouverte à exploiter » dans Dynatrace vs Grafana.
- Exploitation : mises à jour, sauvegardes de PostgreSQL, dimensionnement des ingesters, rétention (
ZO_COMPACT_DATA_RETENTION_DAYS, 3 650 jours par défaut, minimum 3) et sécurité du compte racine sont à votre charge.
Cas réalistes pour un SRE : un laboratoire qui explore ses traces OTel sans contrat ; un périmètre secondaire (environnements de développement, logs d’outillage) qu’on ne veut pas facturer sur la plateforme principale ; un stockage long terme de logs à faible valeur. Un parc hétérogène avec exigence de causalité automatique reste le terrain des plateformes commerciales.
Limites et points ouverts
- SSO, RBAC avancé et audit sont réservés à l’édition Enterprise : en open source, l’authentification repose sur des comptes locaux.
- La licence AGPL-3.0 engage quiconque modifie le logiciel et l’expose en réseau à publier ses modifications ; faites valider ce point par votre juriste avant un usage interne étendu.
- La télémétrie anonyme vers l’éditeur est activée par défaut (
ZO_TELEMETRY, à passer àfalse). - Durabilité : une copie unique en transit jusqu’au stockage objet, par conception ; dimensionnez et surveillez le disque local du WAL.
- Les chiffres de coût et de performance du README sont ceux du projet : mesurez sur vos données.
Bonnes pratiques
- Exposez les métriques internes du serveur avec
ZO_PROMETHEUS_ENABLED=true(endpoint/metrics) et collectez-les : un backend d’observabilité non supervisé est un angle mort. - Gardez un Collector en passerelle devant OpenObserve : il absorbe les pics et peut router une copie vers une autre plateforme pendant une évaluation.
- Fixez la rétention par flux dès le départ : les données étant immuables, on ne corrige pas après coup.
- En production, passez en mode HA avec stockage objet ; le mono-nœud sur disque local est réservé aux tests.
Questions fréquentes
OpenObserve est-il vraiment open source ?
Oui, l’édition de base est sous AGPL-3.0 et le README la décrit comme complète. L’édition Enterprise (SSO, RBAC avancé, audit, recherche fédérée) est sous licence commerciale.
Quels formats d’ingestion sont pris en charge ?
OTLP en HTTP et gRPC pour logs, métriques, traces et profils, Prometheus remote write, plus Vector, Fluent Bit, Fluentd, Filebeat, syslog, Splunk HEC, Kinesis Firehose et Telegraf, selon la documentation.
Peut-on remplacer Dynatrace par OpenObserve ?
Pour un petit périmètre instrumenté en OpenTelemetry, c’est un backend crédible. Il ne fournit ni agent de découverte ni analyse causale automatique, et l’exploitation du cluster vous revient.
Conclusion
OpenObserve mérite sa place dans les dépôts tendance : un binaire, des formats ouverts, SQL et PromQL, un stockage objet économique, une interface complète. C’est un backend d’observabilité à exploiter, pas une plateforme clé en main, et c’est précisément ce qui en fait un bon terrain d’apprentissage et un bon complément. Sources : dépôt openobserve/openobserve, documentation Architecture et ingestion OTLP.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à OpenObserve Inc. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.