يصل نشرٌ جديد إلى الإنتاج، ثم تبدأ إعادات التشغيل بلا سبب ظاهر. أو العكس: تطبيق متعطل يواصل استقبال الحركة. في الحالتين تكون فحوصات liveness readiness startup (probes) في الغالب هي السبب: إذا ضُبطت جيدًا حمت التوافر، وإذا ضُبطت بشكل سيئ أضعفته. يستعرض هذا الدليل أكثر المزالق التسعة شيوعًا، وكلها مُتحقَّق منها في وثائق Kubernetes.
الهدف: ضبط فحوصات تبقى صحيحة تحت الحمل وعند الإقلاع وأثناء الحادثة التشغيلية، حتى لا نستهلك ميزانية الأخطاء (error budget) في إعادات تشغيل لا داعي لها. المحتوى Kubernetes خالص: يصلح لأي عنقود (cluster)، سواء كان تحت مراقبة Dynatrace SaaS أو Dynatrace Managed أو غيرهما. وللحالة القريبة، أي إعادات التشغيل في حلقة، راجع CrashLoopBackOff وOOMKilled.
فحوصات liveness readiness startup: ثلاثة أسئلة مختلفة
يجيب كل فحص عن سؤال مختلف، ويتفاعل kubelet مع الإخفاق بشكل مختلف.
| الفحص | السؤال المطروح | أثر الإخفاق |
|---|---|---|
startupProbe |
هل أنهى التطبيق إقلاعه؟ | يُقتل الحاوية ثم تخضع لـ restartPolicy |
livenessProbe |
هل ما زالت العملية قادرة على التقدم؟ | تُعاد الحاوية إلى التشغيل |
readinessProbe |
هل يمكنها استقبال الحركة الآن؟ | يخرج Pod من Services، من دون إعادة تشغيل |
وفق الوثائق، ما دام فحص startup معرَّفًا، لا ينفّذ kubelet فحص liveness ولا readiness قبل نجاحه الأول. أما فحص readiness فيعمل طوال حياة الحاوية. وهذا مثال الضبط الوارد في الوثائق، وهو يجمع الثلاثة:
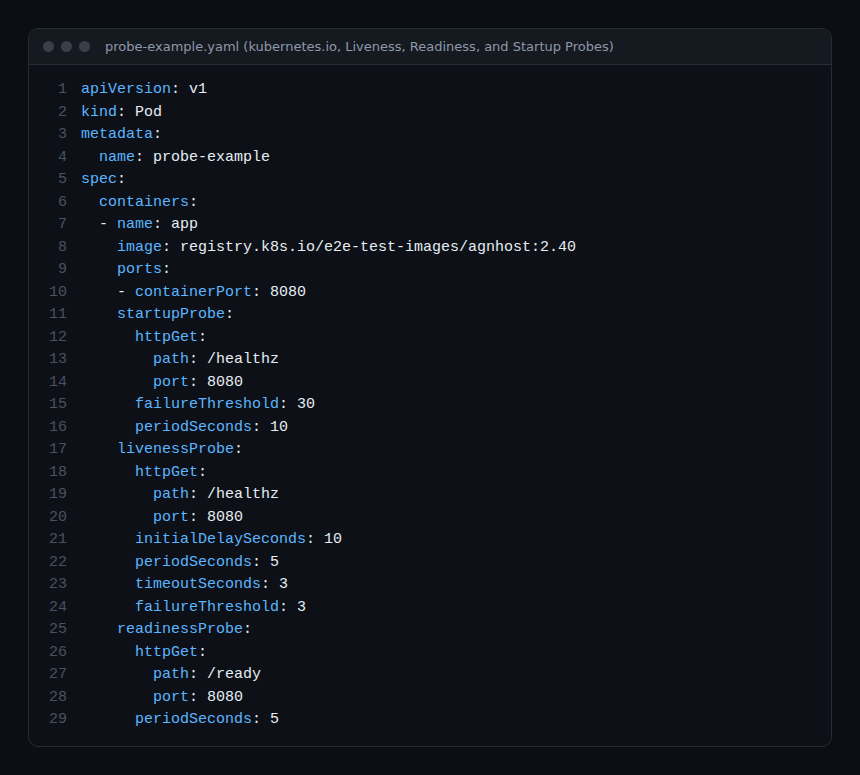
حقول الضبط وقيمها الافتراضية، وفق الوثائق نفسها: initialDelaySeconds يساوي 0، وperiodSeconds يساوي 10، وtimeoutSeconds يساوي 1، وsuccessThreshold يساوي 1 (وجوبًا 1 لـ liveness وstartup)، وfailureThreshold يساوي 3.
المزلق 1: فحص liveness يستعلم عن التبعيات
الوثائق صريحة: يجب أن يشير فحص liveness إلى عطل لا يمكن تعافيه، مثل deadlock. وقد يتسبب التنفيذ الخاطئ في إخفاقات متسلسلة: إعادات تشغيل تحت حمل مرتفع، وفشل طلبات العملاء، وزيادة الحمل على Pods المتبقية.
إذا اختبر فحص liveness قاعدة البيانات وتباطأت، أُعيد تشغيل جميع Pods في الوقت نفسه، مع أن إعادة التشغيل لا تحل شيئًا. اقصر اختبار التبعيات على فحص readiness. وتصف الوثائق هذا النمط: ينجح فحص liveness عندما يكون التطبيق سليمًا؛ ويتحقق فحص readiness بالإضافة إلى ذلك من الخدمات التي يحتاج إليها.
المزلق 2: تطبيق بطيء الإقلاع من دون startup probe
من دون startup probe، يبدأ فحص liveness بعد initialDelaySeconds ويتسامح مع failureThreshold إخفاقات تفصل بينها periodSeconds. وإذا استغرق الإقلاع أطول من هذا المجموع، قُتلت الحاوية قبل أن تصبح جاهزة ثم تبدأ من جديد: هذه هي حلقة إعادة التشغيل. وإطالة فحص liveness تبطئ اكتشاف deadlock حقيقي. توصي الوثائق بدلًا من ذلك بـ startup probe تستهدف نقطة الوصول نفسها:
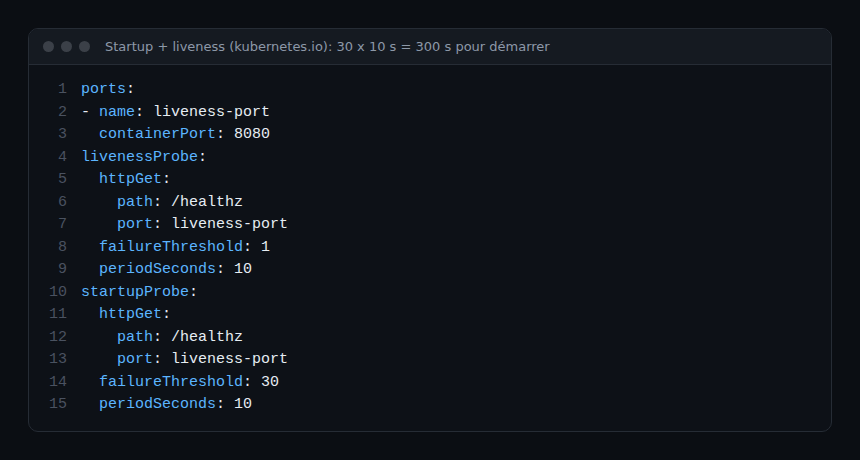
هنا يملك التطبيق 300 ثانية (30 × 10) للإقلاع. وبعد نجاح startup probe، يستأنف فحص liveness بسرعة استجابته الأصلية. وإذا لم تنجح startup probe أبدًا، قُتلت الحاوية بعد 300 ثانية وخضعت لـ restartPolicy.
المزلق 3: الظن بأن readiness وliveness ينتظر أحدهما الآخر
توضح الوثائق أن فحصي liveness وreadiness لا يعتمد أحدهما على الآخر. فلا ينتظر فحص liveness نجاح فحص readiness. ولتأجيل أحدهما، استخدم initialDelaySeconds أو startup probe. وإلا فقد يقتل فحص liveness العدواني حاويةً لم تنهِ استعدادها بعد.
المزلق 4: الخلط بين «غير جاهز» و«معطل»
عندما يخفق فحص readiness، يترك kubelet الحاوية تعمل ويواصل فحصها. ويجعل شرط Ready الخاص بـ Pod خاطئًا، فيسحب متحكم EndpointSlice عنوان IP الخاص بـ Pod من Services المعنية. ولا تحدث أي إعادة تشغيل. وهذا مقصود: تذكر الوثائق الأحمال الزائدة المؤقتة وتحميل ذاكرات التخزين المؤقت (caches) ضمن الاستخدامات.
نتيجتان عمليتان. أولًا، Pod في الحالة 0/1 وRunning ليس متعطلًا: إنه خارج الخدمة. ثانيًا، يُعدّ فحص readiness فاشلًا قبل التأخير الأولي: ومن الطبيعي ألا يتلقى Pod حركة في بداية حياته. وتفصيل حالة ActiveGate العالق عند 0/1 في ActiveGate Kubernetes not ready.
المزلق 5: مهلة الثانية الواحدة
القيمة الافتراضية لـ timeoutSeconds هي ثانية واحدة. فنقطة وصول تستجيب في 1,2 ثانية أثناء ذروة حمل تُحتسب إذن إخفاقًا. ومع فحص liveness، تكفي ثلاثة إخفاقات متتالية لإطلاق إعادة تشغيل، ما يفاقم الحمل. قِس زمن استجابة نقطة الوصول الفعلي تحت الحمل قبل ضبط هذا الحقل، ثم اترك هامشًا.
المزلق 6: فحص exec كثير التكرار
تحذّر الوثائق من أن فحوصات exec تنشئ عدة عمليات في كل تنفيذ. وعلى العقد ذات الكثافة العالية من Pods وبفواصل قصيرة، قد تكلّف وحدة المعالجة المركزية (CPU). وتتجنب الآليات httpGet وtcpSocket وgrpc هذه الكلفة. وفحص exec بقيمة periodSeconds: 1 على مئة Pod مرشح جيد للاستبدال.
المزلق 7: ما الذي يتحقق منه فحص HTTP فعلًا
- الرمز الأكبر من أو يساوي 200 والأصغر من 400 نجاح: فإعادة التوجيه 302 تمر كما يمر 200.
- مع
scheme: HTTPS، لا يتحقق kubelet من الشهادة. - يرسل kubelet الطلب إلى عنوان IP الخاص بـ Pod. وبالنسبة إلى مضيف افتراضي، عرّف الترويسة
HostفيhttpHeadersبدلًا من الحقلhost.
نقطة وصول تعيد 200 من دون اختبار أي شيء، مثل صفحة ثابتة، تعلن سلامة عملية عملها متوقف. اجعلها تختبر حدًّا أدنى: أن الحلقة الرئيسية تستجيب وأن الطابور غير مشبع.
المزلق 8: فحصا liveness وreadiness متطابقان
استخدام نقطة الوصول نفسها للفحصين مسموح، لكن الوثائق تقترح نمطًا أكثر أمانًا: نقطة الوصول الرخيصة نفسها، مع فحص liveness ذي failureThreshold أعلى. عندئذ يُلاحَظ Pod غير جاهز لبعض الوقت قبل أن يُقتل، ما يترك مجالًا للتعافي.
المزلق 9: نسيان مهلة الإيقاف
عند إخفاق فحص liveness أو startup، يحترم kubelet الحقل terminationGracePeriodSeconds: 30 ثانية افتراضيًا إذا لم يُحدَّد شيء. ومنذ Kubernetes 1.25، يوجد هذا الحقل أيضًا على مستوى الفحص (مستقر منذ 1.28) وتكون له الأولوية على حقل Pod. وترفضه API عند استخدامه مع فحص readiness.
كيف تتحقق من أن الأمر يعمل
تترك إخفاقات الفحوصات أحداثًا. اقرأها قبل تعديل أي شيء:
kubectl describe pod <pod> -n <namespace>
kubectl get events -n <namespace> --field-selector reason=Unhealthy
تعرض وثائق Kubernetes الأثر النموذجي لفحص liveness فاشل:
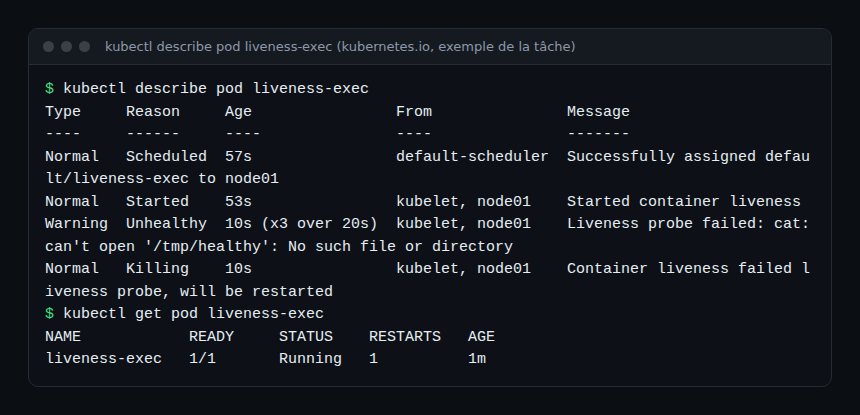
- تتوقف الأسطر Liveness probe failed أو Readiness probe failed عن الظهور بعد التصحيح.
- يستقر العمود RESTARTS في
kubectl get pods. - يبلغ العمود READY القيمة
1/1ويتلقى Pod الحركة من جديد.
في جانب المراقبة، راقب إعادات التشغيل وPods غير الجاهزة بدلًا من الفحوصات نفسها: راجع تنبيهات Kubernetes على العقد وPods والحصص. وقياسات زمن استجابة نقطة الوصول، المفيدة لضبط timeoutSeconds، تدخل في قياس التطبيق؛ ويُعرض الفرق بين إشارة الصحة وقابلية الملاحظة في قابلية الملاحظة والمراقبة.
أفضل الممارسات
- فحص liveness بسيط: لا يكتشف إلا ما تستطيع إعادة التشغيل إصلاحه.
- التبعيات الخارجية في فحص readiness فقط.
- startup probe بمجرد أن يتجاوز الإقلاع
initialDelaySeconds + failureThreshold x periodSeconds. - مهل مبنية على القياسات، لا على قيم منسوخة.
- بعد كل تغيير في الفحوصات، أعد قراءة الأحداث أثناء نشر تدريجي.
الأسئلة الشائعة
هل نحتاج إلى liveness probe في كل حاوية؟
لا. وفق الوثائق، إذا كانت العملية تتعطل من تلقاء نفسها عند حدوث مشكلة، فلا حاجة إلى فحص liveness: فـ kubelet يطبّق restartPolicy أصلًا.
ما الفرق بين startup وreadiness؟
لا تعمل startup probe إلا عند الإقلاع، ويؤدي إخفاقها إلى قتل الحاوية. أما readiness فتعمل طوال حياة الحاوية ولا تسحب إلا Pod من الحركة. وتقترح الوثائق استخدام readiness إذا أردت التمييز بين تطبيق فاشل وتطبيق ما زال يحمّل بياناته.
لماذا يكون Pod الخاص بي Running لكنه 0/1؟
لأن فحص readiness لديه يخفق: الحاوية تعمل، لكن Pod خارج Services. اقرأ أحداث Readiness probe failed لمعرفة الرمز أو الخطأ المعاد.
الخلاصة
لا تُضبط فحوصات liveness readiness startup مرة واحدة وللأبد: فهي تعبّر عما يعرفه الفريق عن سلوك التطبيق. وتكفي ثلاثة ردود فعل لتجنب معظم الحوادث: فحص liveness بسيط، وفحص readiness يتحمل التبعيات، وstartup probe لحالات الإقلاع البطيء.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع المذكورة. المقال مأخوذ من مدوّنة مستقلة، والسلوكيات الموصوفة هي ما ورد في وثائق Kubernetes التي روجعت في أكتوبر 2026؛ تحقق منها بحسب إصدار عنقودك. Dynatrace علامة تجارية لشركة Dynatrace LLC. العلامات المذكورة تعود إلى مالكيها. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.