

Browsing Tag
vLLM
8 posts
Ollama vLLM llama.cpp: ¿qué motor local elegir para tus LLM?
Ollama vLLM llama.cpp: compara estos tres motores de inferencia locales según el uso, el hardware y la supervisión (métricas, salud, trazas).

vLLM inferencia de LLM: instalar y supervisar el servidor
vLLM inferencia de LLM: instalación según la documentación, arquitectura, métricas de servicio (cola, caché KV, TTFT) y trazas OpenTelemetry.
Comparativa de LLM de código abierto: licencia, tamaño, VRAM y rendimiento medido en vLLM y Ollama
Comparativa de LLM de código abierto: licencia, parámetros, memoria de GPU y etiquetas de Ollama de 8 modelos, y cómo medir el rendimiento en vLLM.
Elegir un LLM en octubre de 2026: los criterios de operación antes que los benchmarks
Elegir un LLM en 2026 con criterios de operación: latencia, alojamiento, RGPD, observabilidad con OpenTelemetry y coste por tarea, con un piloto.
ONLYOFFICE IA local con Ollama o vLLM: arquitectura, configuración y monitorización
ONLYOFFICE IA local: conecta Docs 10.0 a Ollama o vLLM, ajusta aiSettings y el relé /ai-proxy, y monitoriza TTFT y StatsD con OpenTelemetry.
Mistral Large 4 autoalojado: qué está publicado, dimensionamiento y monitorización
Mistral Large 4 en autoalojamiento: pesos aún sin publicar, memoria necesaria para 1 billón de parámetros y monitorización de vLLM con varias GPU.
Stack de IA autoalojada de código abierto: comparativa de los componentes de una infraestructura de IA propia
Comparativa de una stack de IA autoalojada de código abierto: Ollama, vLLM, Open WebUI, LlamaIndex, CrewAI, Dify, n8n, Langfuse y combinaciones.
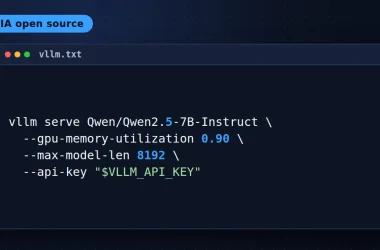
vLLM en producción: servidor compatible con OpenAI, métricas de Prometheus y monitorización de GPU
vLLM en producción: despliega un servidor compatible con OpenAI y vigila cola, KV cache, TTFT y GPU con Prometheus, OpenTelemetry y Dynatrace.