Elegir entre Ollama vLLM llama.cpp equivale a elegir un motor de inferencia local: el software que carga un modelo en memoria y responde a las peticiones. Los tres son de código abierto, los tres exponen una API HTTP y, sin embargo, no cubren la misma necesidad. Este artículo compara su uso, lo que ofrecen para la supervisión y la manera de decidir.
El enfoque es el de un equipo SRE o de plataforma. La pregunta no es solo «¿cuál es el más rápido?», sino «¿cuál se puede operar, supervisar y proteger?». Las afirmaciones siguientes proceden de la documentación oficial de cada proyecto, consultada en el momento de la redacción. No se ofrece ningún benchmark: el rendimiento depende demasiado del hardware y del modelo.
Ollama vLLM llama.cpp: tres filosofías
Ollama apunta a la simplicidad. Su repositorio presenta una API REST para ejecutar y gestionar modelos, y un comando ollama run para conversar con un modelo. Se publica bajo licencia MIT. Detallamos su instalación en nuestra guía Ollama LLM local.
vLLM se presenta como una biblioteca de inferencia y servicio de LLM «fácil, rápida y económica». Su documentación destaca PagedAttention para la memoria de atención, el batching continuo, el prellenado por fragmentos y la caché de prefijos. Ofrece un servidor compatible con la API de OpenAI. Consulta también vLLM en producción.
llama.cpp es una implementación en C/C++ sin dependencias, construida sobre la biblioteca ggml. Su README anuncia numerosos backends: Metal en Apple Silicon, CUDA, HIP, Vulkan, SYCL, además de la inferencia híbrida CPU y GPU para modelos más grandes que la VRAM. Enumera la cuantización de 1,5 a 8 bits. Su servidor, llama-server, se describe en nuestro artículo llama.cpp e inferencia local.
Comparativa: qué aporta cada motor
| Criterio | Ollama | vLLM | llama.cpp |
|---|---|---|---|
| Puesta en marcha | Un comando para ejecutar un modelo | Comando vllm serve |
Binario llama-server y archivo de modelo |
| Hardware citado por la documentación | No detallado en las páginas leídas | GPU NVIDIA y AMD, CPU x86, ARM, PowerPC, plugins | Muy amplio: Metal, CUDA, HIP, Vulkan, SYCL, CPU |
| Concurrencia | Paralelismo por modelo y cola de espera configurables | Batching continuo | Slots (--parallel) y batching continuo activo por defecto |
| Métricas Prometheus | No verificado en la FAQ leída | Endpoint /metrics |
Endpoint /metrics con la opción --metrics |
| Autenticación | No verificado; se recomienda un reverse proxy | No verificado en las páginas leídas | Opción --api-key |
Las casillas «no verificado» señalan una información ausente de las páginas consultadas, no la ausencia de la función. Relee la documentación de la versión que despliegues.
¿Cómo elegir un motor local según el uso?
Puesto de desarrollo o pequeño servicio interno
Ollama es la opción más directa. Los modelos se descargan y se lanzan sin compilar nada. Su FAQ documenta lo necesario para un uso compartido: OLLAMA_NUM_PARALLEL fija el número de peticiones procesadas en paralelo por modelo (1 por defecto), OLLAMA_MAX_QUEUE la cola de espera antes del rechazo (512 por defecto) y OLLAMA_MAX_LOADED_MODELS el número de modelos cargados simultáneamente.
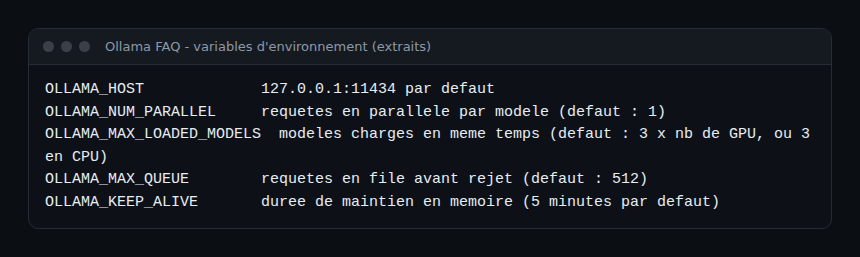
La FAQ precisa que el servidor escucha por defecto en 127.0.0.1, puerto 11434, y que OLLAMA_HOST cambia la dirección. Indica también que las peticiones paralelas agrandan el contexto efectivo: un contexto de 2K con 4 peticiones paralelas pasa a 8K y, por tanto, requiere más memoria.
Servicio de alto tráfico en GPU
Cuando muchos clientes llaman al mismo modelo, vLLM está diseñado para ello: el batching continuo agrupa las peticiones en curso. Su ventaja para la operación es la riqueza de sus métricas, detallada más abajo. El coste es una instalación más pesada y un hardware más exigente.
Hardware variado, CPU, Mac o edge
llama.cpp cubre el mayor número de plataformas y permite ejecutar un modelo cuantizado en una máquina modesta. También conviene cuando se quiere controlar con precisión las opciones o integrar el motor en otro software.
Supervisar el motor elegido
Un motor local es un servicio como cualquier otro: tiene SLI. Los más útiles son la disponibilidad, el tiempo hasta el primer token, la latencia de extremo a extremo, la longitud de la cola de espera y la tasa de errores. Un SLO sobre la latencia p95 evita que los usuarios descubran la saturación de la GPU.
vLLM: métricas ricas
La documentación de diseño de vLLM describe las métricas expuestas en /metrics en formato Prometheus. Entre ellas figuran:
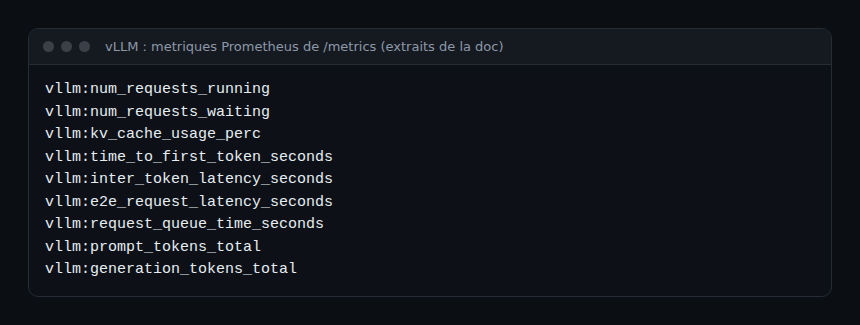
Estos nombres bastan para construir un panel: saturación (peticiones en espera, caché KV), latencia (histogramas) y caudal (contadores de tokens). La página señala también que algunas métricas están obsoletas o no implementadas: comprueba la lista de tu versión antes de crear alertas.
llama.cpp: salud, slots y métricas opcionales
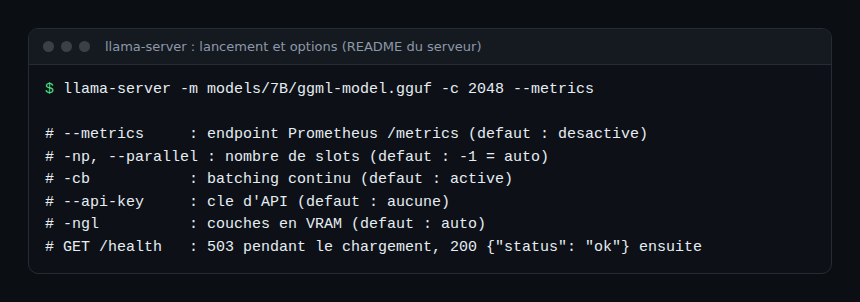
El README del servidor describe /health, público y exento de clave de API: responde 503 mientras se carga el modelo y luego 200 con {"status": "ok"}. El endpoint /metrics, compatible con Prometheus, solo existe si el servidor se lanza con --metrics (desactivado por defecto). Un endpoint /slots describe el estado de procesamiento de los slots; está activado por defecto y se desactiva con --no-slots.
Ollama: sondas y trazas del lado del llamador
Las páginas consultadas no describen un endpoint Prometheus para Ollama: este punto sigue sin verificar y debe comprobarse en las notas de versión. En la práctica se usa la API (sonda de disponibilidad, duraciones devueltas en las respuestas), los logs del servicio y las trazas del lado de la aplicación. El Collector de OpenTelemetry puede después encaminar esas señales hacia Dynatrace u otro backend, como se describe en OpenTelemetry de extremo a extremo. Para el seguimiento por llamada, la instrumentación en el cliente suele ser la solución más homogénea entre los tres motores: produce spans con la misma forma, sea cual sea el servidor detrás de una API compatible con OpenAI.
Buenas prácticas
- Elige según el tráfico esperado y el hardware disponible, no según una clasificación general.
- Mantén el puerto de escucha local por defecto y coloca delante del servicio un reverse proxy con control de acceso.
- Activa
--metricsen llama-server desde el principio; una métrica ausente no se recupera después de un incidente. - Fija un SLO de latencia y alerta sobre la cola de espera antes de la saturación.
- Mide con tus propios modelos y tus propias peticiones antes de decidir.
- Evita conservar los prompts completos en las trazas si contienen datos personales.
Preguntas frecuentes
Ollama y llama.cpp, ¿cuál es la diferencia?
llama.cpp es el motor de inferencia y su servidor; Ollama añade una capa de gestión de modelos y una API sencilla. El primero ofrece más control, el segundo más comodidad.
¿vLLM funciona sin GPU?
Su documentación cita CPU x86, ARM y PowerPC además de GPU NVIDIA y AMD. El rendimiento y la compatibilidad con un modelo concreto se comprueban versión por versión.
¿Qué motor es el más fácil de supervisar?
Según las páginas leídas, vLLM y llama.cpp exponen un endpoint Prometheus; en Ollama, la supervisión pasa sobre todo por la API, los logs y las trazas del lado del cliente.
Conclusión
Ollama conviene a usos sencillos y compartidos a pequeña escala, vLLM al caudal en GPU, llama.cpp a la diversidad de hardware y al control fino. En todos los casos, unos SLI de latencia, cola de espera y disponibilidad, alimentados por Prometheus u OpenTelemetry, hacen reversible la elección. Para situar estos motores en una arquitectura completa, consulta la comparativa de stacks de IA open source autoalojadas. Referencias: documentación de vLLM, repositorio de llama.cpp, repositorio de Ollama.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos Ollama, vLLM y llama.cpp. Dynatrace es una marca de Dynatrace LLC; las demás marcas citadas pertenecen a sus propietarios. Comprueba siempre las opciones en la documentación oficial correspondiente a tu versión.