Votre politique ILM annonce la phase warm ou cold, et pourtant l’index reste sur les nœuds hot. Dans la plupart des cas, le coupable est le réglage _tier_preference, que l’action migrate d’ILM est censée positionner. Cet article explique le mécanisme de la tier preference ILM dans Elasticsearch, les raisons documentées pour lesquelles il ne s’applique pas, et comment diagnostiquer puis corriger.
Pour une équipe SRE, l’enjeu est concret : un index qui ne descend pas de tier garde du stockage cher et des nœuds chauds saturés, alors que la politique a l’air saine. L’article vaut pour Elasticsearch auto-hébergé comme pour Elastic Cloud ; il ne concerne ni Dynatrace Managed ni Dynatrace SaaS, mais le diagnostic s’inscrit dans la supervision d’un cluster Elasticsearch décrite dans notre guide sur l’extension Dynatrace.
En bref
- ILM déplace un index entre les tiers avec l’action
migrate, qui écritindex.routing.allocation.include._tier_preference. - Selon la documentation Elastic, cette action est injectée automatiquement dans les phases warm et cold.
- Avec
"migrate": { "enabled": false }, ILM ne migre plus rien : c’est à vous de définir des règles d’allocation. - Des filtres d’attributs hérités (
require.data,allocateavecinclude,requireouexclude) peuvent entrer en conflit avec la tier preference.
Tier preference ILM : ce que le réglage fait vraiment
Le réglage index.routing.allocation.include._tier_preference indique à Elasticsearch sur quel tier placer les shards d’un index. D’après la page « Data tiers » d’Elastic, un index ordinaire reçoit data_content par défaut, et un index créé dans un data stream reçoit data_hot. Le réglage accepte une liste ordonnée, séparée par des virgules : Elasticsearch utilise le premier tier qui contient des nœuds.
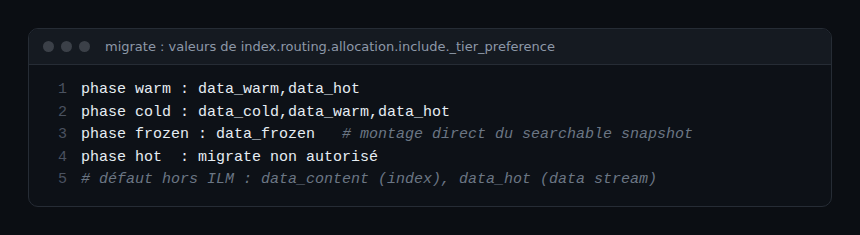
La page de l’action migrate précise les valeurs posées par ILM : data_warm,data_hot en phase warm, et data_cold,data_warm,data_hot en phase cold. Le repli sur les tiers plus chauds évite qu’un index reste non alloué quand le tier cible n’a pas de nœud. En phase frozen, ILM monte directement le searchable snapshot avec data_frozen ; en phase hot, migrate n’est pas autorisé.
Deux détails utiles : mettre le réglage à null supprime la préférence sans restaurer la valeur par défaut, et le réglage ne désalloue pas un shard déjà alloué. Pour les coûts du tier frozen, voir notre article sur le frozen tier.
Pourquoi ILM ne migre pas vos index
Cause 1 : l’action migrate est désactivée
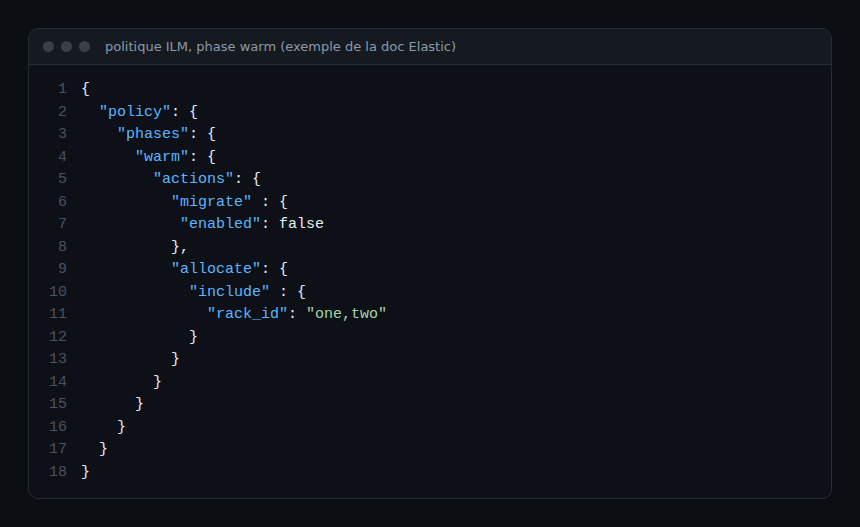
Le paramètre enabled de migrate vaut true par défaut. Le mettre à false dans une phase empêche la migration automatique. La documentation donne cet usage pour les équipes qui gèrent l’allocation à la main avec l’action allocate, et elle avertit : ne désactivez pas la migration automatique sans définir manuellement des règles d’allocation. Sinon, les données peuvent ne jamais atteindre le tier cible, alors que la phase s’affiche comme terminée.
Cause 2 : des filtres d’attributs personnalisés
L’action allocate accepte include (au moins un attribut listé), exclude (aucun) et require (tous), basés sur des attributs de nœud comme node.attr.box_type. Ces filtres relèvent de l’ancien modèle hot-warm-cold. La documentation Elastic ne décrit pas précisément comment require ou exclude se combinent avec _tier_preference : la page allocate n’en parle pas, et la page migrate renvoie vers elle. Ce point reste donc à tester sur votre version plutôt qu’à supposer.
Ce qui est documenté, en revanche, c’est le cas d’un index qui garde un ancien index.routing.allocation.require.data en conflit avec une tier preference périmée : il faut supprimer ce réglage et corriger la préférence. La documentation de migration demande aussi de retirer les filtres d’attributs des templates (hérités, composables et composants), sans quoi les nouveaux index les reprennent.
Cause 3 : aucun nœud n’a le bon rôle
En auto-hébergé, les rôles data_hot, data_warm, data_cold, data_frozen et data_content se déclarent dans elasticsearch.yml. Sur Elastic Cloud Hosted ou ECE, un tier partagé hot et content est inclus par défaut et ne peut pas être retiré ; warm, cold et frozen s’ajoutent dans l’interface. Sans nœud du tier cible, la liste de repli renvoie l’index vers un tier plus chaud, ce qui ressemble à une migration qui échoue.
Pour la politique de rétention en amont, voir aussi notre guide logsdb.
Diagnostiquer pas à pas
- Lisez l’état ILM avec
GET <index>/_ilm/explain: la réponse donne la politique, la phase, l’action et l’étape courantes. Le privilègemanage_ilmetview_index_metadataest requis. - Lisez les réglages de l’index et cherchez
index.routing.allocation.include._tier_preference, ainsi que d’éventuelsrequire.dataou autres filtres d’attributs. - Relisez la politique : phase warm ou cold avec
migrate.enabled: false? Une actionallocateavec filtres ? - Interrogez l’allocation avec
GET _cluster/allocation/explain(corps :index,shard,primary). La réponse liste, nœud par nœud, les deciders et leur décision (NO,YES,THROTTLE). - Vérifiez les rôles des nœuds dans
elasticsearch.ymlou dans la configuration du déploiement.
Corriger : passer des attributs aux data tiers
La documentation Elastic décrit un chemin de migration des filtres d’attributs vers les rôles de nœuds. Les étapes à retenir : attribuer les rôles de tier aux nœuds, nettoyer les actions allocate des politiques (une action allocate vide est invalide, il faut la supprimer), retirer les filtres des templates, puis mettre à jour les index existants (require.data à null et _tier_preference adapté). Chaque phase de chaque tier de votre architecture doit exister, même vide, pour qu’ILM puisse injecter migrate.
L’API POST /_ilm/migrate_to_data_tiers automatise trois de ces quatre étapes. Elle accepte dry_run (simulation, faux par défaut), legacy_template_to_delete et node_attribute, et liste dans sa réponse les politiques, index et templates migrés. ILM doit être arrêté avant l’appel.
POST /_ilm/stop
GET  /_ilm/status                          # attendre "operation_mode": "STOPPED"
POST /_ilm/migrate_to_data_tiers?dry_run=true
POST /_ilm/migrate_to_data_tiers
POST /_ilm/start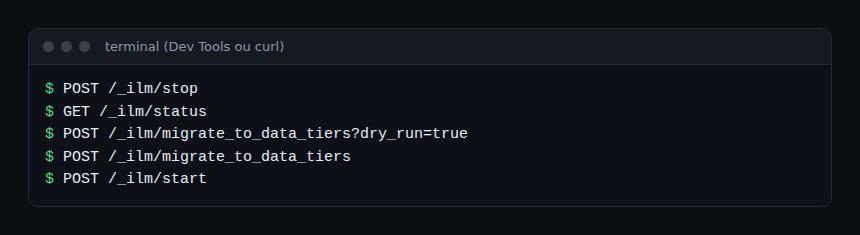
Lancez d’abord dry_run=true et relisez la liste des index et politiques touchés. Sur Elastic Cloud, selon la documentation, la migration est proposée automatiquement lors d’une mise à jour vers 7.10 ou plus, ou à l’ajout d’un tier warm, cold ou frozen ; il faut ensuite vérifier les templates personnalisés.
Comment vérifier que ça fonctionne
Relancez GET <index>/_ilm/explain et contrôlez que l’index avance dans les phases. Relisez ensuite le réglage _tier_preference : il doit correspondre à la phase (data_warm,data_hot en warm). Enfin, vérifiez que les shards sont sur les nœuds du tier attendu.
Lien avec l’observabilité
Un index bloqué sur le tier hot se voit d’abord dans les métriques du cluster : espace disque et nombre de shards par nœud. Exposez-les avec le Collector OpenTelemetry (guide Elasticsearch et OpenTelemetry) et alertez sur la saturation des nœuds hot plutôt que sur l’échec d’ILM seul, qui peut s’afficher comme terminé. Pour le contexte, relisez la différence entre observabilité et monitoring.
Bonnes pratiques
- Laissez
migrateactif sauf besoin précis, et jamais sans règles d’allocation manuelles. - Préférez les rôles de nœuds aux attributs personnalisés.
- Testez toute migration en
dry_runavant de l’exécuter. - Alertez sur l’âge des index par tier, pas seulement sur le statut des politiques.
Questions fréquentes
Qu’est-ce que _tier_preference ?
C’est le réglage d’index index.routing.allocation.include._tier_preference, une liste ordonnée de tiers où placer les shards. ILM le positionne via l’action migrate.
Pourquoi ma phase warm est « complete » alors que rien n’a bougé ?
Avec migrate.enabled: false et sans règle d’allocation manuelle, la documentation indique que les données peuvent ne pas atteindre le tier cible alors que la phase est marquée terminée.
Faut-il supprimer l’action allocate ?
Si elle ne contient plus que des filtres d’attributs hérités, la documentation de migration recommande de les retirer ; une action allocate vide est invalide et doit être supprimée.
Conclusion
Quand ILM ne migre pas vos index, commencez par migrate.enabled, puis par les filtres d’attributs hérités et les rôles de nœuds. Les pages officielles citées ci-dessous restent la référence pour votre version.
Sources
- Data tiers, documentation Elastic
- ILM migrate, documentation Elastic
- ILM allocate, documentation Elastic
- Migrate index allocation filters to node roles, documentation Elastic
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits appartiennent à leurs propriétaires ; les exemples sont tirés de la documentation officielle ou fictifs, à valider sur votre version.