Tu equipo usa la pila Elastic para los logs y duda si confiarle también el APM, o se plantea sustituirla: Elastic APM vs Dynatrace es la pregunta que surge en toda revisión de arquitectura. Ambos productos recopilan trazas, métricas y logs, pero se basan en decisiones muy distintas. Este artículo plantea una tabla de criterios que puedes comprobar tú mismo, sin veredicto.
Cada dato técnico de abajo procede de una página oficial (documentación de Elastic o docs.dynatrace.com), leída para la ocasión. No citamos ningún precio: las tarifas dependen del contrato y se consultan en las páginas oficiales. Es el mismo enfoque de nuestras comparativas Dynatrace vs Datadog y Dynatrace vs New Relic. Del lado de Dynatrace se trata de la plataforma SaaS; Managed se indica cuando importa.
Elastic APM vs Dynatrace: las diferencias de fondo
Elastic describe su APM como un sistema «construido sobre la Elastic Stack»: mide los tiempos de respuesta de las peticiones, de las llamadas a bases de datos y de las llamadas HTTP externas, y agrupa los errores por traza de pila. Dynatrace se basa en OneAgent, un agente único por host que descubre los procesos y activa la instrumentación de la pila de aplicaciones. La tabla resume los puntos documentados.
| Criterio | Elastic APM | Dynatrace |
|---|---|---|
| Recopilación | Agentes por lenguaje, o SDK y Collector EDOT (distribuciones de OpenTelemetry de Elastic) | OneAgent (instrumentación automática) u OTLP, a elegir servicio por servicio |
| OpenTelemetry | Punto de entrada OTLP gestionado (Serverless y Elastic Cloud Hosted), datos almacenados en formato OTel; la entrada OTLP de APM Server traduce a ECS y ya no se recomienda para proyectos nuevos | API OTLP directa en OTLP/HTTP, o mediante un Collector (estándar, Dynatrace o Bindplane); trazas, métricas y logs |
| Lenguaje de consulta | ES|QL, lenguaje con pipes; Query DSL | DQL sobre el almacenamiento Grail |
| Análisis de causa | Agrupación de errores por traza de pila; otras funciones, por verificar en tu edición | Análisis de causa raíz con IA causal sobre una topología causal; agrupa las anomalías relacionadas en un problema |
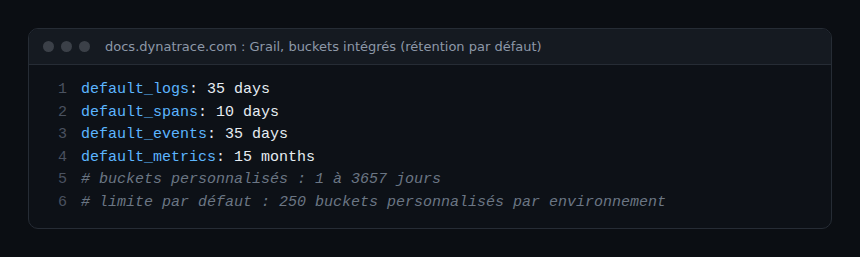
| Retención | Políticas ILM (fases hot, warm, cold, frozen, delete); ciclo de vida de los flujos de datos en Serverless | Buckets de Grail: 35 días (logs), 10 días (spans), 15 meses (métricas) por defecto; buckets personalizados de 1 a 3657 días |
| Alojamiento | Serverless, Cloud Hosted, ECK, ECE o autogestionado | SaaS, o Managed en tu infraestructura |
| Modelo de facturación | Observability Serverless: GB ingeridos y datos almacenados, contabilizados por separado | Dynatrace Platform Subscription: capacidades modulares, con ingesta, retención y consultas facturadas por separado para logs, trazas, eventos y métricas |
Sobre la retención, las duraciones de Dynatrace indicadas arriba son las de la documentación de Grail; los buckets integrados no se pueden modificar.
Instrumentación: agente propietario u OpenTelemetry
Para un equipo de plataforma, la primera cuestión es el esfuerzo de puesta en marcha. Con OneAgent, la documentación de Dynatrace indica que una sola instancia por host descubre todos los procesos e instrumenta automáticamente los componentes nuevos. Funciona en las grandes nubes, Kubernetes, Docker y varios sistemas, entre ellos Linux y Windows.
Del lado de Elastic, la página de APM recomienda ahora Elastic OpenTelemetry para recopilar la telemetría de las aplicaciones. Las EDOT incluyen un Collector personalizado y SDK (.NET, Java, Node.js, PHP, Python, Android, iOS; Browser en versión preliminar técnica). A partir de la versión 9.5, la capacidad del Collector EDOT está integrada en Elastic Agent. Detallamos este camino en el artículo sobre Elastic Agent y el Collector de OpenTelemetry y en el dedicado a OTLP y APM Server.
Un punto que cuenta en ambos sentidos. Elastic precisa que las herramientas contrib del Collector upstream cuentan con el apoyo de la comunidad: el proveedor no puede ofrecer soporte de implementación y la instalación automática del contenido de OpenTelemetry no tiene lugar. Dynatrace, por su parte, precisa que los SDK de OpenTelemetry no ofrecen las funciones propias del RUM (sesiones, acciones de usuario, Core Web Vitals, Session Replay); para web y móvil recomienda el JavaScript RUM y OneAgent for Mobile. En ambos casos, OpenTelemetry sigue siendo útil como base portable, pero las funciones más completas pasan por la vía propia del proveedor.
Consultas y exploración de los datos
Las dos plataformas ofrecen un lenguaje con pipes. ES|QL se describe como «un lenguaje con pipes para filtrar, transformar y analizar» los datos de Elasticsearch, con comandos como FROM, SORT y LIMIT. DQL explora los datos almacenados en Grail (logs, métricas, trazas, eventos) sin esquema predefinido, según la documentación. Para una misma pregunta, compara la legibilidad y el tiempo de escritura.
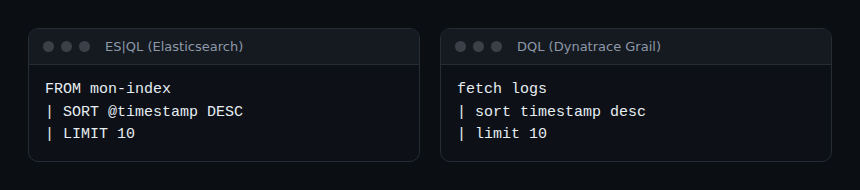
Estos dos ejemplos son nuestros, escritos con los comandos que citan las documentaciones; adapta el nombre del índice o la fuente a tu entorno.
Retención y operación
Suele ser aquí donde los equipos notan la diferencia en el día a día. Con Elasticsearch, la retención se gestiona con políticas ILM: eliges cuándo un índice pasa de hot a warm, cold o frozen, y cuándo la fase delete lo elimina. La documentación precisa que ILM no está disponible en Elasticsearch Serverless, donde toma el relevo el ciclo de vida de los flujos de datos. Es mucha libertad, con la carga de ajuste que conlleva; para el coste de los niveles fríos, consulta nuestro artículo sobre el frozen tier.
Con Dynatrace SaaS, la retención se ajusta por bucket de Grail. Reducir el periodo de un bucket elimina de forma definitiva los datos más antiguos, y esa eliminación puede tardar hasta unos días. Los buckets integrados tienen una duración fija; hay que crear un bucket personalizado para elegirla.
En cuanto al alojamiento, Elastic enumera cinco opciones, desde Serverless (operado por Elastic) hasta el autogestionado, donde tienes «el control total y la responsabilidad» del despliegue. Dynatrace Managed se instala en tu infraestructura: instalas y configuras el clúster, con alta disponibilidad y autosupervisión documentadas. Si la soberanía exige el autoalojamiento, ambas familias lo permiten; el esfuerzo de operación hay que cuantificarlo.
Coste total de propiedad: lo que dice la documentación
No comparamos precios: las unidades difieren y cualquier cifra sin tu volumen sería engañosa. Estima con tus propios volúmenes y pide una oferta escrita y fechada.
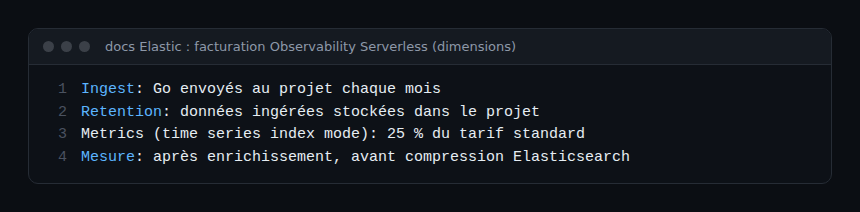
En Elastic Observability Serverless, la ingesta se factura por los GB enviados cada mes, la retención por los datos almacenados, y las métricas en modo time series se cuentan al 25 % de la tarifa estándar. Los volúmenes se miden tras el enriquecimiento y antes de la compresión, por lo que pueden superar el tamaño de índice que muestra Elasticsearch. Dynatrace modela su oferta en capacidades; para logs, trazas, eventos y métricas, la ingesta, la retención y la consulta son tres líneas distintas.
Cómo llevar a cabo la comparación en la práctica
- Elige tres servicios representativos (un monolito, una API, un job asíncrono) y fija la tabla antes de empezar.
- Envía los mismos datos OTLP a las dos plataformas con un Collector que duplique los flujos, como en el despliegue del Collector en Kubernetes.
- Cronometra tres averías provocadas (latencia de una dependencia, OOMKilled, error 500 tras un despliegue) hasta dar con la causa.
- Escribe la misma consulta en ES|QL y en DQL y anota la legibilidad.
- Cuenta las horas de operación: actualizaciones de versión, ajuste de la retención, soporte.
- Proyecta la factura a tres años a partir de ofertas escritas.
Cómo comprobar que la comparación es justa
- Los volúmenes de spans recibidos son comparables en ambos lados durante el mismo periodo; si no, revisa el muestreo (consulta el tail sampling).
- La retención probada es equivalente: un bucket de spans a 10 días no es comparable con un índice conservado 30 días.
- Las mismas personas de guardia prueban las dos herramientas, sin conocer el escenario.
Buenas prácticas
- Mantén OpenTelemetry como base de instrumentación: la elección de la plataforma sigue siendo reversible. Para el contexto, lee observabilidad y monitorización.
- Respalda cada criterio con la documentación y fecha la lectura.
- Redacta un informe blameless: qué funcionó, qué se atascó, sin señalar a ningún perdedor.
Preguntas frecuentes
¿Elastic APM acepta OpenTelemetry de forma nativa?
Según la documentación de Elastic, existe un punto de entrada OTLP gestionado en Serverless y Elastic Cloud Hosted, con almacenamiento en formato OTel. La entrada OTLP de APM Server, más antigua, traduce los datos a ECS. Comprueba la vía que corresponde a tu despliegue.
¿Dynatrace conserva las trazas tanto tiempo como Elasticsearch?
Por defecto, el bucket integrado de spans guarda 10 días, según la documentación de Grail; un bucket personalizado puede ir de 1 a 3657 días. En Elastic, la duración depende de tu política ILM o de tu ciclo de vida. Compara a igual duración.
¿Se pueden mantener las dos herramientas?
Técnicamente sí, con un Collector que duplique los flujos. Eso sí, duplica el esfuerzo de operación; es más razonable como transición que como destino.
Conclusión
Elastic APM y Dynatrace responden a necesidades parecidas con filosofías distintas: una pila modulable que tú ajustas, o una plataforma que automatiza más. La elección acertada depende de tu contexto, de tus volúmenes y de tus restricciones de alojamiento, no de una clasificación. Una tabla fijada de antemano, los mismos datos OTLP y ofertas por escrito dan una decisión defendible.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace y Elastic son marcas de sus respectivos propietarios. Las funcionalidades evolucionan: compruébalas en la documentación oficial (Dynatrace, Elastic APM). Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.