Un snapshot Elasticsearch est une sauvegarde, mais un index monté en snapshot consultable n’en est pas une : les deux mots désignent le même objet dans le dépôt, avec des rôles opposés. Cette confusion, fréquente dans les politiques ILM, est le sujet de ce guide, écrit d’après la documentation Elastic consultée le 30 octobre 2026.
L’objectif : savoir quand on restaure et quand on monte, ce que chaque opération laisse dans le cluster, et comment sauvegarder un cluster qui contient déjà des snapshots consultables. Le coût du frozen tier est traité dans /?s=elasticsearch+frozen+tier+cout+snapshots et la suppression par ILM dans /?s=ilm+delete+searchable+snapshot+supprime+snapshots : je ne les reprends pas ici. Les snapshots consultables demandent une licence Enterprise, selon la documentation Elastic.
Snapshot Elasticsearch : sauvegarde ou index consultable ?
La page « Snapshot and restore » le dit sans détour : un snapshot est une sauvegarde d’un cluster en fonctionnement, stockée dans un dépôt hors du cluster. Par défaut il contient l’état du cluster, les data streams et les index ordinaires (index ouverts seulement), y compris les politiques ILM et les modèles d’index. Il sert à récupérer des données après une suppression ou une panne matérielle, ou à les déplacer vers un autre cluster. Copier les répertoires de données des nœuds n’est pas une méthode de sauvegarde prise en charge.
Un snapshot consultable utilise le même mécanisme de stockage, mais l’usage change. L’index est « monté » : ses données restent dans le dépôt et le cluster les lit à la demande. D’après la page des snapshots consultables, le dépôt contient alors l’unique copie complète des données ; le cache local est incomplet et ne permet pas la récupération.
En bref
- Restaurer copie les données dans le cluster ; monter les laisse dans le dépôt et les lit à la demande.
- Un index monté n’a pas de réplicas par défaut : selon Elastic, « le snapshot sous-jacent assure la résilience ».
- Pour sauvegarder un cluster qui contient des index consultables, Elastic recommande des snapshots ordinaires, qui ne stockent que des métadonnées pointant vers le snapshot d’origine.
- Le dépôt d’origine doit rester enregistré et accessible pour restaurer ces index.
Restaurer ou monter : ce que chaque opération fait
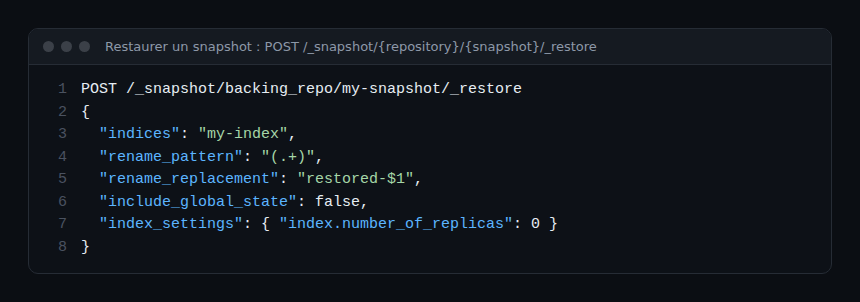
La restauration passe par l’API POST /_snapshot/{repository}/{snapshot}/_restore. Le corps accepte notamment indices, rename_pattern et rename_replacement pour renommer, include_global_state et index_settings pour surcharger des réglages comme le nombre de réplicas. La documentation précise qu’on ne peut pas restaurer un index ouvert existant, y compris les index de support d’un data stream : il faut le supprimer ou renommer la copie restaurée.
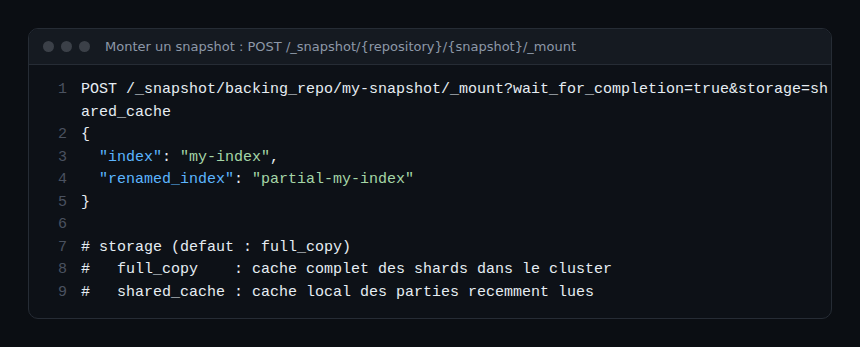
Le montage passe par POST /_snapshot/{repository}/{snapshot}/_mount. Dans la référence de l’API, le champ index est obligatoire, renamed_index donne un autre nom, et storage choisit le mode : full_copy (valeur par défaut) ou shared_cache. wait_for_completion vaut false par défaut.
Point de vocabulaire utile : si vous restaurez un snapshot qui contient des index consultables, ils reviennent comme index consultables, et leurs données viennent toujours du dépôt d’origine. Restaurer ne les « rapatrie » donc pas.
Montage complet ou partiel : où vivent vos données
Selon la documentation, un index monté entièrement (full_copy) garde en cache tous ses shards dans le cluster, avec des performances normalement comparables à un index ordinaire ; il correspond aux phases hot et cold et au préfixe restored-. Un index monté partiellement (shared_cache) ne garde que les données récemment lues ; il correspond à la phase frozen et au préfixe partial-. Les lectures hors cache vont chercher les données dans le dépôt.
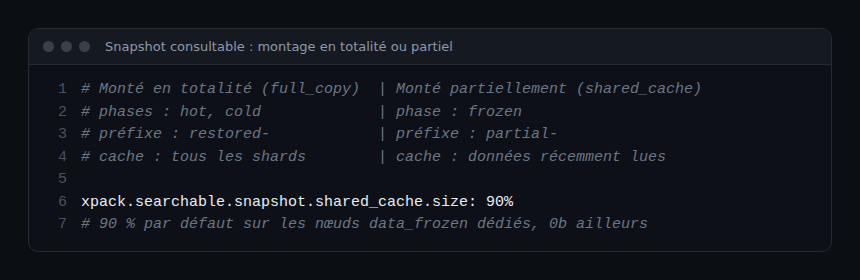
Deux conséquences pour l’exploitation. Le cache partiel est vidé au redémarrage d’un nœud ; les données d’un montage complet restent sur disque. Et le réglage xpack.searchable.snapshot.shared_cache.size vaut 90 % du disque sur des nœuds data_frozen dédiés, 0b ailleurs. Si un nœud tombe, les shards sont reconstruits depuis le dépôt : la santé du cluster peut rester différente de green un moment, et les recherches peuvent échouer ou renvoyer des résultats partiels.
Sauvegarder un cluster qui contient des snapshots consultables
Voici la marche à suivre, d’après la section « Backups » de la page des snapshots consultables.
- Prenez des snapshots ordinaires du cluster, par exemple avec SLM, comme pour tout autre cluster.
- Gardez en tête ce que ces snapshots contiennent : pour un index consultable, uniquement des métadonnées qui renvoient au snapshot d’origine, « aucune donnée » de l’index.
- Avant une restauration, enregistrez le dépôt d’origine : la restauration échoue pour tout index consultable dont le snapshot d’origine n’est plus disponible.
- Ne comptez pas sur un dépôt « source only » : il ne peut pas contenir de snapshot d’index consultable.
La conséquence est contre-intuitive : la sauvegarde de vos index froids dépend de la survie du dépôt qui les sert. Si ce dépôt est corrompu, Elastic avertit que la perte de données peut être définitive. Pour une exigence de conservation, la protection du dépôt (copie, droits d’écriture, séparation des clusters) fait partie de la conception. Un cluster tiers qui peut écrire dans ce dépôt ne doit pas y supprimer ces snapshots.
Éviter les montages manuels sous ILM
La documentation déconseille de monter à la main des snapshots gérés par ILM : cela peut interférer avec lui et causer une perte de données ou des problèmes de gestion des snapshots. Si vous voulez interroger ponctuellement une ancienne donnée, préférez une restauration sous un autre nom, avec rename_replacement, plutôt qu’un montage d’un snapshot que ILM pilote.
Comment vérifier que ça fonctionne
Sur un index de test, montez un snapshot avec storage=shared_cache, puis lancez GET /_cat/indices/partial-* pour contrôler le préfixe. Restaurez ensuite le même snapshot avec rename_replacement et comparez le comportement. Notez que cette vérification dépend de la version de votre cluster : la page consultée ne fixe pas de version précise, relisez la doc correspondant à la vôtre.
Côté OpenTelemetry et Dynatrace
Pour suivre l’état d’un cluster Elasticsearch, le Collector OpenTelemetry peut collecter des métriques ; voir https://span.observer/fr/collector-opentelemetry-kubernetes-dynatrace/. Je n’ai pas trouvé, dans les pages lues, d’intégration Dynatrace propre aux snapshots Elasticsearch, et je n’en affirme aucune. La différence entre surveiller un état et comprendre une panne est abordée dans https://span.observer/fr/observabilite-vs-monitoring-difference/, et la comparaison des plateformes dans https://span.observer/fr/dynatrace-vs-datadog-comparatif-sre/.
Questions fréquentes
Un snapshot consultable remplace-t-il une sauvegarde ?
Non. D’après la documentation Elastic, le snapshot monté contient l’unique copie complète des données de l’index. Sauvegardez le cluster avec des snapshots ordinaires et protégez le dépôt.
Quelle est la différence entre restaurer et monter ?
Monter rend l’index interrogeable depuis le dépôt, avec un cache ; ILM le fait en général automatiquement. Restaurer un snapshot qui contient des index consultables les ramène comme index consultables, toujours adossés au dépôt d’origine.
Quelle valeur de storage choisir ?
full_copy est la valeur par défaut de l’API de montage et met en cache tous les shards ; shared_cache ne garde que les données récentes, et convient à la phase frozen, selon la documentation.
Conclusion
Retenez une distinction : un snapshot ordinaire sauvegarde, un snapshot monté sert de stockage. Documentez, pour chaque index, lequel des deux vous avez, et gardez le dépôt d’origine enregistré et protégé.
Blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les comportements décrits proviennent de la documentation Elastic consultée le 30 octobre 2026 ; vérifiez-les dans la version de votre cluster.