L’empoisonnement d’outils MCP vise un angle mort : le texte que le modèle lit avant même d’agir. Quand un agent se connecte à un serveur MCP, il récupère la liste des outils avec leur nom, leur description et leur schéma d’arguments. Le modèle lit ces descriptions comme des consignes. Un serveur malveillant ou compromis peut y cacher des instructions : lire un fichier de clés, appeler l’outil d’un autre serveur avec d’autres paramètres, ou taire une action à l’utilisateur.
Le problème pour une équipe d’exploitation est que rien ne « tombe en panne ». Pas d’erreur 500, pas de pic de latence : l’agent fait simplement autre chose que ce qu’on attend. Seules la télémétrie et une comparaison avec un état connu permettent de le voir.
Ce guide traite la détection : quels signaux surveiller dans les traces et les logs, comment calculer une empreinte du catalogue d’outils, et comment alerter dans Dynatrace SaaS ou Dynatrace Managed. Les mesures de durcissement générales sont dans notre guide pour sécuriser un serveur MCP.
Empoisonnement d’outils MCP : tool poisoning, line jumping et rug pull
Le guide de sécurité des serveurs locaux de modelcontextprotocol.io décrit le « catalogue d’outils empoisonné » : les noms et descriptions d’outils sont des instructions que le modèle lit, et un serveur peut y glisser des directives qui orientent l’agent, y compris sur l’usage des outils d’autres serveurs, sans que l’outil piégé soit jamais appelé. On parle de tool poisoning, et de tool shadowing quand la cible est l’outil d’un autre serveur. Le même guide décrit le rug pull : un serveur modifie ses définitions après que vous les avez approuvées.
Trail of Bits a nommé line jumping la forme la plus directe : l’attaque passe dès la réponse à tools/list, avant toute invocation d’outil, puisque le client ajoute ces descriptions au contexte du modèle.
La spécification MCP pose deux règles utiles ici. Les clients doivent (MUST) considérer les annotations d’outils comme non fiables, sauf si elles viennent d’un serveur de confiance. Et un serveur qui déclare la capacité listChanged devrait (SHOULD) envoyer la notification notifications/tools/list_changed quand sa liste d’outils change. Un rug pull honnête laisse donc une trace ; un serveur malveillant peut s’en dispenser, d’où l’intérêt de comparer le catalogue lui-même.
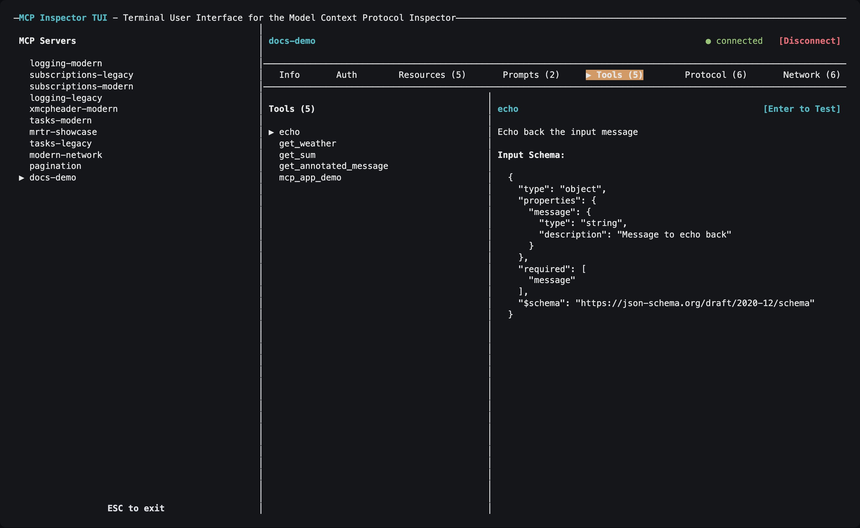
Première défense, la plus simple : lire les descriptions sans modèle dans la boucle. MCP Inspector affiche chaque outil, sa description et son schéma d’entrée. Une description qui parle d’autre chose que de la fonction de l’outil est un signal d’alerte.
Ce que les traces et les logs peuvent voir
Les conventions sémantiques OpenTelemetry pour MCP (statut Development, désormais maintenues dans le dépôt semantic-conventions-genai) donnent un vocabulaire commun aux spans :
mcp.method.name: la méthode, par exempletools/list,tools/callounotifications/tools/list_changed;gen_ai.tool.nameetgen_ai.operation.name=execute_toolpour les appels d’outils ;error.type=tool_errorquand le résultat revient avecisErroràtrue;gen_ai.tool.call.argumentsetgen_ai.tool.call.result, en option (opt-in), car ils peuvent contenir des données sensibles ;gen_ai.tool.description, recommandé sur les spansexecute_tool, avec le même avertissement.
Avec ces attributs, trois signaux deviennent observables : un catalogue qui change, un outil jamais vu qui apparaît dans les appels, et une séquence d’appels anormale (un outil d’écriture appelé juste après la lecture d’un contenu externe). La mise en place des spans est détaillée dans notre guide pour observer les agents MCP avec OpenTelemetry.
Détecter l’empoisonnement en trois signaux
Signal 1 : l’empreinte du catalogue d’outils
Le principe est celui d’un contrôle d’intégrité : on calcule une empreinte des définitions approuvées, puis on la recalcule à intervalle régulier. La CLI de MCP Inspector interroge un serveur sans modèle dans la boucle. Voici une exécution réelle sur le serveur de référence filesystem :
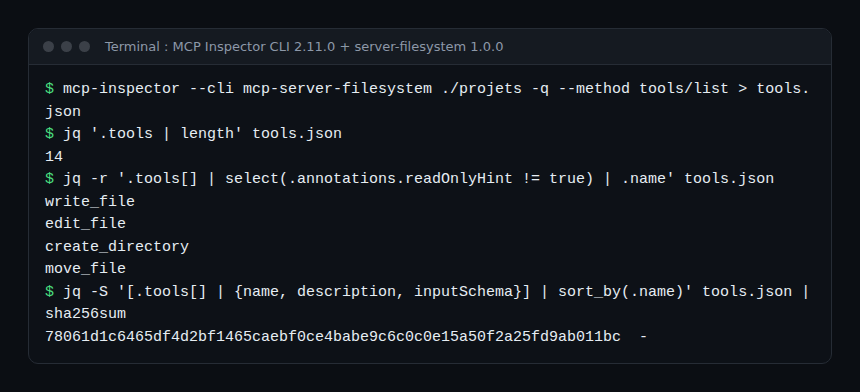
Le calcul ne garde que ce que lit le modèle (nom, description, schéma d’entrée), trié par nom pour que l’ordre de la réponse ne change pas l’empreinte. Le script de contrôle complet, à lancer en tâche planifiée sur une machine d’administration :
#!/usr/bin/env bash
# controle-catalogue.sh SERVEUR COMMANDE...
set -euo pipefail
nom="$1"; shift
ref="/var/lib/mcp-catalogue/$nom.sha256"

mcp-inspector --cli "$@" -q --method tools/list > "/tmp/$nom-tools.json"
empreinte=$(jq -S '[.tools[] | {name, description, inputSchema}] | sort_by(.name)' \
  "/tmp/$nom-tools.json" | sha256sum | cut -d' ' -f1)

# Motifs suspects dans les descriptions : balises d'instruction, chemins de secrets, séquences ANSI
suspects=$(jq -r '.tools[] | select((.description // "") | test("<important>|ignore|\\.ssh|id_rsa|\u001b"; "i")) | .name' \
  "/tmp/$nom-tools.json")

if [ "$empreinte" != "$(cat "$ref")" ] || [ -n "$suspects" ]; then
  jq -n --arg s "$nom" --arg e "$empreinte" --arg o "$suspects" \
    '[{content: ("Catalogue MCP modifie ou suspect : " + $s), severity: "warn",
       "log.source": "mcp-catalogue", "mcp.catalogue.server": $s,
       "mcp.catalogue.sha256": $e, "mcp.catalogue.suspects": $o}]' |
  curl -sf -X POST "https://<env-id>.live.dynatrace.com/api/v2/logs/ingest" \
    -H "Content-Type: application/json; charset=utf-8" \
    -H "Authorization: Api-Token $DT_API_TOKEN" -d @-
fi
Les lignes critiques : -q réduit la sortie de la CLI au résultat ; le filtre test() recherche des motifs typiques d’injection, dont le caractère d’échappement ANSI (\u001b) qui peut masquer du texte dans un terminal ; l’envoi passe par la Log ingestion API avec un jeton au scope logs.ingest. En Managed, l’URL devient https://<votre-domaine>/e/<env-id>/api/v2/logs/ingest. Les attributs mcp.catalogue.* sont un choix de nommage local, pas une convention.
Initialisez la référence après relecture humaine des descriptions, et ne la mettez à jour qu’après une nouvelle relecture : c’est l’équivalent d’une revue de dépendance.
Signal 2 : les notifications de changement de liste
Si votre client ou une passerelle MCP produit des spans selon les conventions, une notification notifications/tools/list_changed en production mérite une vérification. Dans Dynatrace SaaS :
fetch spans, from: now() - 24h
| filter mcp.method.name == "notifications/tools/list_changed"
| summarize notifications = count(), by: { service.name }
Signal 3 : un outil jamais vu ou une erreur d’outil
Un outil apparu récemment dans les appels, sans changement de catalogue approuvé, est suspect :
fetch spans, from: now() - 7d
| filter mcp.method.name == "tools/call"
| summarize premier_appel = min(start_time), appels = count(), by: { gen_ai.tool.name }
| filter premier_appel > now() - 24h
Ajoutez une vue des appels en échec (error.type == "tool_error") par outil : un outil empoisonné qui tente d’accéder à un fichier interdit produit souvent des erreurs avant de réussir.
Alerter dans Dynatrace SaaS et Managed
Dynatrace SaaS. Dans Settings > Analyze and alert > Alerts > All alerts > Custom alerts, onglet Advanced, choisissez le type de données Records et la requête :
fetch logs
| filter log.source == "mcp-catalogue"
Chaque enregistrement correspondant déclenche une alerte. Pour les signaux 2 et 3, une alerte de type Timeseries sur un makeTimeseries count() fonctionne aussi ; la documentation recommande interval: 1m. La méthode complète est dans notre guide pour créer une alerte Dynatrace.
Dynatrace Managed. Les requêtes DQL sur les spans demandent Grail et ne s’appliquent pas. Le signal 1 fonctionne tel quel : la Log ingestion API existe en Managed, et un log event (Settings > Log Monitoring > Events extraction) dont le Matcher filtre sur la source mcp-catalogue crée un événement, voire un problème.
Bloquer, pas seulement détecter
La détection a un délai. Pour les serveurs tiers, ajoutez un contrôle en ligne. Le projet open source mcp-context-protector de Trail of Bits enveloppe un serveur MCP et associe chaque risque à un contrôle :
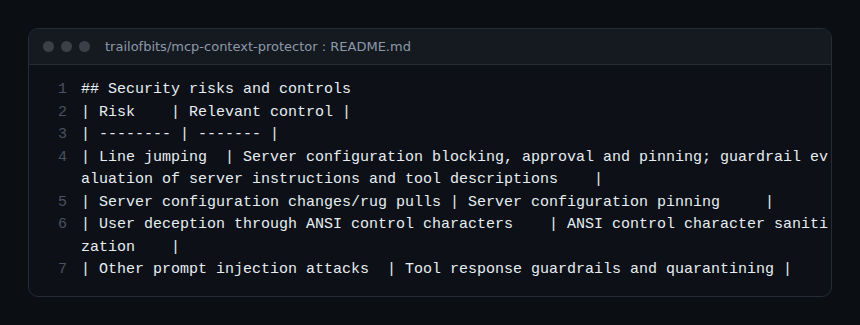
Son README décrit un épinglage à la première utilisation : instructions du serveur, descriptions et schémas d’outils sont comparés à une configuration approuvée, vérifiés à la connexion puis à chaque notifications/tools/list_changed, et tout écart bloque les appels jusqu’à une nouvelle approbation. Le projet se présente comme un wrapper ; testez-le avant de l’imposer.
Comment vérifier que ça fonctionne
- Sur un serveur de test, modifiez une description d’outil : le script doit envoyer un log, visible avec
fetch logs | filter log.source == "mcp-catalogue". - Ajoutez la chaîne
<IMPORTANT>dans une description : le champmcp.catalogue.suspectsdoit nommer l’outil. - Vérifiez que l’alerte personnalisée ou le log event a bien créé un événement.
Bonnes pratiques
- Relire les descriptions avant d’approuver un serveur, comme une dépendance.
- Épingler les définitions et préférer les clients qui redemandent l’accord quand elles changent.
- Garder peu de serveurs : tous partagent le contexte du modèle.
- N’activer les arguments d’outils dans les spans qu’avec un masquage des données sensibles.
- Séparer lecture et action : un agent qui lit des contenus externes ne devrait pas disposer d’outils d’écriture sans validation humaine.
Questions fréquentes
Un antivirus ou un scanner de dépendances détecte-t-il l’empoisonnement d’outils MCP ?
Rarement : la charge est du texte en langage naturel, pas du code. Il faut contrôler les descriptions elles-mêmes, et leur évolution dans le temps.
L’empreinte détecte-t-elle un serveur qui change de réponse selon le client ?
Pas forcément : un serveur peut servir une liste différente à votre contrôle et à l’agent. D’où l’intérêt des signaux 2 et 3, observés sur le trafic réel.
Faut-il enregistrer les arguments d’outils dans les traces ?
Les conventions les classent en option, avec un avertissement sur les données sensibles. Activez-les pour une enquête ou sur un périmètre limité, avec un masquage en amont.
Conclusion
L’empoisonnement d’outils MCP ne déclenche aucune alerte classique : il faut le chercher. Une empreinte du catalogue, des spans conformes aux conventions OpenTelemetry et une alerte Dynatrace sur les écarts couvrent l’essentiel. Complétez avec l’isolation des serveurs locaux, détaillée dans notre guide sur les serveurs MCP STDIO.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Dynatrace est une marque de Dynatrace LLC. Sources : guide de sécurité des serveurs MCP locaux, conventions sémantiques OpenTelemetry pour MCP ; les attributs évoluent, vérifiez-les avant de construire vos requêtes.