
Abres un nodo Linux reciente para buscar un error y ya no hay ningún fichero que leer: todo pasa por systemd. Los logs de journald se quedan en la máquina, en formato binario, y desaparecen con ella si nadie los centraliza. Este artículo parte de esa decisión de operación: quién recoge el journal, con qué regla y cómo asegurarte de que las líneas llegan de verdad a Dynatrace.
El escenario es Dynatrace SaaS con OneAgent. He leído la documentación SaaS vigente sobre la recogida de Journald y la página de feature flags del módulo de logs, actualizadas en 2026. No he montado la cadena completa para este artículo: las capturas reproducen extractos de la documentación, y lo que no he podido comprobar lo digo en el texto.
Para una visión general de la ingesta, empieza por la ingesta de logs: resiliencia y autoservicio. Aquí tratamos un único caso, el journal de systemd.
El problema: un journal local no se centraliza solo
journald guarda sus entradas en ficheros binarios comprimidos, en /var/log/journal/ cuando el almacenamiento es persistente. Él mismo gestiona el tamaño, la rotación y la retención. En local es cómodo, con journalctl; pero nada lo envía a otro sitio sin un componente adicional.
Para quien está de guardia, la consecuencia es directa. Un nodo que se cae o que se sustituye se lleva sus logs de sistema. Un incidente que afecta a diez máquinas obliga a abrir diez sesiones SSH, y el tiempo de diagnóstico (MTTR) acaba dependiendo del número de máquinas, no de la gravedad del problema.
Logs de journald: tres formas de sacarlos del nodo
Antes de configurar nada, elige entre tres enfoques:
- Un agente de terceros o un reenvío syslog. Conservas tus herramientas, pero te toca mantener el parseo de la gravedad y de las unidades. Dynatrace documenta también una ingesta syslog, que es otro proyecto.
- El módulo de logs de OneAgent. Lee el journal a través de la API de systemd, sin seguir ficheros a mano. Es la opción de este artículo.
- La API de ingesta. Útil para fuentes que ningún agente cubre, pero el envío tienes que escribirlo tú.
Si OneAgent ya corre en tus hosts, la segunda opción te ahorra un componente más. La entrada del fabricante (How to observe logs with Journald and Dynatrace, abril de 2025, actualizada en junio de 2026) la presenta como válida para Dynatrace SaaS y para Dynatrace Managed. No he encontrado una página equivalente para Managed en la documentación: en Managed, comprueba el procedimiento antes de aplicarlo.
Cómo lee OneAgent el journal
Según la documentación, el módulo de logs abre la biblioteca libsystemd.so y actúa como un cliente más de journald. Lee las entradas una a una y recuerda su posición. No hay ninguna ruta fija: el módulo abre la ubicación por defecto del contexto de journald.
Cada entrada se convierte en atributos:
- el campo
MESSAGEpasa a ser el contenido del log; - el campo
UNIT(o, en su defecto,SYSTEMD_UNIT) alimenta el atributoJournald.unit, y la documentación aclara que a veces no está presente ninguno de los dos; - el campo
PRIORITYda la gravedad,LogEntryLevel.
Esta última correspondencia merece un vistazo, porque de ella dependen tus alertas.
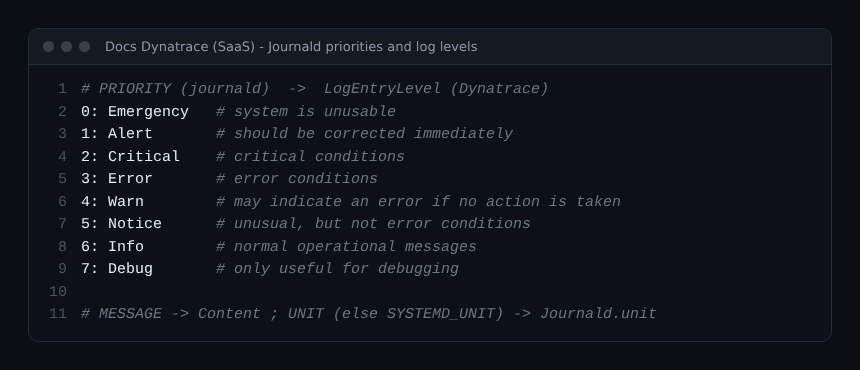
Una alerta de errores debe cubrir las prioridades 0 a 3, no solo la 3. Si lo que quieres es filtrar ruido, mira cómo reducir el ruido de las alertas sobre logs.
Pasos para activar la recogida de logs de journald
Requisitos: un OneAgent 1.307 o superior en un host Linux con systemd, y permiso para cambiar los ajustes del tenant. La documentación exige dos ajustes distintos, y ahí es donde se suele fallar.
- Activa el detector. En los feature flags del módulo de logs, marca «Enable Journald log detector». Viene activado por defecto en los tenants nuevos; los tenants existentes tienen que activarlo ellos. Sin él, la documentación avisa de que los logs no aparecen, ni siquiera con reglas de ingesta.
- Activa una regla de ingesta. La regla integrada «[Built-in] Ingest Journald logs» ingiere todos los logs de journald. En una cuenta nueva ya viene activa.
- O apunta a una unidad. Crea una regla con dos matchers: el atributo «Journald Unit» con un valor como
kubelet.servicey, después, el atributo «Log source» con el valor «Journald».
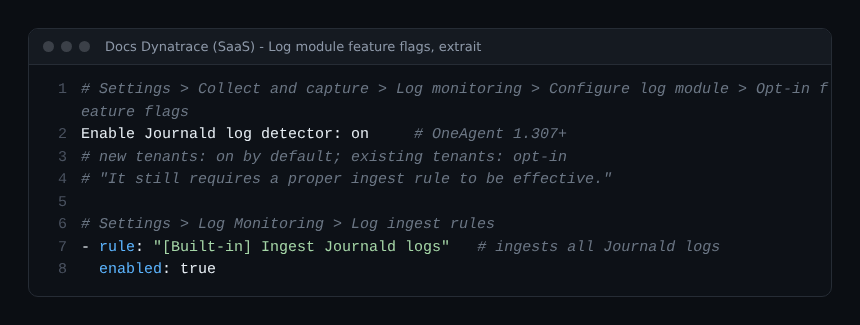
Un detalle de navegación: la página de feature flags sitúa este ajuste en «Collect and capture > Log monitoring», mientras que la página de Journald sigue escribiendo «Settings > Log Monitoring». Son páginas de épocas distintas de la documentación. Sigue el menú que veas en tu tenant.
Apuntar a una unidad en lugar de ingerirlo todo
La regla integrada es sencilla, pero ingiere todo el journal. En un nodo de Kubernetes o en un servidor con carga, eso incluye unidades muy habladoras, y el volumen se paga en ingesta, como detalla el coste de los logs: ingesta, retención y consulta.
Un orden razonable, en tres tiempos:
- Empieza con la regla integrada en un único host de pruebas, para ver qué llega.
- Haz la lista de unidades que le sirven a quien está de guardia: por ejemplo
kubelet.service,sshd.serviceo la unidad de tu aplicación. - Sustituye la regla global por una regla por unidad, siguiendo el modelo de abajo.
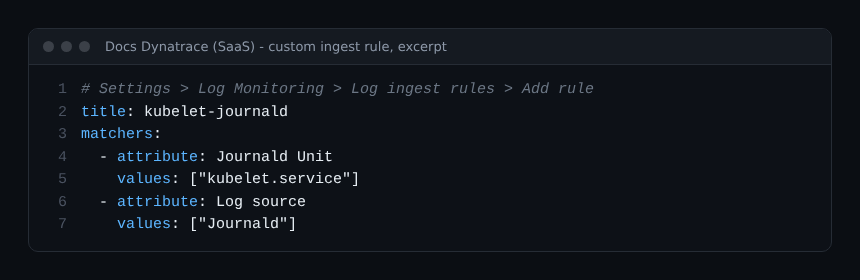
El nombre de regla kubelet-journald es un ejemplo mío, no un valor obligatorio. No he medido cuánto volumen se reduce con este filtrado en un parque real: mídelo en el tuyo antes de prometerlo.
Cómo comprobar que funciona
En el host, genera una línea cuyo texto conozcas, por ejemplo con logger -p user.err "test journald dynatrace". Entra en el journal con prioridad 3. Después búscala en Dynatrace, en la aplicación Logs o con una consulta DQL:
fetch logs, from:now() - 15m
| filter contains(content, "test journald dynatrace")
| limit 20
Si la línea no aparece, revisa por este orden: la versión de OneAgent, el detector de Journald, la regla de ingesta y, por último, que la entrada tenga una unidad o un identificador. Aquí no he comprobado el nombre exacto del atributo que lleva la fuente en Grail: no escribas un filtro sobre él sin haberlo visto en un registro real. Para profundizar en DQL, mira las consultas DQL sobre errores de logs.
Una vez en Grail, los logs pueden pasar por OpenPipeline antes de almacenarse. Es el lugar adecuado para enmascarar o enrutar: consulta cómo crear un pipeline de OpenPipeline para enrutar logs.
Buenas prácticas
- Activa el detector y la regla a la vez, y anota ambos en tu runbook.
- Pasa a una regla por unidad en cuanto la prueba inicial salga bien.
- Alerta por gravedad, no por una palabra clave frágil.
- Reserva
journalctlpara el diagnóstico local: sigue siendo útil cuando el agente está parado. - Tras cada actualización de OneAgent, verifica que los logs siguen llegando.
Preguntas frecuentes
¿Hay que configurar algo en systemd?
La documentación que he leído no pide ninguna configuración del lado de journald: OneAgent lee el journal con la biblioteca del sistema. Solo comprueba que el host use systemd.
¿Por qué no llegan mis logs de journald?
La causa más probable es un tenant antiguo en el que no se activó el detector de Journald. Sin él, según la documentación, ni una regla de ingesta correcta tiene efecto.
¿Vale este método para Dynatrace Managed?
La entrada del fabricante lo afirma. Aun así, no he encontrado una página específica de Managed: confirma el procedimiento en la documentación de tu versión antes de usarlo.
Conclusión
Centralizar los logs de journald se reduce a dos acciones y una comprobación: activar el detector, activar una regla y encontrar una línea de prueba. Después, apunta a las unidades que importan para mantener el volumen bajo control. Fuente principal: la página Log Monitoring from Journald de la documentación de Dynatrace.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.