Módulo 1 del curso de métricas de Dynatrace Managed: entender las métricas de Dynatrace Managed antes de consultarlas, es decir, saber leer una clave, sus dimensiones, su unidad, sus agregaciones y su vida útil.
Curso: Formación en métricas de Dynatrace Managed · Módulo 1/7 · Duración: ~35 min · Nivel: principiante a intermedio
Objetivos:
- Leer una clave de métrica y reconocer su prefijo (builtin:, ext:, calc:)
- Distinguir las dimensiones, la unidad y las agregaciones de una métrica
- Diferenciar los datos de tipo gauge y count
- Saber qué resolución y qué retención se aplican a las series temporales
Requisitos previos: acceso de lectura a un entorno Managed y un token de API con el scope metrics.read para el ejercicio.
Un gráfico de CPU que muestra un 40 % mientras el equipo de sistemas ve un 90 % en la máquina: una diferencia así hace perder una hora en pleno incidente. Casi siempre viene de una métrica mal leída, una media tomada por un máximo o una serie fusionada entre varios hosts. Para entender las métricas de Dynatrace Managed hay que saber qué contiene una clave y cómo agrega Dynatrace sus puntos.
Este módulo sienta esas bases. Vale para Dynatrace Managed y para las métricas llamadas «clásicas» de Dynatrace SaaS; las métricas almacenadas en Grail (claves dt.*, comando DQL timeseries) se tratan en el curso de métricas de Dynatrace SaaS.
Entender las métricas de Dynatrace Managed: anatomía de una clave
Cada métrica tiene una clave única, en minúsculas, con puntos para la jerarquía. El prefijo indica su origen:
| Prefijo | Origen | Ejemplo |
|---|---|---|
builtin: |
Métricas proporcionadas por OneAgent y la plataforma | builtin:host.cpu.usage |
ext: |
Extensiones de OneAgent o ActiveGate (y métricas clásicas de la integración con AWS) | según la extensión |
calc: |
Métricas calculadas que creas tú | módulo 7 |
uscm. / uacm. |
Métricas personalizadas de USQL (sesiones, acciones de usuario) | según tu definición |
| sin prefijo fijo | Métricas ingeridas (protocolo de ingesta) | cpu.temperature |
Lee la clave de izquierda a derecha: builtin:host.disk.avail se lee «métrica integrada, familia host, subfamilia disco, espacio disponible». La lista completa figura en la página Built-in metrics de la documentación de Managed; la llamada GET /api/v2/metrics devuelve las que realmente existen en tu entorno.
El descriptor: dimensiones, unidad, agregaciones
Cada clave tiene un descriptor, que devuelve la API Metrics v2. Este es el ejemplo que da la documentación para el espacio de disco disponible:
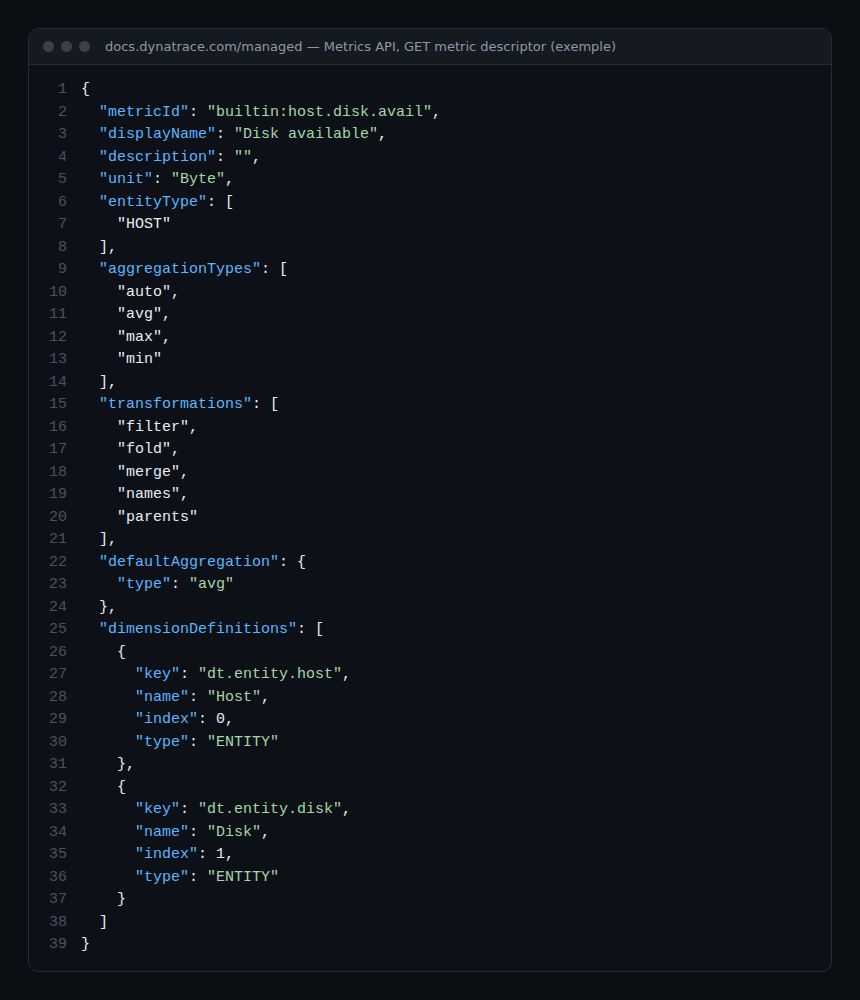
Cuatro campos merecen tu atención:
unit: aquí, bytes. Los tiempos de respuesta de servicio están en microsegundos, lo que suele sorprender la primera vez.dimensionDefinitions: el desglose de la métrica. Existe una serie por cada combinación de valores, aquí por host y por disco. La primera dimensión es una entidad, lo que permite acotar la consulta con unentitySelector.aggregationTypes: las agregaciones permitidas (auto,avg,max,miny, según la métrica,count,sum,median,percentile,value).defaultAggregation: la que se obtiene sin indicar nada, aquí la media.
Este último punto explica la diferencia del principio: sin agregación explícita, Dynatrace aplica la agregación por defecto. Una media sobre un minuto suaviza los picos que un max habría mostrado.
Gauge o count: dos naturalezas de datos
El protocolo de ingesta distingue dos formatos de puntos:
- gauge: una medida en un instante (temperatura, porcentaje de CPU, memoria usada). Un punto gauge puede llevar un resumen
min,max,sum,count. - count: un contador enviado como delta (
count,delta=500). En las métricas clásicas, Dynatrace añade entonces el sufijo.counta la clave.
En las métricas integradas, la misma lógica se lee en las agregaciones: builtin:service.requestCount.total solo acepta auto y value, es un recuento; builtin:host.cpu.usage acepta avg, max y min, es un gauge.
Resolución, rollups y retención en Managed
Las métricas de infraestructura se miden cada 10 segundos y se almacenan en agregados de un minuto (min, max, count, sum, media). La finura disponible depende después de la antigüedad del dato: Dynatrace Managed conserva las métricas 5 años, pero agrupándolas en intervalos cada vez más amplios.
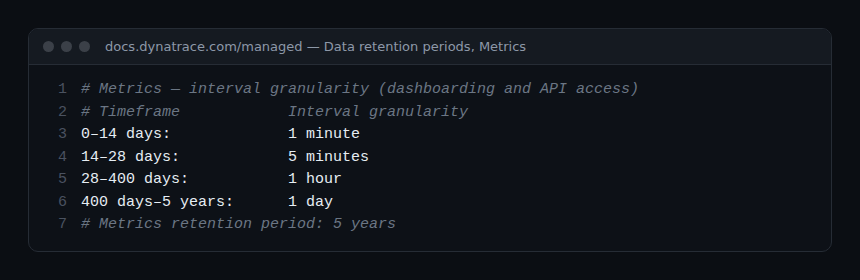
Consecuencia práctica: un pico de dos minutos ocurrido hace dos meses ya no se ve, queda diluido en una media horaria. Si un análisis posterior a un incidente necesita el minuto, hazlo dentro de los 14 días. En un clúster Managed, estas series se almacenan en el repositorio de métricas (Cassandra) y se replican en tres nodos; el artículo sobre la arquitectura de Dynatrace Managed detalla este almacenamiento.
Al consultar, el parámetro resolution de la API fija el paso: por defecto 120 puntos sobre el periodo, o un paso explícito como resolution=10m. La resolución más fina es el minuto.
Ejercicio práctico
Hazlo en un entorno de pruebas o de demostración de Managed.
Paso 1 — Listar las métricas de host de tu entorno
export DT_URL="https://{votre-domaine}/e/{id-environnement}"
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:host.*&fields=displayName,unit,aggregationTypes" \
  -H "Authorization: Api-Token $DT_TOKEN"
Resultado esperado: una lista de claves builtin:host.* con su nombre y su unidad.
Paso 2 — Leer un descriptor
curl -s "$DT_URL/api/v2/metrics/builtin:host.cpu.usage" \
  -H "Authorization: Api-Token $DT_TOKEN"
Resultado esperado: la unidad Percent, la agregación por defecto avg y la dimensión dt.entity.host.
Paso 3 — Comparar media y máximo
Consulta la misma métrica con builtin:host.cpu.usage:avg y luego con builtin:host.cpu.usage:max durante dos horas. Resultado esperado: valores máximos claramente más altos que las medias en un host con carga.
Paso 4 — Observar el efecto de la antigüedad
En el Data Explorer, muestra la misma métrica durante 7 días y luego durante 60 días. Resultado esperado: puntos más espaciados en el periodo largo, de acuerdo con la tabla de retención.
Cuestionario
- ¿Qué prefijo lleva una métrica calculada? a)
builtin:b)ext:c)calc:d)dt. - ¿Qué devuelve una consulta sin agregación explícita? a) El máximo b) La agregación por defecto del descriptor c) Todas las agregaciones d) Un error
- ¿Qué granularidad sigue disponible para una métrica de hace 3 meses? a) 1 minuto b) 5 minutos c) 1 hora d) 1 día
- ¿Cómo se envía un punto de tipo count? a) Como delta b) Como min/max c) Como porcentaje d) Como log
Soluciones
- c) Las métricas calculadas que creas llevan el prefijo
calc:. - b) Se aplica el campo
defaultAggregationdel descriptor. - c) Entre 28 y 400 días, la granularidad es de una hora.
- a) El formato count transporta la diferencia con el punto anterior.
Para ir más lejos
- Módulo 4 de la formación de Managed: explorar los datos
- API de Dynatrace Managed: endpoints y esquemas
- Dashboards de Managed: tiles y JSON
- Metrics API v2 — GET metric descriptor
Índice del curso · Módulo 2: hosts de infraestructura →
Preguntas frecuentes
¿Por qué mi gráfico de Dynatrace no coincide con top o con el Administrador de tareas?
La herramienta del sistema muestra un valor instantáneo; Dynatrace muestra por defecto una media por intervalo, y el intervalo crece con el periodo mostrado. Pide max y reduce el periodo para acercarte al valor instantáneo.
¿Se puede alargar la granularidad de un minuto más allá de 14 días?
La documentación de Managed presenta estos tramos como fijos para los dashboards y la API. Para conservar un historial fino, exporta por la API las series útiles mientras están al minuto.
¿Existen también las claves builtin: en SaaS?
Sí, como métricas clásicas. Con Grail, la mayoría tienen un equivalente dt.* que se consulta con DQL; el curso de SaaS trata esa correspondencia.
Ya sabes leer una clave, su descriptor y su granularidad. El módulo siguiente aplica esta cuadrícula a las métricas de host: CPU, memoria, disco, red y disponibilidad.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Este curso no sustituye las formaciones y certificaciones oficiales de Dynatrace University. Comprueba siempre las funcionalidades en la documentación oficial correspondiente a tu versión.