Un snapshot Elasticsearch es una copia de seguridad, pero un índice montado como snapshot buscable no lo es: las dos palabras designan el mismo objeto en el repositorio, con funciones opuestas. Esta confusión, frecuente en las políticas ILM, es el tema de esta guía, escrita a partir de la documentación de Elastic consultada el 30 de octubre de 2026.
El objetivo: saber cuándo se restaura y cuándo se monta, qué deja cada operación en el clúster y cómo hacer copias de un clúster que ya contiene snapshots buscables. El coste del frozen tier se trata en https://span.observer/es/elasticsearch-frozen-tier-coste-snapshots-es/ y el borrado por ILM en https://span.observer/es/ilm-delete-searchable-snapshot-elimina-snapshots/: no los repito aquí. Los snapshots buscables requieren una licencia Enterprise, según la documentación de Elastic.
Snapshot Elasticsearch: ¿copia de seguridad o índice buscable?
La página «Snapshot and restore» lo dice sin rodeos: un snapshot es una copia de seguridad de un clúster en funcionamiento, almacenada en un repositorio fuera del clúster. Por defecto contiene el estado del clúster, los data streams y los índices ordinarios (solo índices abiertos), incluidas las políticas ILM y las plantillas de índice. Sirve para recuperar datos tras un borrado o una avería de hardware, o para moverlos a otro clúster. Copiar los directorios de datos de los nodos no es un método de copia de seguridad admitido.
Un snapshot buscable usa el mismo mecanismo de almacenamiento, pero el uso cambia. El índice está «montado»: sus datos permanecen en el repositorio y el clúster los lee bajo demanda. Según la página de los snapshots buscables, el repositorio contiene entonces la única copia completa de los datos; la caché local es incompleta y no permite la recuperación.
En resumen
- Restaurar copia los datos en el clúster; montar los deja en el repositorio y los lee bajo demanda.
- Un índice montado no tiene réplicas por defecto: según Elastic, «el snapshot subyacente aporta la resiliencia».
- Para hacer copias de un clúster que contiene índices buscables, Elastic recomienda snapshots ordinarios, que solo almacenan metadatos que apuntan al snapshot de origen.
- El repositorio de origen debe seguir registrado y accesible para restaurar esos índices.
Restaurar o montar: qué hace cada operación
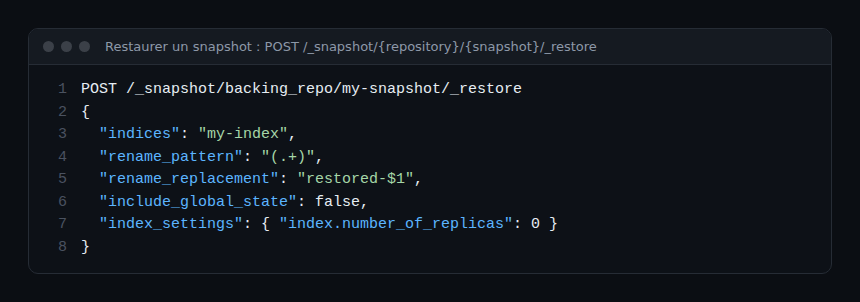
La restauración pasa por la API POST /_snapshot/{repository}/{snapshot}/_restore. El cuerpo acepta, entre otros, indices, rename_pattern y rename_replacement para renombrar, include_global_state e index_settings para sobrescribir ajustes como el número de réplicas. La documentación precisa que no se puede restaurar un índice abierto existente, incluidos los índices de respaldo de un data stream: hay que eliminarlo o renombrar la copia restaurada.
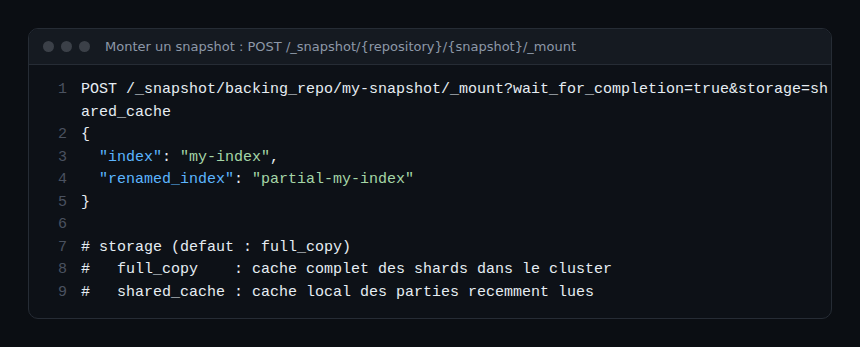
El montaje pasa por POST /_snapshot/{repository}/{snapshot}/_mount. En la referencia de la API, el campo index es obligatorio, renamed_index da otro nombre y storage elige el modo: full_copy (valor por defecto) o shared_cache. wait_for_completion vale false por defecto.
Un punto de vocabulario útil: si restauras un snapshot que contiene índices buscables, vuelven como índices buscables, y sus datos siguen viniendo del repositorio de origen. Restaurar no los «repatría».
Montaje completo o parcial: dónde viven tus datos
Según la documentación, un índice montado por completo (full_copy) mantiene en caché todos sus shards dentro del clúster, con un rendimiento normalmente comparable al de un índice ordinario; corresponde a las fases hot y cold y al prefijo restored-. Un índice montado parcialmente (shared_cache) solo conserva los datos leídos recientemente; corresponde a la fase frozen y al prefijo partial-. Las lecturas fuera de la caché van a buscar los datos al repositorio.
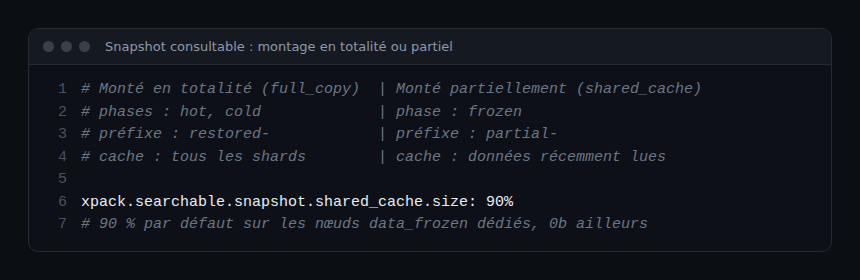
Dos consecuencias para la operación. La caché parcial se vacía al reiniciar un nodo; los datos de un montaje completo permanecen en disco. Y el ajuste xpack.searchable.snapshot.shared_cache.size vale el 90 % del disco en nodos data_frozen dedicados, 0b en el resto. Si un nodo cae, los shards se reconstruyen desde el repositorio: la salud del clúster puede seguir siendo distinta de green durante un tiempo, y las búsquedas pueden fallar o devolver resultados parciales.
Hacer copias de un clúster que contiene snapshots buscables
Estos son los pasos, según la sección «Backups» de la página de los snapshots buscables.
- Toma snapshots ordinarios del clúster, por ejemplo con SLM, como en cualquier otro clúster.
- Ten presente lo que contienen esos snapshots: para un índice buscable, solo metadatos que remiten al snapshot de origen, «ningún dato» del índice.
- Antes de una restauración, registra el repositorio de origen: la restauración falla para cualquier índice buscable cuyo snapshot de origen ya no esté disponible.
- No cuentes con un repositorio «source only»: no puede contener un snapshot de índice buscable.
La consecuencia es contraintuitiva: la copia de tus índices fríos depende de que sobreviva el repositorio que los sirve. Si ese repositorio se corrompe, Elastic advierte de que la pérdida de datos puede ser definitiva. Si hay un requisito de conservación, la protección del repositorio (copia, permisos de escritura, separación de clústeres) forma parte del diseño. Un clúster de terceros que pueda escribir en ese repositorio no debe borrar allí esos snapshots.
Evitar los montajes manuales bajo ILM
La documentación desaconseja montar a mano snapshots gestionados por ILM: puede interferir con él y causar pérdida de datos o problemas de gestión de los snapshots. Si quieres consultar puntualmente un dato antiguo, prefiere una restauración con otro nombre, con rename_replacement, en lugar de montar un snapshot que ILM controla.
Cómo comprobar que funciona
En un índice de prueba, monta un snapshot con storage=shared_cache y ejecuta GET /_cat/indices/partial-* para comprobar el prefijo. Después restaura el mismo snapshot con rename_replacement y compara el comportamiento. Ten en cuenta que esta comprobación depende de la versión de tu clúster: la página consultada no fija una versión concreta, así que relee la documentación correspondiente a la tuya.
Del lado de OpenTelemetry y Dynatrace
Para seguir el estado de un clúster Elasticsearch, el Collector de OpenTelemetry puede recolectar métricas; consulta https://span.observer/es/collector-de-opentelemetry-en-kubernetes-dynatrace/. No he encontrado, en las páginas leídas, ninguna integración de Dynatrace específica para los snapshots de Elasticsearch, y no afirmo ninguna. La diferencia entre vigilar un estado y entender una avería se aborda en https://span.observer/es/observabilidad-vs-monitorizacion-diferencia/, y la comparación de las plataformas en https://span.observer/es/dynatrace-vs-datadog-comparativa-sre/.
Preguntas frecuentes
¿Un snapshot buscable sustituye a una copia de seguridad?
No. Según la documentación de Elastic, el snapshot montado contiene la única copia completa de los datos del índice. Haz copias del clúster con snapshots ordinarios y protege el repositorio.
¿Cuál es la diferencia entre restaurar y montar?
Montar hace que el índice sea consultable desde el repositorio, con una caché; ILM suele hacerlo automáticamente. Restaurar un snapshot que contiene índices buscables los devuelve como índices buscables, siempre respaldados por el repositorio de origen.
¿Qué valor de storage elegir?
full_copy es el valor por defecto de la API de montaje y mantiene en caché todos los shards; shared_cache solo conserva los datos recientes y encaja con la fase frozen, según la documentación.
Conclusión
Quédate con una distinción: un snapshot ordinario hace copia de seguridad, un snapshot montado sirve de almacenamiento. Documenta, para cada índice, cuál de los dos tienes y mantén el repositorio de origen registrado y protegido.
Blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Los comportamientos descritos proceden de la documentación de Elastic consultada el 30 de octubre de 2026; compruébalos en la versión de tu clúster.