Tu política ILM anuncia la fase warm o cold y, sin embargo, el índice sigue en los nodos hot. En la mayoría de los casos, el culpable es el ajuste _tier_preference, que la acción migrate de ILM debería establecer. Este artículo explica el mecanismo de la tier preference ILM en Elasticsearch, las razones documentadas por las que no se aplica, y cómo diagnosticar y corregir el problema.
Para un equipo SRE, lo que está en juego es concreto: un índice que no baja de tier conserva almacenamiento caro y nodos calientes saturados, aunque la política parezca sana. El artículo vale tanto para Elasticsearch autoalojado como para Elastic Cloud; no se refiere ni a Dynatrace Managed ni a Dynatrace SaaS, pero el diagnóstico encaja en la monitorización de un clúster de Elasticsearch descrita en nuestra guía sobre la extensión de Dynatrace.
En breve
- ILM mueve un índice entre tiers con la acción
migrate, que escribeindex.routing.allocation.include._tier_preference. - Según la documentación de Elastic, esta acción se inyecta automáticamente en las fases warm y cold.
- Con
"migrate": { "enabled": false }, ILM ya no migra nada: te toca definir las reglas de asignación. - Los filtros de atributos heredados (
require.data,allocateconinclude,requireoexclude) pueden entrar en conflicto con la tier preference.
Tier preference ILM: qué hace realmente el ajuste
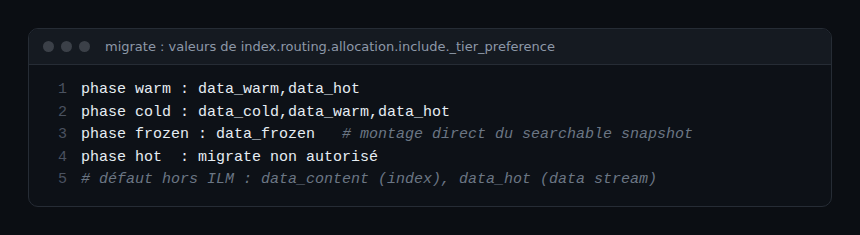
El ajuste index.routing.allocation.include._tier_preference indica a Elasticsearch en qué tier colocar los shards de un índice. Según la página «Data tiers» de Elastic, un índice ordinario recibe data_content por defecto, y un índice creado en un data stream recibe data_hot. El ajuste acepta una lista ordenada, separada por comas: Elasticsearch usa el primer tier que contiene nodos.
La página de la acción migrate precisa los valores que establece ILM: data_warm,data_hot en la fase warm y data_cold,data_warm,data_hot en la fase cold. El repliegue hacia los tiers más calientes evita que un índice quede sin asignar cuando el tier de destino no tiene nodos. En la fase frozen, ILM monta directamente el searchable snapshot con data_frozen; en la fase hot, migrate no está permitido.
Dos detalles útiles: poner el ajuste en null elimina la preferencia sin restaurar el valor por defecto, y el ajuste no desasigna un shard ya asignado. Para los costes del tier frozen, consulta nuestro artículo sobre el frozen tier.
Por qué ILM no migra tus índices
Causa 1: la acción migrate está desactivada
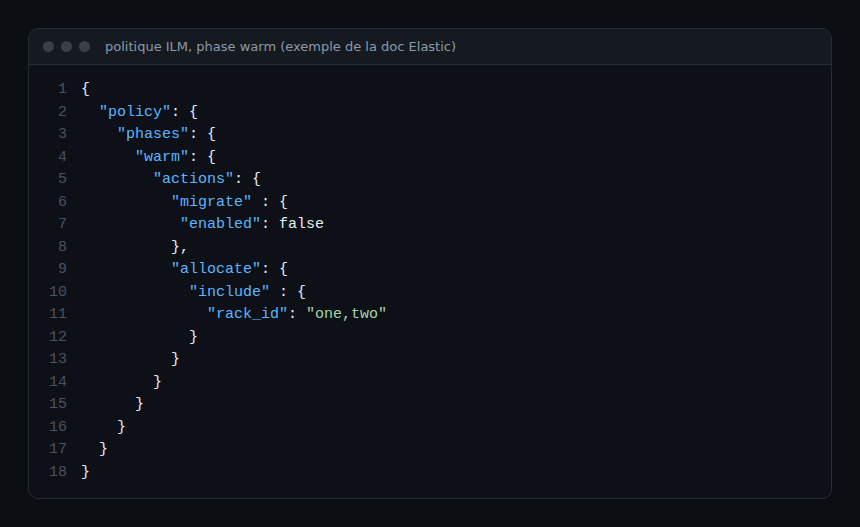
El parámetro enabled de migrate vale true por defecto. Ponerlo en false en una fase impide la migración automática. La documentación da este uso para los equipos que gestionan la asignación a mano con la acción allocate, y advierte: no desactives la migración automática sin definir manualmente reglas de asignación. De lo contrario, los datos pueden no llegar nunca al tier de destino, mientras la fase se muestra como completada.
Causa 2: filtros de atributos personalizados
La acción allocate acepta include (al menos un atributo de la lista), exclude (ninguno) y require (todos), basados en atributos de nodo como node.attr.box_type. Estos filtros pertenecen al antiguo modelo hot-warm-cold. La documentación de Elastic no describe con precisión cómo se combinan require o exclude con _tier_preference: la página de allocate no lo trata, y la página de migrate remite a ella. Este punto queda, por tanto, por probar en tu versión en lugar de darlo por supuesto.
Lo que sí está documentado es el caso de un índice que conserva un antiguo index.routing.allocation.require.data en conflicto con una tier preference obsoleta: hay que eliminar ese ajuste y corregir la preferencia. La documentación de migración también pide retirar los filtros de atributos de las plantillas (heredadas, componibles y componentes); de lo contrario, los índices nuevos los heredan.
Causa 3: ningún nodo tiene el rol adecuado
En autoalojamiento, los roles data_hot, data_warm, data_cold, data_frozen y data_content se declaran en elasticsearch.yml. En Elastic Cloud Hosted o ECE, se incluye por defecto un tier compartido hot y content que no se puede quitar; warm, cold y frozen se añaden en la interfaz. Sin nodos en el tier de destino, la lista de repliegue devuelve el índice a un tier más caliente, lo que parece una migración que falla.
Para la política de retención previa, consulta también nuestra guía de logsdb.
Diagnosticar paso a paso
- Lee el estado de ILM con
GET <index>/_ilm/explain: la respuesta da la política, la fase, la acción y el paso actuales. Se requieren los privilegiosmanage_ilmyview_index_metadata. - Lee los ajustes del índice y busca
index.routing.allocation.include._tier_preference, así como posiblesrequire.datau otros filtros de atributos. - Revisa la política: ¿fase warm o cold con
migrate.enabled: false? ¿Una acciónallocatecon filtros? - Consulta la asignación con
GET _cluster/allocation/explain(cuerpo:index,shard,primary). La respuesta lista, nodo por nodo, los deciders y su decisión (NO,YES,THROTTLE). - Comprueba los roles de los nodos en
elasticsearch.ymlo en la configuración del despliegue.
Corregir: pasar de atributos a data tiers
La documentación de Elastic describe un camino de migración de los filtros de atributos a los roles de nodo. Los pasos que conviene recordar: asignar los roles de tier a los nodos, limpiar las acciones allocate de las políticas (una acción allocate vacía no es válida, hay que eliminarla), retirar los filtros de las plantillas y, por último, actualizar los índices existentes (require.data a null y _tier_preference adaptado). Cada fase de cada tier de tu arquitectura debe existir, aunque esté vacía, para que ILM pueda inyectar migrate.
La API POST /_ilm/migrate_to_data_tiers automatiza tres de estos cuatro pasos. Acepta dry_run (simulación, falso por defecto), legacy_template_to_delete y node_attribute, y en su respuesta lista las políticas, índices y plantillas migrados. ILM debe estar detenido antes de la llamada.
POST /_ilm/stop
GET  /_ilm/status                          # attendre "operation_mode": "STOPPED"
POST /_ilm/migrate_to_data_tiers?dry_run=true
POST /_ilm/migrate_to_data_tiers
POST /_ilm/start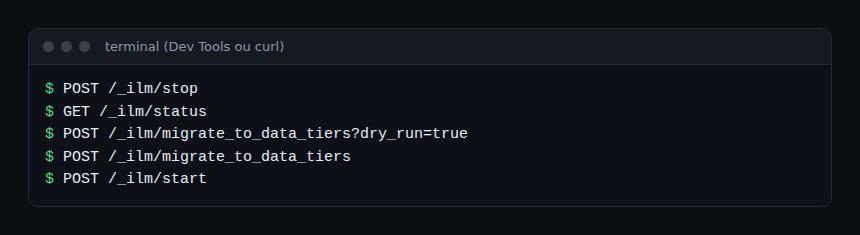
Lanza primero dry_run=true y revisa la lista de índices y políticas afectados. En Elastic Cloud, según la documentación, la migración se propone automáticamente al actualizar a la 7.10 o posterior, o al añadir un tier warm, cold o frozen; después hay que comprobar las plantillas personalizadas.
Cómo comprobar que funciona
Vuelve a ejecutar GET <index>/_ilm/explain y comprueba que el índice avanza por las fases. Revisa después el ajuste _tier_preference: debe corresponder a la fase (data_warm,data_hot en warm). Por último, verifica que los shards están en los nodos del tier esperado.
Relación con la observabilidad
Un índice atascado en el tier hot se ve primero en las métricas del clúster: espacio en disco y número de shards por nodo. Exponlas con el Collector de OpenTelemetry (guía de Elasticsearch y OpenTelemetry) y alerta sobre la saturación de los nodos hot en lugar de solo sobre el fallo de ILM, que puede aparecer como completado. Para el contexto, repasa la diferencia entre observabilidad y monitorización.
Buenas prácticas
- Deja
migrateactivo salvo necesidad concreta, y nunca sin reglas de asignación manuales. - Prefiere los roles de nodo a los atributos personalizados.
- Prueba toda migración con
dry_runantes de ejecutarla. - Alerta sobre la antigüedad de los índices por tier, no solo sobre el estado de las políticas.
Preguntas frecuentes
¿Qué es _tier_preference?
Es el ajuste de índice index.routing.allocation.include._tier_preference, una lista ordenada de tiers donde colocar los shards. ILM lo establece mediante la acción migrate.
¿Por qué mi fase warm está «complete» si nada se ha movido?
Con migrate.enabled: false y sin regla de asignación manual, la documentación indica que los datos pueden no llegar al tier de destino aunque la fase esté marcada como completada.
¿Hay que eliminar la acción allocate?
Si solo contiene filtros de atributos heredados, la documentación de migración recomienda retirarlos; una acción allocate vacía no es válida y debe eliminarse.
Conclusión
Cuando ILM no migra tus índices, empieza por migrate.enabled, y después revisa los filtros de atributos heredados y los roles de nodo. Las páginas oficiales citadas a continuación siguen siendo la referencia para tu versión.
Fuentes
- Data tiers, documentación de Elastic
- ILM migrate, documentación de Elastic
- ILM allocate, documentación de Elastic
- Migrate index allocation filters to node roles, documentación de Elastic
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Los nombres de productos pertenecen a sus propietarios; los ejemplos proceden de la documentación oficial o son ficticios, y conviene validarlos en tu versión.