Les métriques de trace Datadog donnent le débit, les erreurs et la latence d’un service sans que vous deviez garder toutes les traces. C’est la base d’un tableau de bord RED (Rate, Errors, Duration) et d’alertes fiables. D’après la documentation Datadog, elles sont « calculées sur 100 % du trafic de l’application », quelle que soit la configuration d’échantillonnage de l’ingestion des traces.
Cette promesse comporte des exceptions, surtout quand on mélange OpenTelemetry et échantillonnage. Ce guide décrit ce que la documentation dit, la liste des métriques, et les cas où le chiffre cesse d’être exact. Il s’adresse aux équipes SRE et plateforme qui veulent un SLI de latence ou d’erreurs qui ne dépend pas du taux de conservation des traces.
Périmètre : contenu Datadog, vérifié dans la documentation officielle consultée le 30 octobre 2026. Aucune mesure n’a été faite par span.observer.
Métriques de trace Datadog : ce que la documentation garantit
La page « Trace Metrics » explique que ces métriques sont des métriques APM produites à partir du trafic des applications instrumentées : nombre de requêtes, nombre d’erreurs, latence. Par défaut, c’est l’Agent Datadog qui les calcule à partir des traces que l’application lui envoie. Il faut donc activer la collecte de traces et instrumenter l’application d’abord. Elles servent ensuite dans les dashboards et les monitors.
Elles sont générées pour les spans d’entrée de service et certaines opérations, selon le langage de l’intégration. Le point clé : le calcul précède la décision de conserver ou non une trace. La page sur les mécanismes d’ingestion le confirme en parlant de métriques « fondées sur 100 % du trafic ». Elle rappelle aussi que l’échantillonnage en tête (head-based) décide à la racine, puis propage la décision : la trace est gardée ou rejetée en entier.
Pour un SRE, la conséquence est simple. Vous pouvez réduire le volume de traces conservées, donc la facture d’ingestion, sans fausser le taux d’erreurs d’un SLO. Les traces servent au diagnostic, les métriques au pilotage. Cette séparation rejoint la distinction entre observabilité et monitoring.
Les métriques disponibles pour un RED
Les noms suivent le modèle trace.<SPAN_NAME>.<SUFFIXE>. Voici la liste de la page « Trace Metrics Namespace ».
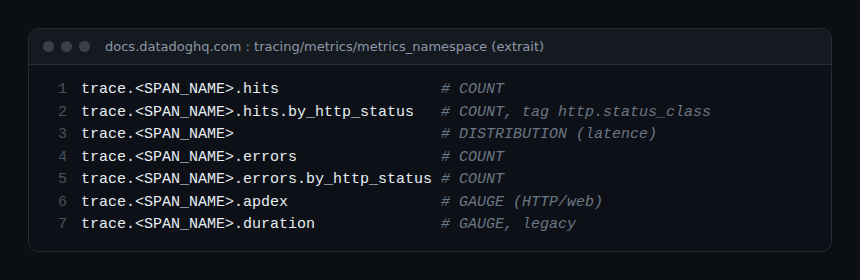
| Besoin RED | Métrique | Type (selon la doc) |
|---|---|---|
| Rate | trace.<SPAN_NAME>.hits |
COUNT |
| Errors | trace.<SPAN_NAME>.errors |
COUNT |
| Duration | trace.<SPAN_NAME> |
DISTRIBUTION |
| Détail HTTP | hits.by_http_status, errors.by_http_status |
COUNT |
| Score Apdex | trace.<SPAN_NAME>.apdex |
GAUGE (services HTTP ou web) |
Pour la latence, la documentation recommande la distribution, qui accepte les percentiles. Les métriques duration sont dites legacy, conservées pour la compatibilité, et n’acceptent pas les agrégations en percentiles. Les tags disponibles sont notamment env, service, version, resource, http.status_code et http.status_class. Les autres tags de span ne sont pas disponibles sur ces métriques : pour filtrer par un attribut métier, il faut une autre approche, par exemple des métriques basées sur les spans.
Construire un RED pas à pas
- Vérifier la collecte. L’application est instrumentée et envoie ses traces à l’Agent (ou au Collector, voir plus bas).
- Repérer le nom d’opération. Le
<SPAN_NAME>dépend de l’intégration. Cherchez-le dans le Metrics Summary plutôt que de le deviner. - Créer le Rate. Tracez
trace.<SPAN_NAME>.hitsgroupé parserviceetenv. - Créer les Errors. Divisez
errorsparhitspour obtenir un taux, base d’un SLI de disponibilité. - Créer la Duration. Utilisez la distribution pour les percentiles (p95, p99), pas les métriques
duration. - Brancher les monitors sur ces séries, pas sur le comptage de traces indexées.
Comment vérifier que ça fonctionne : réduisez temporairement la conservation des traces sur un environnement de test, puis comparez le hits avec le nombre de requêtes vu côté équilibreur de charge. Si l’écart est faible alors que l’ingestion baisse, le comportement documenté est bien là. Si l’écart est important, passez à la section suivante.
Quand les chiffres cessent d’être exacts
La même page liste des réserves à connaître avant de faire confiance à un RED.
- Échantillonnage côté application. Certains SDK (la documentation cite Ruby) peuvent échantillonner les spans avant l’Agent, ce qui rend les métriques inexactes. Elle précise que peu de SDK le permettent et que ce n’est généralement pas recommandé.
- SDK OpenTelemetry. Si le SDK échantillonne, les métriques de trace sont « échantillonnées et potentiellement inexactes ».
- AWS X-Ray. Les spans sont échantillonnés avant l’envoi à Datadog : les métriques peuvent ne pas refléter tout le trafic.
- Single span sampling. Les règles sur un span unique peuvent conserver des spans qu’un échantillonnage en tête aurait écartés, mais pas écarter des spans conservés.
Autrement dit, la garantie vaut tant que rien en amont de l’Agent ne supprime de spans.
Avec OpenTelemetry : calculer avant d’échantillonner
Si vous passez par un Collector OpenTelemetry, l’ordre des composants décide de l’exactitude. La documentation Datadog indique, pour calculer les métriques sur tout le trafic en échantillonnant dans le Collector, de placer le connector span_metrics avant les processeurs d’échantillonnage comme tail_sampling. Le README du Datadog connector (dépôt OpenTelemetry Collector contrib) dit la même chose pour son composant : il dérive des statistiques APM à partir des traces et doit être placé en amont, « pour que les métriques soient calculées avant l’échantillonnage ».
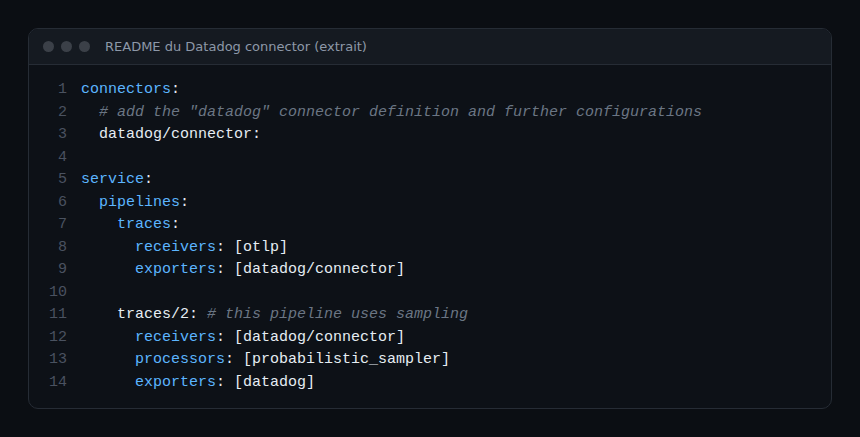
Dans cet extrait, le premier pipeline reçoit l’OTLP et alimente le connector. Le second, celui qui échantillonne, reçoit ensuite les traces du connector. Le connector voit donc le flux complet. Le même principe vaut pour toute chaîne OpenTelemetry : consultez notre guide sur le tail sampling avec OpenTelemetry et celui sur le Collector OpenTelemetry sur Kubernetes. Le raisonnement (calculer les métriques avant de jeter des traces) ne dépend pas de l’éditeur ; nous ne prétendons pas ici qu’un connector Datadog s’applique tel quel à Dynatrace.
Bonnes pratiques
- Basez vos SLO et vos alertes sur les métriques de trace, jamais sur le nombre de traces conservées.
- Gardez un seul endroit où l’échantillonnage se décide, et documentez-le.
- Utilisez la distribution de latence, pas les métriques
durationlegacy. - Dans un Collector, calculez les métriques avant tout processeur d’échantillonnage.
- Contrôlez régulièrement l’écart avec une source indépendante (équilibreur, passerelle).
Pour situer Datadog par rapport à d’autres plateformes, voir le comparatif Dynatrace et Datadog.
Questions fréquentes
Les métriques de trace Datadog sont-elles calculées sur toutes les requêtes ?
Selon la documentation Datadog, oui : elles reposent sur 100 % du trafic, indépendamment de l’échantillonnage de l’ingestion. Les exceptions sont l’échantillonnage côté SDK ou côté X-Ray, avant l’Agent.
Quelle métrique utiliser pour les percentiles de latence ?
La distribution trace.<SPAN_NAME>. Les métriques duration sont legacy et ne prennent pas en charge les percentiles.
Comment garder des métriques exactes avec un Collector OpenTelemetry ?
Placez le connector qui calcule les métriques (span_metrics ou le Datadog connector) avant les processeurs d’échantillonnage, comme l’indiquent la documentation Datadog et le README du connector.
Conclusion
Les métriques de trace Datadog permettent de séparer le pilotage (RED, SLO) du stockage des traces, à condition qu’aucun échantillonnage n’intervienne avant leur calcul. Vérifiez votre chaîne, de l’SDK à l’Agent ou au Collector, puis comparez avec une source indépendante. Références officielles : Trace Metrics, Metrics Namespace, Ingestion Mechanisms et Datadog connector.
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Datadog Inc. Datadog est une marque de son propriétaire. Les informations viennent de la documentation officielle consultée le 30 octobre 2026 : vérifiez-les pour votre version.