التجميع في DQL، أي ما يقابل group by، لا يحمل هذا الاسم: ففي لغة استعلام Dynatrace (Dynatrace Query Language) يتم التجميع بالأمر summarize ومعامله by:{}. إن كنت قادمًا من SQL فأنت تبحث عن الصيغة المألوفة SELECT … GROUP BY …؛ أما في DQL فتكتب دالة تجميع (aggregation) ثم قائمة مفاتيح التجميع، في أمر واحد موضوع في خط المعالجة (pipeline).
يعرض هذا الدليل الترجمة خطوة بخطوة: مفتاح واحد، وعدة مفاتيح، والأسماء المستعارة (alias)، والمجموعة null التي تظهر حين يغيب حقل، والتجميع بشريحة زمنية أو بشريحة قيم عبر bin()، ومعادل HAVING. كل صياغة مأخوذة من وثائق DQL الرسمية، التي اطُّلع عليها في أكتوبر 2026.
يصلح المحتوى لـ Dynatrace SaaS (منصة Grail). أما Dynatrace Managed فلا يملك Grail ولا DQL: يتم التجميع فيه بالمقاييس وData Explorer. وللنظرة العامة على الأوامر، راجع أوامر DQL مشروحة؛ ولاستعلامات جاهزة للنسخ، راجع استعلامات DQL التشغيلية لدينا.
التجميع في DQL: المقابل لـ SQL
الصياغة الموثقة للأمر هي التالية:
summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]ثلاثة فوارق مع SQL تهم يوميًا:
- لا SELECT منفصل: لا تحتوي النتيجة إلا مفاتيح
byودوال التجميع. وتختفي بقية الحقول. - الترتيب هو ترتيب خط المعالجة: يؤدي
filterالموضوع قبلsummarizeدورWHERE، والموضوع بعده دورHAVING. - الأقواس المعقوصة اختيارية لمفتاح واحد: تكتب صفحة مقارنة DQL/SQL في الوثائق
summarize count(), by:event.type.
وتقدّم الصفحة نفسها هذا المثال للتجميع:
fetch events
| filter event.type == "travel.funnel.booking-payment"
| summarize sum = sum(amount), by:travelAgency
وفي SQL كنا سنكتب SELECT sum(amount) AS sum FROM events WHERE … GROUP BY travelAgency.
خطوة بخطوة: التجميع بـ summarize
الخطوة 1: مفتاح واحد ودالة تجميع
عدّ السجلات (logs) بحسب مستوى الخطورة:
fetch logs
| summarize nb = count(), by:{loglevel}
يقابل كل سطر في النتيجة قيمة مميزة من loglevel. تشمل دوال التجميع الموثقة خصوصًا count وcountIf وcountDistinct وsum وavg وmin وmax وpercentile وtakeFirst.
الخطوة 2: سمِّ الأعمدة بأسماء مستعارة
يوضع الاسم المستعار أمام دالة التجميع وأمام المفتاح. وبدونه يحمل العمود نص التعبير، مثل sum(value)، وهذا غير عملي لبقية خط المعالجة.
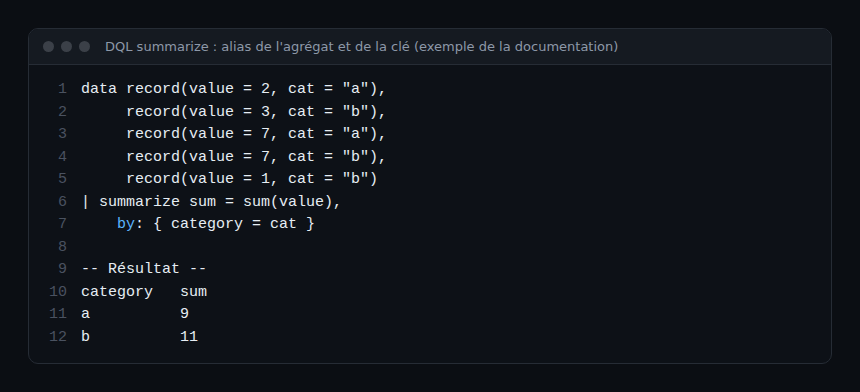
في هذا المثال المأخوذ من الوثائق تصبح دالة التجميع sum ويصبح المفتاح cat باسم category. تجعل الأسماء المستعارة الفرز والترشيح اللاحقين مقروءين: | sort sum desc بدل تكرار التعبير.
الخطوة 3: التجميع على عدة مفاتيح
اذكر المفاتيح بين أقواس معقوصة تفصلها فواصل. هكذا تعدّ الوثائق مستويات السجل بحسب المضيف ومجموعة العمليات:
fetch logs
| summarize {
      errors = countIf(loglevel == "ERROR"),
      warnings = countIf(loglevel == "WARN")
    },
    by: {
      dt.entity.host,
      dt.entity.process_group
    }
لاحظ الأقواس المعقوصة حول دوال التجميع: فهي تجمع عدة دوال تجميع مسمّاة. تحل countIf محل SUM(CASE WHEN … THEN 1 ELSE 0 END) الكلاسيكية في SQL، وتنتج عدة عدّادات في مرور واحد.
الخطوة 4: افهم المجموعة null
إذا لم يكن حقل التجميع موجودًا في كل السجلات، يضيف summarize مجموعة null إلى النتيجة. هذا أشيع الفخاخ: مجموع يبدو صحيحًا، لكن سطر null يحتوي جزءًا من البيانات.
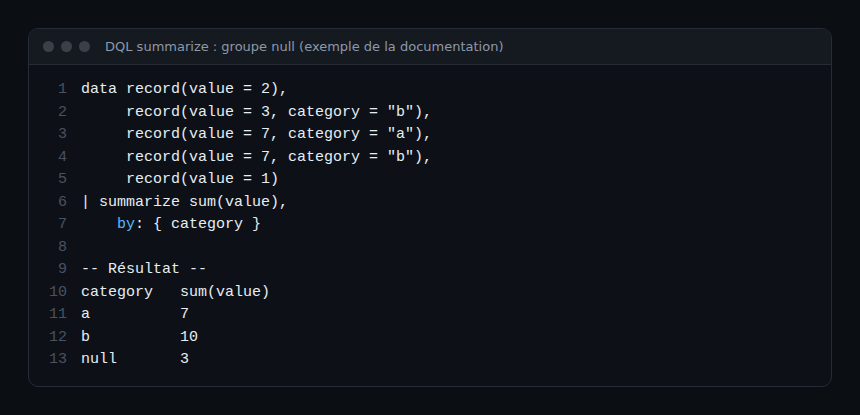
جوابان ممكنان بحسب الحاجة:
// exclude records without a key
fetch logs
| filter isNotNull(k8s.namespace.name)
| summarize nb = count(), by:{k8s.namespace.name}

// or keep the null row and investigate it
fetch logs
| summarize nb = count(), by:{k8s.namespace.name}
| sort nb desc
في التشغيل كثيرًا ما يكشف سطر null عيبًا في الإثراء: سجلات تصل بلا بيانات Kubernetes الوصفية، مثلًا. واستبعاده دون النظر فيه يخفي المشكلة.
الخطوة 5: التجميع بالشرائح عبر bin()
تقرّب الدالة bin(expression, interval) القيمة للأسفل إلى مضاعف الفاصل. تشير الوثائق إلى أنها تُستخدم غالبًا مع summarize وby. وهي تقبل رقمًا أو مدة أو ختمًا زمنيًا:
fetch logs
| summarize nb = count(), by:{minute = bin(timestamp, 1m), loglevel}
| sort minute asc
بالنسبة إلى قيمة رقمية، يضع bin(x, 10) العدد 27 في الشريحة 20؛ ويزيح المعامل الاختياري at: الشرائح (bin(x, 10, at:5) يضع 27 في الشريحة 25). إنه المعادل في DQL لمدرّج تكراري (histogram) GROUP BY FLOOR(x / 10) * 10.
وللسلاسل الزمنية الموجهة إلى رسم بياني، ينتج الأمر makeTimeseries بمعامل by خاص به سلاسل متجانسة بفواصل منتظمة. ويبقى summarize مع bin() أبسط لجدول.
الخطوة 6: معادل HAVING
أضف filter بعد summarize:
fetch logs
| filter loglevel == "ERROR"
| summarize erreurs = count(), by:{dt.entity.host}
| filter erreurs > 100
| sort erreurs desc
| limit 10
يقلّص الـ filter الأول البيانات المقروءة (أي WHERE)، ويُبقي الثاني المجموعات التي تتجاوز العتبة (أي HAVING). ويقبل الأمر sort القيمتين asc أو desc لكل حقل.
كيف تتحقق من صحة التجميع
- راقب المجموع: نفّذ الاستعلام نفسه بدون
by. يجب أن يساوي مجموع المجموعات الإجمالي، بما فيها المجموعةnull. - ابحث عن سطر null: يُظهر
| filter isNull(ma_cle)بعدsummarizeفورًا هل هو موجود. - تحقق من الحالة الفارغة: بدون
byوبدون أي سجل في المدخل، يعيدsummarizeسطرًا واحدًا مع ذلك (count()بقيمة 0 وبقية دوال التجميع بقيمةnull). يجب أن تعرض لوحة المعلومات هذه الحالة بشكل صحيح، وكذلك الجدول الفارغ لاستعلام بـbyحين لا تبرز أي مجموعة.
أفضل الممارسات
- رشّح قبل التجميع: بيانات مقروءة أقل، واستعلام أسرع وأقل كلفة.
- سمِّ دوال التجميع والمفاتيح دائمًا: يبقى الاستعلام مقروءًا بعد ستة أشهر، أثناء مناوبة.
- تجنب التجميع على حقل عالي الكثافة (cardinality)، مثل معرّف طلب أو محتوى سجل كامل. تحدّ الوثائق الحجم المجمّع لمفاتيح التجميع بـ 128 كيلوبايت لكل سجل وتنصح بالاقتطاع، مثل
substring(content, 0, 100). - أبقِ سطر
nullظاهرًا في استعلامات التشخيص؛ ولا ترشّحه إلا في العروض الموجهة إلى المستخدمين. - بالنسبة إلى SLI، جمّع بحسب الخدمة والحالة، ثم احسب النسبة في مرحلة
fieldsAdd: راجع مسار مقاييس Dynatrace SaaS.
الأسئلة الشائعة
هل يوجد أمر group by في DQL؟
لا. يتم التجميع عبر summarize … by:{}. وللحصول على القيم المميزة فقط، مثل SELECT DISTINCT، تعرض الوثائق summarize count(), by:event.type متبوعًا بـ fields event.type؛ والأمر dedup خيار آخر.
لماذا تحتوي نتيجتي على سطر null؟
لأن سجلًا واحدًا على الأقل لا يحمل حقل التجميع. يضعه summarize في مجموعة null بدل تجاهله. رشّح بـ isNotNull() قبل التجميع إن كانت هذه السجلات لا تهمك.
ما الفرق عن مقال استعلامات DQL النموذجية؟
يركّز هذا الدليل على التجميع وفخاخه. أما استعلامات DQL النموذجية فتغطي حالات تشغيل كاملة، وتفيد دالة in() في DQL في الترشيح على قائمة قبل التجميع.
الخلاصة
يتلخص التجميع في DQL في عادة واحدة: اكتب دالة التجميع ثم by:{} في summarize نفسه. تسمية الأعمدة، ومراقبة المجموعة null، والتقسيم بـ bin()، والترشيح بعد التجميع لمعادل HAVING، كل ذلك يكفي لتغطية معظم الاستعلامات التشغيلية. وللمزيد حول الطوبولوجيا، راجع DQL وSmartscape.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. العلامات التجارية المذكورة ملك لأصحابها. صياغة DQL تتطور: تحقق منها في الوثائق الرسمية قبل استخدامها في الإنتاج.