صباح الأحد بعد إصدار ليلة الخميس: ربط فريق المنصة مساعدًا داخليًا بنموذج لغوي كبير (LLM)، والـ spans تصل إلى Dynatrace، ومع ذلك تبقى شاشة AI Observability فارغة. مع OpenInference في Dynatrace لتتبع الذكاء الاصطناعي يكون السبب عادةً بسيطًا: الطرفان لا يتكلمان لهجة السمات نفسها. فالأداة المُجهِّزة تكتب llm.model_name، بينما تبحث Dynatrace عن gen_ai.request.model.
ينطلق هذا الدرس من هذه المشكلة التشغيلية ليجيب عن سؤالين: أين نُجري الترجمة، وكيف نثبت أنها تعمل. اعتمدتُ على صفحة Get started with OpenInference and AI Observability (قُرئت في 8 نوفمبر 2026)، وعلى مواصفة OpenInference من Arize، وعلى مقالة من المجتمع. النطاق هو Dynatrace SaaS فقط، فلا شيء مذكور عن Managed.
اعتراف قبل المتابعة: لم أشغّل هذه السلسلة على أي بيئة. وكل ما هو تركيب من عندي موسوم بعبارة «من عندنا» أو «لم يُنفَّذ».
OpenInference في Dynatrace لتتبع الذكاء الاصطناعي: لماذا تبقى الـ spans صامتة؟
يصف OpenInference تطبيق الذكاء الاصطناعي على أنه سلسلة من الـ spans المصنّفة بنوع: قيمة openinference.span.kind قد تكون LLM أو EMBEDDING أو AGENT أو TOOL أو RETRIEVER أو GUARDRAIL. وهي spans كاملة الأهلية في OpenTelemetry، أي تتبعات (traces) لا مقاييس. الفرق الوحيد هو مفردات السمات مقارنةً باصطلاح gen_ai.*.
والنتيجة عمليًا لمن يتولى المناوبة: من دون النموذج وعدّادات الرموز (tokens) في مكانها لا يمكن تتبع التكلفة ولا زمن الاستجابة لكل نموذج، ولا ربط أي انحراف بهدف مستوى الخدمة (SLO). التتبع موجود، لكنه لا يقول شيئًا مفيدًا.
ثلاثة أماكن ممكنة للترجمة
قبل أن تلمس أي ملف، قرّر أين ستقيم الترجمة. أرى ثلاثة خيارات.
- داخل المُجهِّز (instrumentor). بعض المُجهِّزات تُصدر عائلتَي السمات معًا إذا فعّلتَ
OPENINFERENCE_ENABLE_GENAI_SEMCONV=true. وتذكر الوثائق OpenAI وCohere. هذا أبسط الحلول، لكن التغطية تختلف من حزمة إلى أخرى. - داخل Collector. يحوّل المعالج
genainormalizerالسمات قبل الإرسال. إعداد واحد يخدم كل التطبيقات، ولا يحتاج أي منها إلى رمز Dynatrace. - داخل Dynatrace. ممكن نظريًا، لكنك تفقد السيطرة على ما يغادر شبكتك، بما فيه الأوامر (prompts).
خياري الافتراضي هو Collector: فهو يجمع الرمز في مكان واحد، ويتيح إخفاء المحتوى قبل الخروج، ويسدّ ثغرات المُجهِّزات. وهذا ما أفصّله فيما يلي.
ما الذي تحتاجه قبل البدء
- بيئة SaaS بترخيص Dynatrace Platform Subscription (DPS)، مع تفعيل Traces powered by Grail والإدخال عبر OTLP.
- رمز: إما platform token بالنطاق
openpipeline:traces:ingest، وإما Classic access token بالنطاق «Ingest OpenTelemetry traces» (openTelemetryTrace.ingest). - Docker، وCollector يضم
genainormalizer: الإصدار 0.53.1 أو أحدث من Dynatrace Collector، أو الإصدار 1.1.2 أو أحدث من Dynatrace Bindplane OTel Collector. - تطبيق Python وحزمة OpenInference الخاصة بمزوّده، مثل
openinference-instrumentation-openai.
يكفي متغيران: DT_ENDPOINT (العنوان الأساسي، مثل https://<id-environnement>.live.dynatrace.com، من دون /api/v2/otlp) وDT_API_TOKEN. أما ملف .env الذي يحملهما فلا يجوز أن يدخل Git أبدًا.
ملف Collector كتلةً كتلة
تصف الوثائق السلوك المتوقع لكنها لا تنشر ملف YAML كاملًا. لذلك فالملف أدناه هو تركيب من عندنا: المستقبِل والمُصدِّر مأخوذان من الأمثلة الرسمية، وكتلة التحويل من مقالة المجتمع (نسخة OpenTelemetry Collector الأصلية 0.153.0 أو أحدث). تحقق من الاسم الدقيق للمكوّن في قائمة التوزيعة التي تستخدمها.
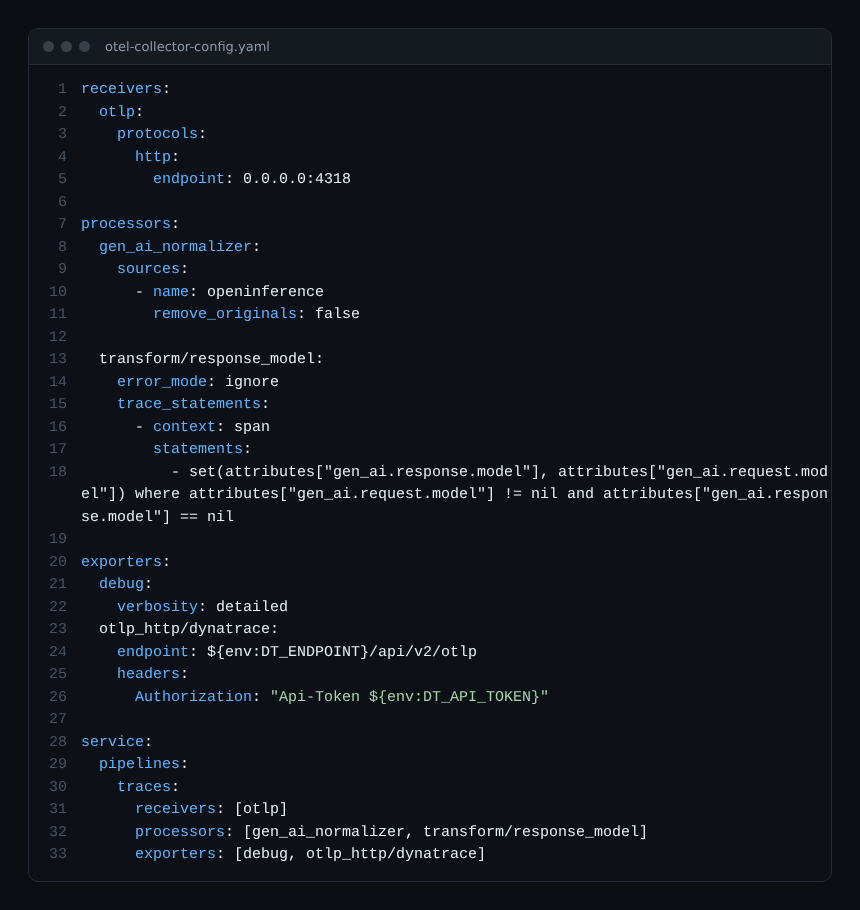
ثلاث نقاط تستحق الشرح.
remove_originals: false. في البداية احتفظ بمجموعتَي السمات على الـ span نفسه، فتصبح المقارنة قبل التحويل وبعده فورية. أما الوثائق فتضعه علىtrueلإبقاءgen_ai.*وحدها.transform/response_model. لا يعرف OpenInference «نموذج الاستجابة». فيقوم المعالج بنسخ النموذج المطلوب إلىgen_ai.response.model، وتعليمة OTTL المكتوبة هنا من صنعي.- خطوط التتبعات وحدها. فبحسب مقالة المجتمع، ربط هذا المعالج بالمقاييس أو السجلات يمنع الـ Collector من الإقلاع.
أول تجربة: حاوية وجملة واحدة إلى النموذج
نشغّل الـ Collector ثم نطلق تطبيقًا صغيرًا. الأوامر مأخوذة من الوثائق مع اختصار، والصورة هي ghcr.io/dynatrace/dynatrace-otel-collector/dynatrace-otel-collector:0.53.1.
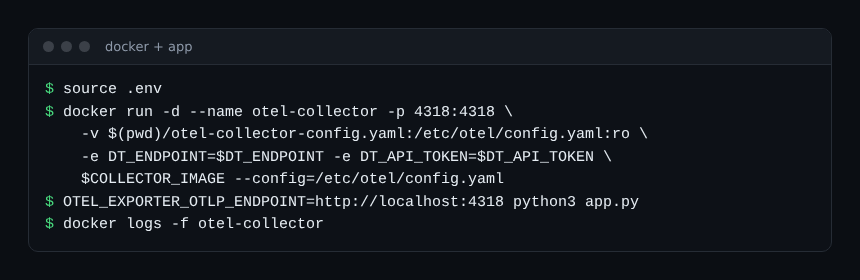
ينشئ سكربت الوثائق TracerProvider ومُصدِّر OTLP/HTTP ومُجهِّز OpenAI، ثم يطلب من النموذج هايكو عن قابلية الملاحظة. وفي صيغتي، التي لم أعد التحقق منها: اترك المُصدِّر بلا وسائط ليقرأ OTEL_EXPORTER_OTLP_ENDPOINT كما يقتضي الـ SDK. عندئذٍ لا يعرف التطبيق سوى localhost:4318.
exporter = OTLPSpanExporter()  # lit OTEL_EXPORTER_OTLP_ENDPOINT
tracer_provider.add_span_processor(BatchSpanProcessor(exporter))
OpenAIInstrumentor().instrument(tracer_provider=tracer_provider)
فخ يتعلق بالخصوصية: المُجهِّزات المبنية على TraceConfig في Python تلتقط الأوامر والردود افتراضيًا. ولتعطيل ذلك اضبط على true كلًّا من OPENINFERENCE_HIDE_INPUTS وOPENINFERENCE_HIDE_OUTPUTS وOPENINFERENCE_HIDE_INPUT_MESSAGES وOPENINFERENCE_HIDE_OUTPUT_MESSAGES.
ما الذي يستطيع المعالج تحويله فعلًا
جدول المطابقة في الوثائق يتجاوز عشرة أسطر. وخلاصته: نوع الـ span يصبح gen_ai.operation.name (chat وembeddings وinvoke_agent وexecute_tool)، واسم النموذج يصبح gen_ai.request.model، وعدّادات الرموز تنضم إلى gen_ai.usage.*.
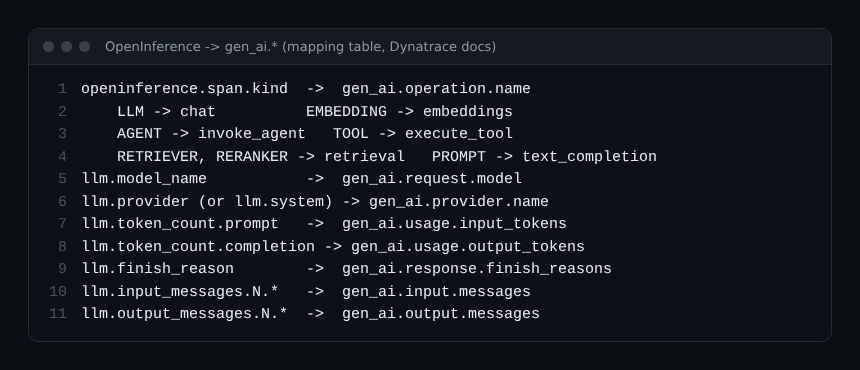
تُجمع الرسائل المرقّمة (llm.input_messages.N.*) في سجل JSON واحد داخل gen_ai.input.messages، بشرط أن يصدر المُجهِّز ما يكفي منها.
ثلاثة فحوص لتصدّق ما تراه
- على جانب Collector. نفّذ
docker logs -f otel-collectorمع المُصدِّرdebugبمستوى التفصيلdetailed، وابحث عنgen_ai.request.modelعلى كل span. - على جانب الواجهة. اضغط Ctrl+K، واختر «AI Observability»، ثم تبويب Explorer: يجب أن يظهر النموذج والرموز والمحتوى. والاستعلام نفسه موجود في Distributed Traces.
- بلغة DQL. لا تقدم الوثائق مثالًا خاصًا بـ OpenInference. الاستعلام الأول مأخوذ من درس RAG عندها، والثاني من عندي ولم يُنفَّذ.
fetch spans
| summarize models = collectDistinct(gen_ai.request.model)
| expand models
| sort models

fetch spans
| filter isNotNull(gen_ai.request.model)
| summarize input = sum(gen_ai.usage.input_tokens),
            output = sum(gen_ai.usage.output_tokens),
            by: { gen_ai.request.model }
لا يظهر شيء على الشاشة؟ انظر أولًا إلى العنوان: فالـ Collector يضيف بنفسه /api/v2/otlp إلى DT_ENDPOINT.
النقاط العمياء التي يجب معرفتها
- التحويل لا يعيد بناء ما لم يُصدره المُجهِّز أصلًا.
- درجة الحرارة و
top_pوmax_tokensوأسباب الإنهاء وذاكرة الأوامر المؤقتة وgen_ai.systemتتطلب تحويلاتtransformمن كتابتك؛ أما المعالج فيملأgen_ai.provider.name. - ليس لـ spans من نوع GUARDRAIL مجموعة سمات قياسية غنية: تُمرَّر القيمة كما هي إلى
gen_ai.operation.name. - بالنسبة إلى Managed لا توجد أي معلومة موثّقة.
أفضل الممارسات
- أبقِ Collector مركزيًا واحدًا: يعيش الرمز في مكان واحد ويمكن تجديده من دون المساس بالتطبيقات.
- اقصر الرمز على إدخال التتبعات.
- احسم أمر المحتوى قبل الإنتاج، فقد يحتوي الأمر (prompt) على بيانات شخصية.
- بعد التحقق، اضبط
remove_originalsعلىtrueلتفادي السمات المكررة. - ثم اربط زمن الاستجابة والرموز لكل نموذج بأهدافك، كما في مقالة موثوقية أحمال الذكاء الاصطناعي.
للتوسع: السياق في Dynatrace وArize، ثم وكلاء MCP ومراقبة وكيل برمجة في المؤسسة وOpenTelemetry من الطرف إلى الطرف. وللسمات نفسها: مواصفة OpenInference ومقالة المجتمع GenAI Normalizer.
الأسئلة الشائعة
هل يبقى Collector مفيدًا إذا كان المُجهِّز يصدر gen_ai.* أصلًا؟
غالبًا نعم. فالخيار OPENINFERENCE_ENABLE_GENAI_SEMCONV=true يضيف سمات gen_ai.* لكن التغطية تتفاوت. ويعمل Collector هنا شبكةَ أمان للسمات الناقصة ونقطةً وحيدة لإخفاء المحتوى.
أي رمز وبأي نطاقات؟
platform token بالنطاق openpipeline:traces:ingest، أو Classic access token بالنطاق openTelemetryTrace.ingest. في سكربتات الوثائق تكون الترويسة Bearer للأول وApi-Token للثاني. ملف YAML عندنا يستعمل Api-Token، فإذا كان لديك platform token فغيّر الترويسة.
وماذا عن Dynatrace Managed؟
الصفحة التي قرأتها تخص SaaS (DPS وGrail). لا أستطيع الجزم بشيء بخصوص Managed.
الخلاصة
مع OpenInference في Dynatrace لتتبع الذكاء الاصطناعي احتفظ بقرار واحد وعادة واحدة. القرار: الترجمة داخل Collector مركزي. والعادة: التحقق أولًا مع remove_originals: false والمحتوى المخفي، ثم قراءة الـ spans في سجلات الـ Collector قبل البحث عنها في AI Observability.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Arize. العلامات المذكورة تعود إلى مالكيها. الأدوات تتطور بسرعة: تحقق دائمًا من الأوامر والخيارات في الوثائق الرسمية.